2.3 Crew (团队)
2.3 Crew (团队)
本节约处在第二章第三站。组件拆到 Crew,算是把零件装成了可以启动的整机。Crew 本身不干活,它干三件事:收拢成员、声明协作方式、提供运行开关。理解它"是容器不是执行者",才不会把本该写在 Agent/Task 上的逻辑误塞进来。
Crew 在运行时扮演的角色,可
Crew 在运行时扮演的角色,可以画成一台调度机:
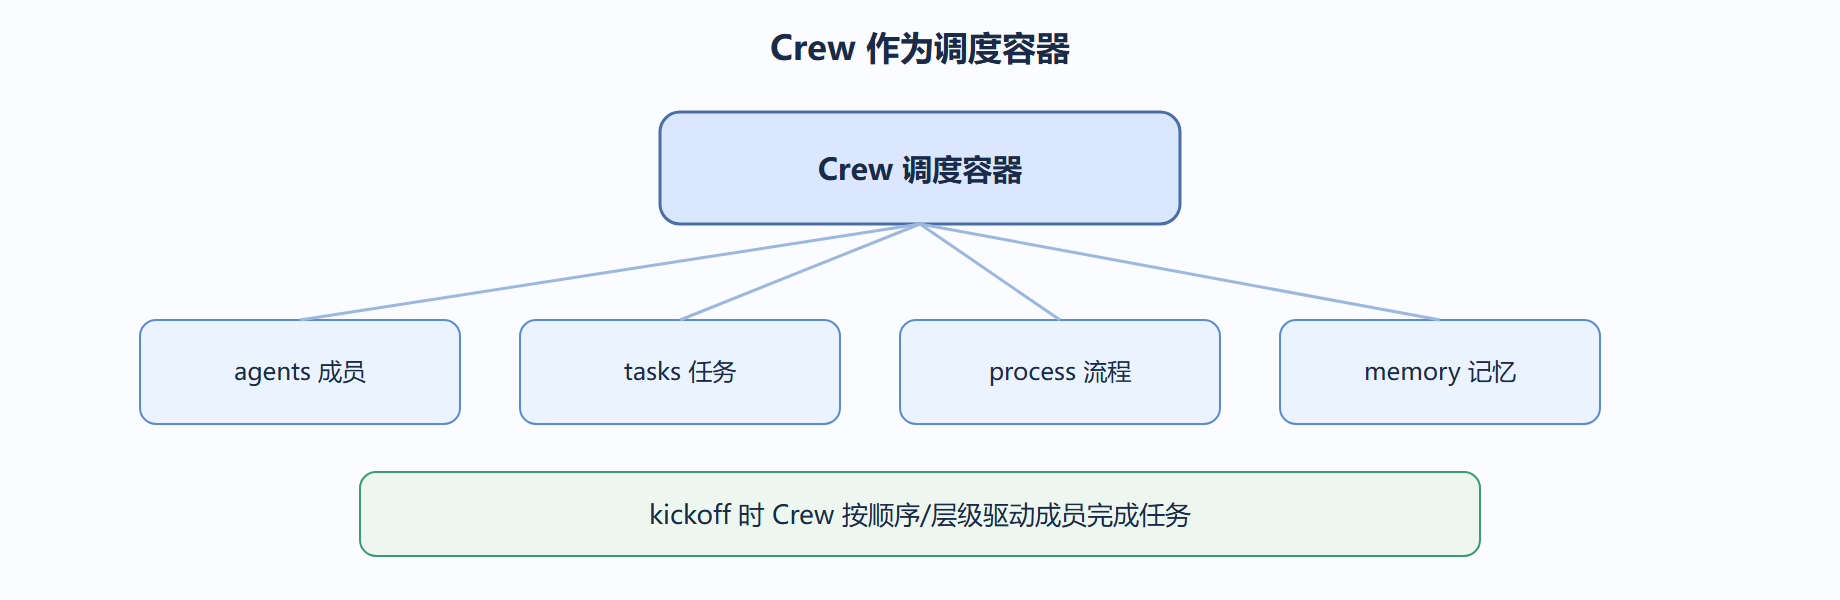
Crew 的关键构造参数:
- agents:成员列表,至少
agents:成员列表,至少一人才有意义。tasks:任务列表,顺序在 sequential 模式下就是执行顺序。process:协作策略,Process.sequential 或 Process.hierarchical。verbose:是否打印整队运行日志。memory:是否开启跨任务记忆(第四章详述)。cache:是否缓存任务结果,相同输入直接复用,省 token。max_rpm:每分钟最大请求数,用来给模型接口限流,避免触发配额。manager_llm:层级模式下"经理"角色用的模型。
最小化一个 Crew 已经在第一章见过,这里强调 cache 与 max_rpm 这两个工程开关怎么用:
from crewai import Agent, Task, Crew, Process researcher = Agent(role="研究员", goal="找事实", backstory="简洁", verbose=True) t = Task(description="搜 {topic} 要点", expected_output="三条要点", agent=researcher) crew = Crew( agents=[researcher], tasks=[t], process=Process.sequential, verbose=True, cache=True, # 相同 topic 第二次直接命中缓存 max_rpm=30, # 限流,保护模型配额 )
cache=True 在多轮调试同一输入时非常省:你改措辞、它不重算已经跑过的任务。但上生产前要确认缓存不会引起"陈旧结果被复用"——比如任务依赖实时数据时就该关掉。max_rpm 则是对付"任务一多就把接口打爆"的保险丝。
层级模式需要额外指定经理模型,因为框架会隐式创建一个协调角色来派活:
from crewai import LLM, Agent, Task, Crew, Process manager = LLM(model="openai/gpt-4o", temperature=0.3) researcher = Agent(role="研究员", goal="找事实", backstory="简洁", verbose=True) writer = Agent(role="写手", goal="成文", backstory="连贯", verbose=True) tasks = [ Task(description="搜 {topic} 新闻", expected_output="要点", agent=researcher), Task(description="写成短评", expected_output="短评", agent=writer), ] crew = Crew( agents=[researcher, writer], tasks=tasks, process=Process.hierarchical, # 经理决定调用顺序 manager_llm=manager, # 必须给经理配模型 verbose=True, )
注意层级模式下,即使你给 Task 写了 agent,经理也可能重新分派——也就是说 context 与显式 agent 的约束力被削弱,换来灵活。我们用它的前提是:任务间依赖真的在运行时才知道,否则顺序模式更省钱更好调。
还有一个接口层面的选择:Crew 支持用 crew.kickoff(inputs=...) 同步启动,也支持 crew.kickoff_async(...) 异步启动。批量跑多个独立主题时,异步能压住总耗时:
import asyncio from crewai import Crew # 假设 crew 已组装好 async def run_many(topics): tasks = [crew.kickoff_async(inputs={"topic": t}) for t in topics] return await asyncio.gather(*tasks) # asyncio.run(run_many(["储能", "低空经济", "AI 制药"]))
收尾给一条判断:Crew 的构造
收尾给一条判断:Crew 的构造参数里,agents 和 tasks 决定"谁和什么",process 决定"怎么动",cache/max_rpm/memory 决定"跑得稳不稳、省不省"。不要把业务逻辑写进 Crew 本身——它只负责编排,不负责思考。思考在 Agent,执行契约在 Task。
Crew 的组装与启动参数
Crew 是"容器",把 agents 与 tasks 装进来,再决定 process、是否开 memory、用什么 embedder。它本身不干活,只负责组织和 kickoff。下面是生产里我们常用的组装方式:
| 参数 | 作用 | 建议 |
|---|---|---|
| agents | 成员列表 | 去重,避免同一人格出现两次 |
| tasks | 任务列表 | 顺序即默认执行序(sequential) |
| process | 协作方式 | sequential / hierarchical |
| memory | 全局记忆 | 需要跨任务记上下文开 True |
| verbose | 日志 | 开发 True,生产 False |
| full_output | 返回完整轨迹 | 调试时 True |
⚠️ 常见坑:tasks 列表里的顺序在 sequential 下就是执行顺序,别把有依赖的任务排反。若用 context 显式声明依赖,CrewAI 会按依赖拓扑重排,但显式顺序仍是兜底。另一个坑是 memory=True 却没配 embedder,会报嵌入模型缺失。
from crewai import Agent, Task, Crew, Process planner = Agent(role="策划", goal="定题", backstory="敏感", verbose=True) writer = Agent(role="写手", goal="写稿", backstory="清楚", verbose=True) t1 = Task(description="定题", expected_output="一个题目", agent=planner) t2 = Task(description="写稿", expected_output="初稿", agent=writer, context=[t1]) crew = Crew( agents=[planner, writer], tasks=[t1, t2], process=Process.sequential, memory=False, verbose=True, ) result = crew.kickoff() print(type(result), str(result)[:80])
💡 关键直觉:Crew 像一支项目组,项目经理(Process)决定怎么派活,组员(Agent)带着工具(Tools)去完成分配给自己的工单(Task)。组员之间不直接对话,所有交接都通过 Task 的 context 流转——这让每一步的输入输出都显式、可审计。
# hierarchical 下 Crew 会自己造一个经理来派活 crew_h = Crew(agents=[planner, writer], tasks=[t1, t2], process=Process.hierarchical, manager_llm="gpt-4o-mini")