2.4 Process (协作流程)
2.4 Process (协作流程)
本节约处在第二章第四站,也是本章的拐点。前面 Agent、Task、Crew 都是"零件与容器",Process 决定这些零件怎么动起来。CrewAI 把协作策略抽象成可切换的 Process,这是它和"对话自协商"类框架最不同的地方——你选策略,框架按策略跑。
两种模式的根本差异,看一张执行时
两种模式的根本差异,看一张执行时序图最直观:
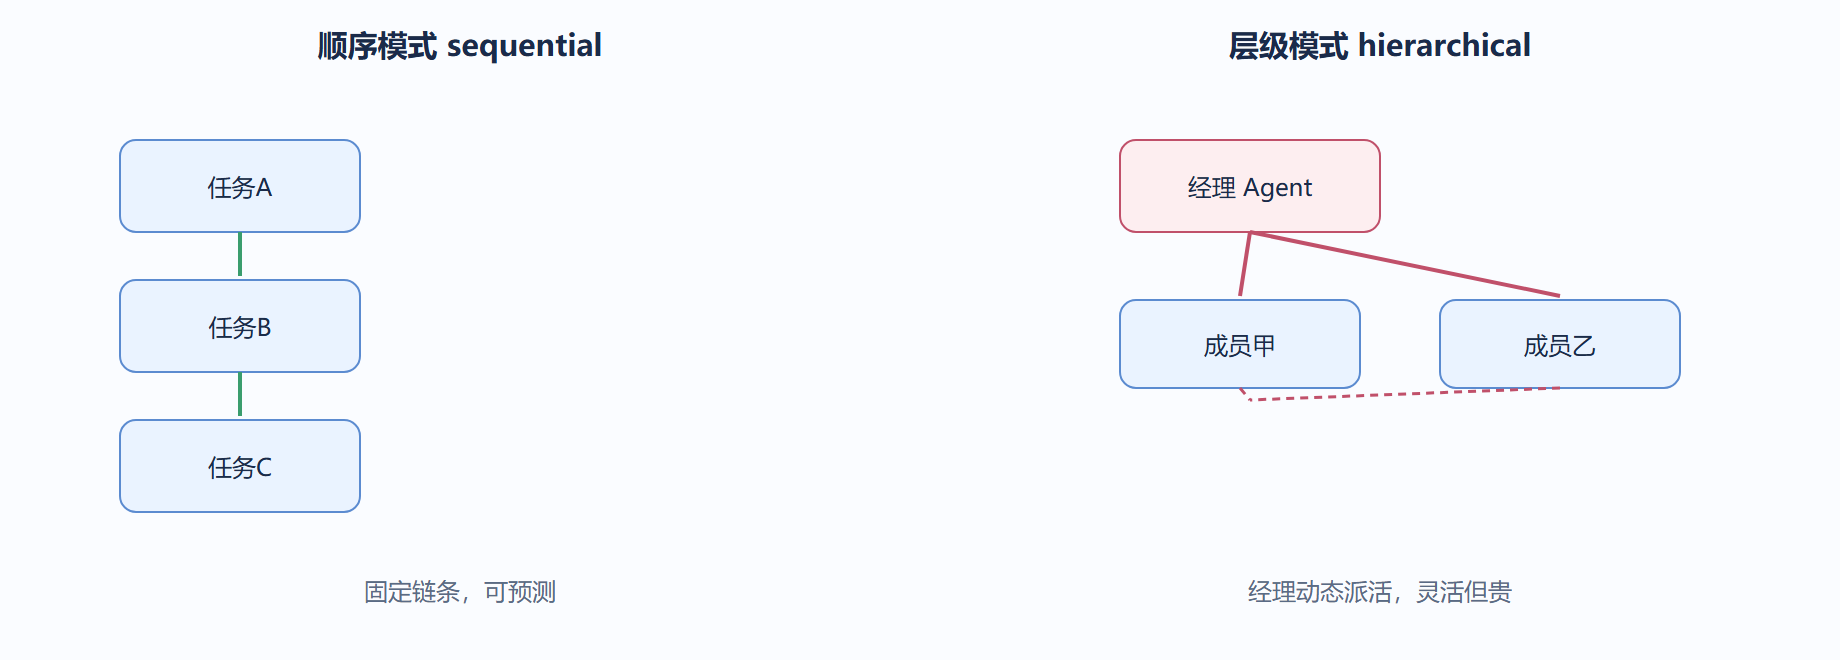
顺序模式(Process.sequential):任务按列表顺序逐个执行,前一个的产出通过 context 传给后一个。它的好处是确定性高——同样的输入、同样的代码,跑出来的路径一致,便于回放和单测。代价是面对"要先看结果才能决定下一步"的任务时不够灵活。
层级模式(Process.hie
层级模式(Process.hierarchical):框架隐式创建一个"经理"角色,由它读任务列表、动态决定先调谁、要不要重派。好处是能处理依赖在运行时才明确的场景;代价是多了一次模型调度(经理本身),且因为派活动态,同一输入多次跑路径可能不同,调试更难、账单更厚。
下面用同一组任务演示两种模式的写法差异,重点看层级模式必须配 manager_llm:
from crewai import LLM, Agent, Task, Crew, Process m = LLM(model="openai/gpt-4o", temperature=0.2) researcher = Agent(role="研究员", goal="找事实", backstory="简洁", verbose=True) writer = Agent(role="写手", goal="成文", backstory="连贯", verbose=True) tasks = [ Task(description="搜 {topic} 要点", expected_output="三条要点", agent=researcher), Task(description="写成短评", expected_output="短评", agent=writer), ] # 顺序:路径完全由列表顺序决定 crew_seq = Crew(agents=[researcher, writer], tasks=tasks, process=Process.sequential, verbose=True) # 层级:经理动态派活,必须给经理模型 crew_hier = Crew(agents=[researcher, writer], tasks=tasks, process=Process.hierarchical, manager_llm=m, verbose=True)
选型的因果链我们总结成三句:依赖固定且要可回放,用顺序;依赖运行时才清楚且能接受成本,用层级;两者都不确定但任务简单,先别上多智能体。
还有一个被忽视的点:顺序模式下 tasks 列表的顺序就是执行序,但 context 才是数据通路。列表顺序和数据依赖可以不完全一致——比如你可以让任务B在列表里排第三,却 context=[任务A]。我们建议让两者保持一致,降低阅读成本;只有在需要"先并行做几件无关的事、再汇总"时才打破。
关于 async_execution:当一个 Task 不依赖任何前序产出,可以标 async_execution=True,让它在前序空档里并行跑,缩短总时长。这是顺序模式里唯一的"并行口子":
# 两个互不依赖的任务并行跑 t_a = Task(description="搜新闻", expected_output="要点", agent=researcher, async_execution=True) t_b = Task(description="查数据", expected_output="数字", agent=researcher, async_execution=True) t_merge = Task(description="综合 a 与 b", expected_output="报告", agent=writer, context=[t_a, t_b])
注意 t_merge 通过 context 同时依赖 a、b,框架会等两者都完成再启动它。这种"扇出—汇聚"结构在多源采集场景很常见。
收尾提醒:Process 是 C
收尾提醒:Process 是 CrewAI 里最该按"业务不确定性"来选的开关。我们见过团队一上来全用层级模式,结果每次跑出来的报告结构都不同,无法做回归测试。先默认顺序,遇到真实的分支需求再局部放开,是更稳的演进路径。下一站 Tools,讲怎么给这些按流程跑的角色接上外部手脚。
Process 的两种形态与切换成本
Process 决定 Task 之间怎么排。sequential 按列表顺序串行,简单可复现;hierarchical 引入经理 Agent 动态派活,灵活但更贵、更难复现。理解两者的切换成本,才能在正确的时候升级。
| 形态 | 谁决定顺序 | 成本 | 复现性 | 何时用 |
|---|---|---|---|---|
| sequential | 你(写死列表) | 低 | 高 | 步骤固定 |
| hierarchical | 经理 LLM | 高(多一次调用) | 低 | 依赖需动态判断 |
⚠️ 常见坑:在 hierarchical 下忘记给 manager_llm,CrewAI 回退到默认模型,若环境没默认模型直接报错。另外 hierarchical 的经理每次决策带随机性,同样输入可能走出不同路径——需要稳定产出的场景别用。
from crewai import Agent, Task, Crew, Process from crewai.llm import LLM a = Agent(role="A", goal="g", backstory="b", verbose=True) b = Agent(role="B", goal="g2", backstory="b2", verbose=True) t1 = Task(description="步骤一", expected_output="o1", agent=a) t2 = Task(description="步骤二", expected_output="o2", agent=b, context=[t1]) # 顺序流:严格按 t1 -> t2 crew_seq = Crew(agents=[a, b], tasks=[t1, t2], process=Process.sequential) # 层级流:经理决定是否需要插入额外步骤 mgr = LLM(model="gpt-4o-mini", temperature=0.1) crew_hier = Crew(agents=[a, b], tasks=[t1, t2], process=Process.hierarchical, manager_llm=mgr) print(crew_seq.process, crew_hier.process)
💡 关键直觉:Process 是"协作拓扑"而非"执行速度开关"。先用 sequential 把链路正确性验证完,再考虑 hierarchical。很多团队一上来就用 hierarchical,结果既多花钱又难调试——顺序是固定的就没必要让模型替你决定。
# 想看执行轨迹,开 verbose 即可看到每一步谁在干活 crew_seq.verbose = True out = crew_seq.kickoff() assert out is not None