3.3 组建与运行 Crews
3.3 组建与运行 Crews
本节约处在第三章第三站,把前面定义的 Agent 和编排好的 Task 真正装进 Crew 并启动。很多教程止步于"能跑",我们往前一步:讲清 kickoff 的输入输出契约,以及结果怎么消费——因为生产里你很少只是 print(result)。
先把一次 kickoff 的生命
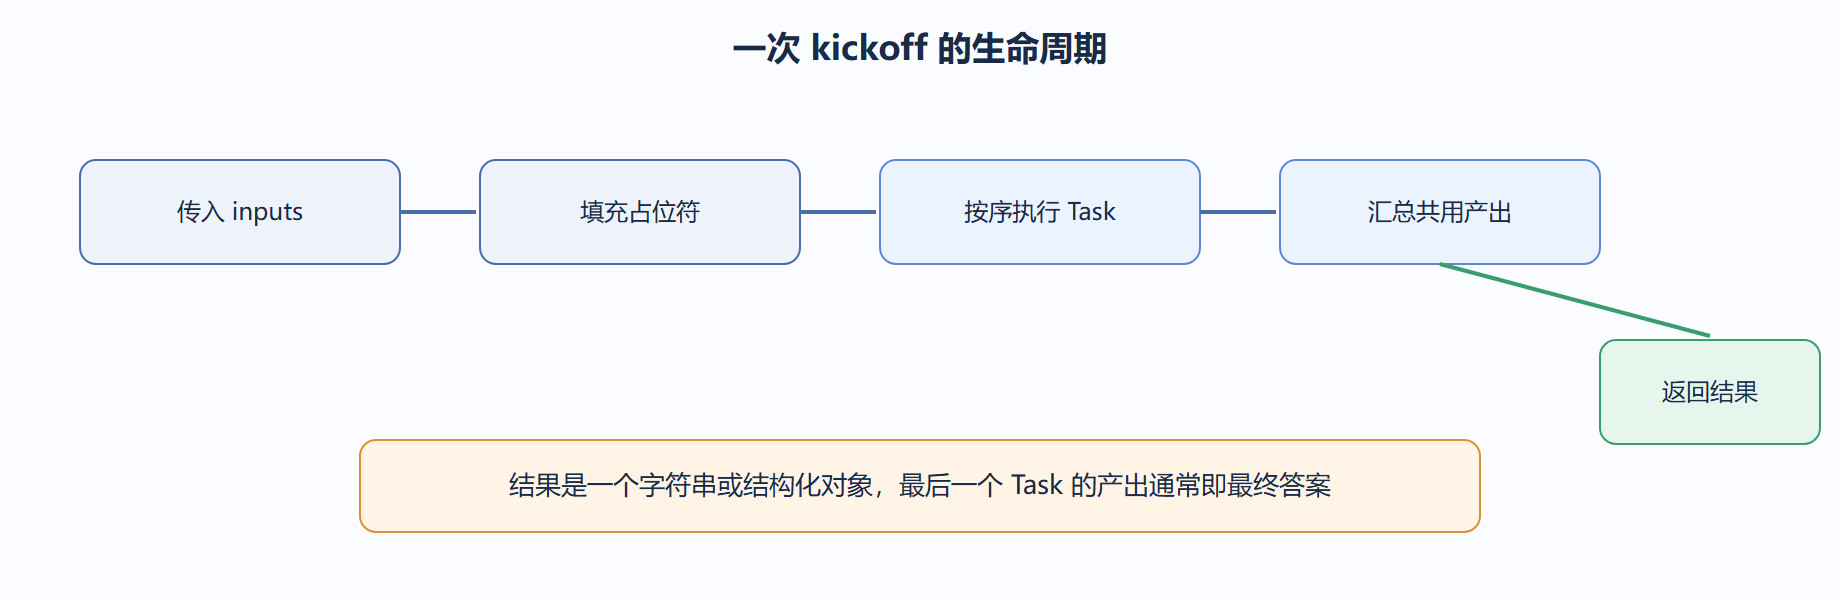
先把一次 kickoff 的生命周期画出来,看清框架在背后做了什么:
最标准的组装与启动,把第三章前两段的对象合起来:
from crewai import Agent, Task, Crew, Process researcher = Agent(role="研究员", goal="找事实", backstory="严谨", verbose=True) writer = Agent(role="写手", goal="成文", backstory="连贯", verbose=True) t_research = Task(description="搜 {topic} 要点", expected_output="三条要点", agent=researcher) t_write = Task(description="写成短评", expected_output="短评", agent=writer, context=[t_research]) crew = Crew( agents=[researcher, writer], tasks=[t_research, t_write], process=Process.sequential, verbose=True, cache=True, ) result = crew.kickoff(inputs={"topic": "边缘计算"}) print(result)
kickoff 的 inputs
kickoff 的 inputs 是一个字典,键对应所有 Task 描述里的 {占位符}。框架先填充占位符,再按序跑 Task,最后返回结果。默认返回的是最后一个 Task 的产出(字符串),多数场景下这就是你要的答案。
但生产里你常需要拿到"每一步"的产出,而不只是最后一步。CrewAI 提供 kickoff 的返回值之外,还可以用 crew.tasks 回溯,或者用 kickoff 的 timeouts 控制单步超时:
# 设定单步超时,防止某个 Task 卡死拖垮全队 result = crew.kickoff(inputs={"topic": "边缘计算"}, timeouts={"task_execution": 120}) # 想拿中间任务产出,可在 Task 上挂 callback,或运行后遍历 for task in crew.tasks: print(task.description, "->", task.output)
task.output 在运行后保存该步产出,是做链路审计的关键。我们建议:凡是需要留痕的场景(合规、复盘),跑完遍历 crew.tasks 把每步 output 落库,而不是只存最终 result。
异步批量启动适合"同一套 Crew 跑多个独立主题"。注意每个 kickoff_async 返回协程,用 asyncio.gather 收敛:
import asyncio async def run_all(topics): return await asyncio.gather(*[ crew.kickoff_async(inputs={"topic": t}) for t in topics ]) # results = asyncio.run(run_all(["储能", "低空经济", "AI 制药"]))
这里有个隐蔽坑:crew 对象在多次 kickoff 之间是状态复用的。如果上一次运行留下了缓存或中间变量,第二次可能受干扰。我们建议批量跑时对每个主题新建 Crew 实例,或用 cache=False 避免串味。这是多智能体并发里最容易忽略的一致性陷阱。
再讲启动失败的两类入口:输入契约类和运行环境类。输入类(占位符没给全)会在启动即抛 KeyError 类异常;环境类(模型凭证失效、工具 key 缺失)会在对应 Task 执行时才爆。排查时先开 verbose=True 看日志停在哪一步,再定位是该步的 Task 定义还是外部依赖。
收尾提醒:组建 Crew 不难,
收尾提醒:组建 Crew 不难,难的是让它的输出"可被消费"。我们见过把 result 直接喂给下游服务、却发现里面混着模型寒暄语的事故——根因是 expected_output 没钉死格式。所以运行阶段的第一要务不是"跑通",而是"跑出来的东西结构稳定、可被程序解析"。下一站讲 LLM 集成,你能进一步用模型参数控制这种稳定性。
把组件拼成可运行的 Crew
组装 Crew 就是把 agents 与 tasks 装进容器并 kickoff。下面给一个完整可跑的例子,覆盖顺序流、context 依赖、输入占位符:
from crewai import Agent, Task, Crew, Process planner = Agent(role="策划", goal="定题", backstory="敏感", verbose=True) writer = Agent(role="写手", goal="写稿", backstory="清楚", verbose=True) t_plan = Task(description="为 {theme} 定一个题目", expected_output="一个题目", agent=planner) t_write = Task(description="按题目写初稿", expected_output="初稿", agent=writer, context=[t_plan]) crew = Crew(agents=[planner, writer], tasks=[t_plan, t_write], process=Process.sequential, verbose=True) result = crew.kickoff(inputs={"theme": "低空经济"}) print(str(result)[:120])
⚠️ 常见坑:kickoff 的 inputs 没覆盖所有占位符会直接 KeyError。我们习惯在组装后先做一次占位符自检(见 3.5 的 check_inputs),比等运行时崩更省事。另一个坑是 tasks 顺序与 context 矛盾——例如把依赖者排在依赖之前且又没声明 context,执行会错乱。
下面演示 hierarchical 下的运行,注意必须给 manager_llm:
from crewai.llm import LLM mgr = LLM(model="gpt-4o-mini", temperature=0.1) crew_h = Crew(agents=[planner, writer], tasks=[t_plan, t_write], process=Process.hierarchical, manager_llm=mgr) out = crew_h.kickoff(inputs={"theme": "低空经济"}) print("hierarchical 完成:", bool(out))
💡 关键直觉:kickoff 是 Crew 的"点火"动作,之前所有定义都是静态蓝图。蓝图可以反复复用、换 inputs 重跑;所以把 Crew 定义和 inputs 分离,是做多场景批量实验的基础。
# 同一蓝图换不同输入重跑 for theme in ["储能", "算力", "机器人"]: r = crew.kickoff(inputs={"theme": theme}) assert r is not None