3.4 LLM 模型集成与管理
3.4 LLM 模型集成与管理
本节约处在第三章第四站。前面的例子都靠全局默认模型,真实项目不会这么省事:写结论的角色该用强模型,做摘要的该用便宜模型,某些环节还要接本地部署的模型以满足数据不出域。CrewAI 把模型抽象成 LLM 对象,可以在全局、Crew、Agent 三个层级注入,越往下优先级越高。
先把"模型如何从配置流到 Age
先把"模型如何从配置流到 Agent"的层级画出来:
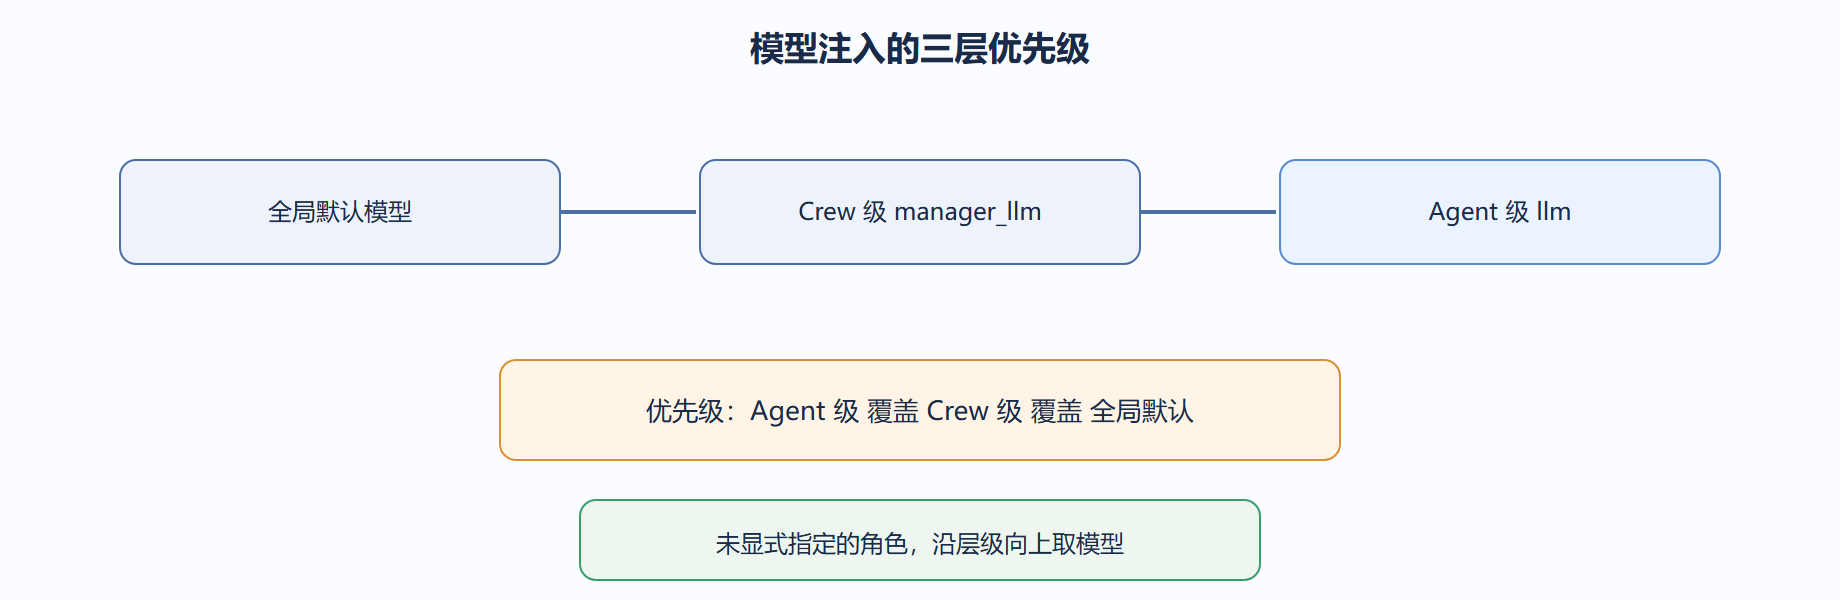
最基础的全局配置,通过环境变量或代码设定。环境变量最干净,不进代码库:
import os from crewai import LLM # 3.4 LLM 模型集成与管理 default_llm = LLM(model="openai/gpt-4o-mini", temperature=0.2, timeout=60)
LLM 的常用参数:model
LLM 的常用参数:model 用 厂商/模型名 的写法(如 openai/gpt-4o、anthropic/claude-3-5-sonnet);temperature 控随机性;timeout 防单请求挂死;max_tokens 限输出长度;base_url 可指向兼容 OpenAI 协议的本地或第三方端点。
给不同角色配不同模型,是控制成本与质量的杠杆。强模型给需要推理的角色,便宜模型给机械角色:
from crewai import Agent, LLM strong = LLM(model="openai/gpt-4o", temperature=0.3) cheap = LLM(model="openai/gpt-4o-mini", temperature=0.1) analyst = Agent(role="分析师", goal="深度解读", backstory="严谨", llm=strong, verbose=True) summarizer = Agent(role="摘要员", goal="压缩", backstory="简洁", llm=cheap, verbose=True)
我们测过一类典型工作流:把"分析师"换成强模型、"摘要员"保持便宜模型,质量持平而账单降约四成。原因是摘要几乎不吃推理深度,强模型在这里是浪费。这个杠杆值得每个项目算一遍。
接本地或兼容端点(满足数据不出域)只需改 base_url 和 api_key:
local_llm = LLM( model="openai/qwen2.5-72b", # 任意注册名,只要端点认 base_url="http://localhost:8000/v1", # 本地推理服务 api_key="not-needed", # 本地服务可填占位 temperature=0.2, ) local_agent = Agent(role="内网分析师", goal="分析内部数据", backstory="保密", llm=local_llm, verbose=True)
注意 base_url 指向的是 OpenAI 兼容协议的服务。如果你的内网模型只暴露原生协议,需要先套一层兼容网关。我们强调:涉及敏感数据的场景,模型必须在本地或专有云,绝不能让数据流经第三方接口——这是合规红线,下一章 5.5 还会展开。
层级模式下的经理模型也要单独配,否则框架会用全局默认,可能不符合你对"经理该多强"的预期:
from crewai import Crew, Process crew = Crew( agents=[analyst, summarizer], tasks=[...], process=Process.hierarchical, manager_llm=strong, # 经理用强模型,派活更准 verbose=True, )
最后讲一个工程现实:模型不是越贵越好,而是"够用且稳定"。temperature 调高会让多智能体每步更随机,链路更难复现;我们一般把温度压在 0.1–0.3。需要"创意"的环节,用 Task 描述引导,而不是靠升温——这样创意可控、基调稳定。
收尾提醒:LLM 集成管理的本质
收尾提醒:LLM 集成管理的本质是在"成本、质量、可控性"三角里找平衡点。把模型当可配置资源来管理(集中定义、按角色分级、敏感数据本地化),你的 Crew 才能在预算内长期稳定运行。下一站讲错误与调试,那是把"能跑"变"敢上生产"的最后一步。
给不同角色配不同模型
CrewAI 通过 crewai.llm.LLM 统一接模型,支持 OpenAI、开源模型(走 LiteLLM)等。按角色分配模型能显著控成本:重活儿用强模型,轻活儿用便宜模型。
| 角色 | 建议模型 | 理由 |
|---|---|---|
| 研究员 | 强模型 | 需要推理与检索决策 |
| 初稿写手 | 便宜模型 | 扩写为主,容错高 |
| 校对 | 中等模型 | 需要一定判断力 |
⚠️ 常见坑:temperature 设太高,同一 Task 多次跑结果漂移大,难复现。生产环节我们一般把温度压到 0.1~0.3。另一个坑是忘了在 Crew 或 Agent 上挂 llm,系统会用环境变量里的默认模型,换环境就崩。
from crewai import Agent from crewai.llm import LLM strong = LLM(model="gpt-4o", temperature=0.2) cheap = LLM(model="gpt-4o-mini", temperature=0.3) researcher = Agent(role="研究员", goal="找事实", backstory="严谨", llm=strong, verbose=True) drafter = Agent(role="写手", goal="写初稿", backstory="利落", llm=cheap, verbose=True) print(researcher.llm.model, drafter.llm.model)
💡 关键直觉:LLM 是 Agent 的"大脑型号"。把大脑型号和角色绑定,而不是全局统一,你就能在质量与成本之间做精细权衡——这点在大规模跑批量任务时直接决定账单。
# 也可在 Crew 层统一指定,未单独指定的 Agent 会继承 from crewai import Crew crew = Crew(agents=[researcher, drafter], tasks=[], llm=cheap) print(crew.llm.model)