3.5 错误处理与调试
3.5 错误处理与调试
本节约处在第三章最后一站,也是把"能跑"变成"敢上生产"的关口。多智能体系统的错误有两个特征:它会沿链路放大,且根因常不在报错的那个 Task。我们给一套从现象到根因的排查方法,而不是罗列异常类型。
先把"错误如何在链路里放大"画出
先把"错误如何在链路里放大"画出来,建立排查直觉:
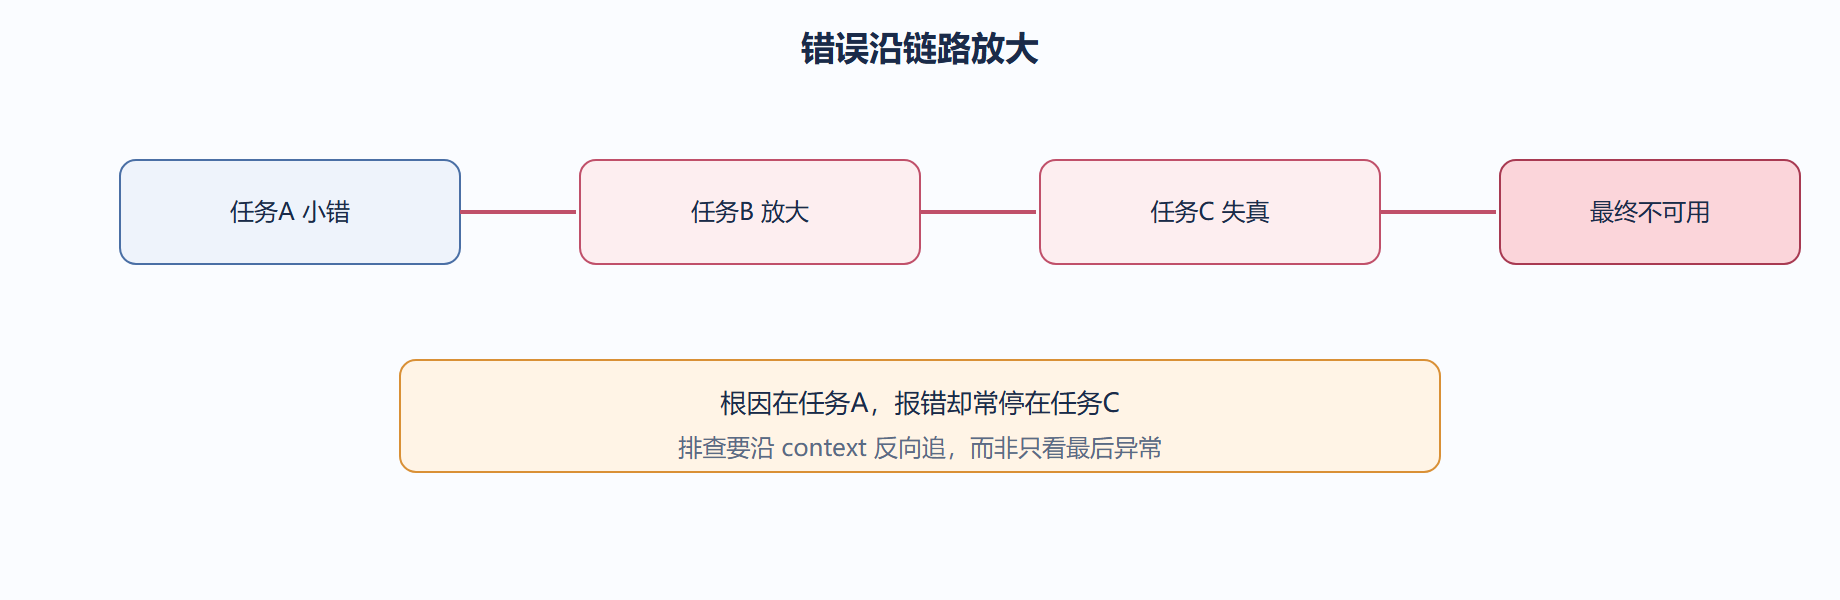
第一类错误:输入契约缺失。Task 描述用了 {topic},kickoff 的 inputs 没给,启动即抛 KeyError。预防办法是在组装后做一次占位符自检:
import re def check_inputs(tasks, inputs): needed = set() for t in tasks: needed.update(re.findall(r"\{(\w+)\}", t.description)) missing = needed - set(inputs.keys()) if missing: raise ValueError(f"缺少输入:{missing}") return True # 3.5 错误处理与调试
这个小函数能在启动前拦掉最常见的
这个小函数能在启动前拦掉最常见的一类崩溃,比等运行时报错再翻日志快得多。我们主张把这类"契约自检"写进项目的启动封装,而不是依赖人工记得。
第二类错误:模型或工具凭证失效。这类不在启动时报,而在具体 Task 执行时爆。定位靠 verbose=True 的日志——看停在哪一步、那一步调了什么工具或模型。封装一个带重试的执行,避免偶发限流直接中断全队:
from crewai import Crew import time def safe_kickoff(crew: Crew, inputs: dict, retries: int = 3): for i in range(retries): try: return crew.kickoff(inputs=inputs) except Exception as e: if i == retries - 1: raise print(f"第{i+1}次失败:{e},重试") time.sleep(2 ** i) # 指数退避
注意重试要放在 Crew 外层,而不是某个 Task 内部——Task 内部的工具调用 CrewAI 自己有重试机制,外层重试是为了兜住整队级别的瞬时故障(如网络抖动)。两者不冲突。
第三类错误:产出格式漂移。模型偶尔不按 expected_output 来,下游解析失败。对付它的办法不是怪模型,而是加一道"产物校验":用另一个轻量 Task 或代码校验上一步输出是否合规,不合规就重跑或标记:
def validate_output(text: str, must_contain: list[str]) -> bool: return all(k in text for k in must_contain) # print("产出缺关键字段,需人工复核或重跑")
调试的通用流程我们总结成四步:开 verbose 看停在哪步 → 沿 context 反向追上一步产出 → 判断是输入契约、外部依赖还是格式漂移 → 在对应层修。绝大多数"任务C 崩了"的根因都能在任务A 找到。
收尾提醒:调试多智能体不是调模型
收尾提醒:调试多智能体不是调模型,是调链路。把每个 Task 的产出当接口来校验、把每步结果落库留痕,你的系统才会在出错时"指得出是哪环",而不是一团浆糊。第三章到此把"定义—编排—组建—接入—排错"五站走完,你已经能端到端跑通一个 Crew。第四章我们在这个能跑的系统上叠加进阶能力,让它跑得久、跑得稳。
再加三类实战排错手段
除了前面提到的契约自检与外层层重试,下面补两个生产里高频用的手段。
其四:给 Task 加 output_file 落盘,出错时能直接看半成品,而不是只看到异常:
from crewai import Task t = Task(description="写报告", expected_output="报告全文", agent=writer, output_file="report.md") # 产出自动写盘 print(t.output_file)
其五:用 max_retry_limit 与工具内部容错双层保护,避免一次外部抖动拖垮全队:
from crewai.tools import tool @tool("安全查询") def safe_query(q: str) -> str: """带内部容错的查询工具。""" try: return f"结果: {q}" except Exception as e: return f"查询暂不可用: {e}" # 返回友好文本而非抛异常 print(safe_query("储能政策"))
⚠️ 常见坑:把重试写进单个 Task 内部的工具,又在外层 Crew 再包一层重试,会让同一失败被重试多次、指数放大耗时。我们约定:工具内部只做单次轻量重试,整队级故障交给外层 safe_kickoff,职责分开。
💡 关键直觉:多智能体调试的元认知是"把每一步当接口测"。你不需要懂模型为什么这次答错,只需要确认:上一步产出符合契约吗?这一步输入齐了吗?落盘留痕后,任何一次崩溃都能定位到具体哪一环,而不是对着一整屏日志发呆。
# 把产物校验接到链路末端,缺字段即报警 def gate(text, must): return all(k in text for k in must) sample = "来源:X。结论:可行。" assert gate(sample, ["来源", "结论"]) is True
调试四步法的可操作模板
前面讲了四步法(开 verbose→沿 context 反向追→判类型→对应层修),这里把它落成可复制的操作。第一步一定先看停在哪一步——verbose 日志里每个 Task 都有明确的"开始/结束"标记,卡在谁的"开始"之前,根因就在它的上游。
| 现象 | 先看 | 常见根因 |
|---|---|---|
| 启动即崩 | inputs 占位符 | 缺传参 |
| 卡在某 Task | 该 Task 的 context | 上游产出为空 |
| 跑完但废 | expected_output | 格式契约虚 |
| 偶发中断 | 工具/模型调用 | 限流或凭证失效 |
⚠️ 常见坑:看到"任务C 崩了"就只改 C。多智能体里 C 的崩溃往往是 A 给了空产出的连锁反应。沿 context 一路向上追,八成能在 A 或 B 找到真因。
# 可复制的最小调试骨架:先单跑上游任务,确认产出非空再跑全链 def debug_upstream(crew): for t in crew.tasks: print(f"任务: {t.description[:30]} | 依赖数: {len(t.context)}") # 对最上游任务单独 kickoff 验证 return crew # 示意:先验证 t_research 再验证 t_write debug_upstream(crew)
💡 关键直觉:调试多智能体系统像排查一条水管——哪段不出水,问题在它上游的接口,而不是出水口本身。把每个 Task 的产出当成接口来校验,系统出错时就能"指得出是哪环",而不是对着一整屏日志发呆。
# 给每个 Task 产出打标,便于定位空产出 def tag_nonempty(task_result, name): ok = bool(str(task_result).strip()) print(f"{name} 产出非空: {ok}") return ok assert tag_nonempty("一些结果", "t_research") is True