3.1 关系型数据库插件(MySQL, Oracle, PostgreSQL, SQLServer)
3.1 关系型数据库插件(MySQL, Oracle, PostgreSQL, SQLServer)
关系型数据库是 DataX 用得最频繁的一类源和目标。这类插件的能力高度相似,因为底层都是 JDBC。本节以 MySQL Reader 为主,点出通用的提速与避坑点。
连接与查询参数
Reader 侧要给出 jdbcUrl、表名、列集合。列不建议用 * 通配,显式列出能避免源端表结构变更时把无用大字段拉进来拖慢任务。Oracle、PostgreSQL、SQLServer 的 Reader 字段几乎一致,只是 name 和 jdbc 前缀不同。
{ "reader": { "name": "mysqlreader", "parameter": { "username": "etl", "password": "${DB_PWD}", "connection": [{ "jdbcUrl": ["jdbc:mysql://h:3306/ods"], "table": ["user"], "splitPk": "id" }], "column": ["id", "name", "created_at"], "where": "status = 1" } } }
splitPk:并发读取的核心
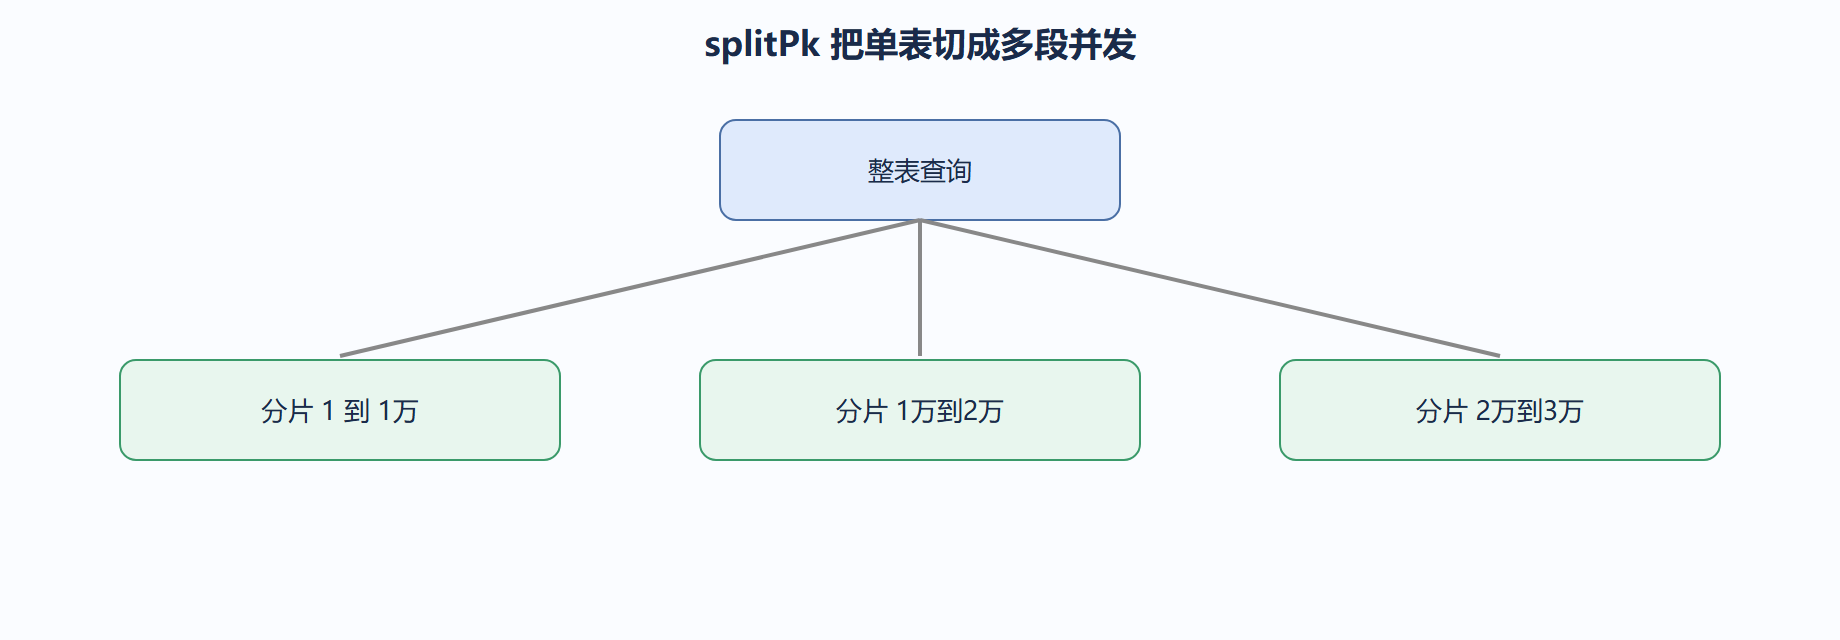
关系型 Reader 默认单线程读整张表。设置 splitPk 后,框架按该主键的区间把表切成多段,每段一个并发 Task。这让大表同步从「一条查询扛全场」变成「多段并行」。代价是 splitPk 列必须均匀分布、最好是数值型主键;若列有热点,分片会倾斜。
Writer 的写入模式
关系型 Writer 有 insert 与 replace 等模式。replace 依靠主键或唯一索引覆盖,适合每日全量覆盖的场景;insert 适合纯追加。误用 replace 到无唯一约束的表,可能变成重复插入。我们认为写模式必须和数据更新语义对齐,不能拍脑袋。
通用避坑
密码不要明文写进 job.json,用 ${ENV} 占位由启动脚本注入。大表务必设 splitPk,否则单并发跑一整夜。源端有视图或函数列时,Reader 可能不支持,需改写成基础列查询。这些点我们在生产里都踩过。
不同关系型库的细微差别
虽然都走 JDBC,但各库 Reader 仍有差异:Oracle 常用 sid 或 service_name 区分连接,PostgreSQL 的 schema 要写进表名,SQLServer 用实例名。这些差异体现在 jdbcUrl 和表名写法上,插件 name 也不同。我们维护一份内部速查表,接入新库时先对一眼。
| 数据库 | 插件名 | 注意点 |
|---|---|---|
| MySQL | mysqlreader | splitPk 用自增主键 |
| Oracle | oraclereader | 连接串含 service |
| PostgreSQL | postgresqlreader | schema 前缀 |
| SQLServer | sqlserverreader | 实例名写法 |
不管哪种库,核心提速手段都是 splitPk 分片并发。我们接入前先确认表有合适的主键或均匀列做分片键,否则并发收益会大打折扣。
延伸与提醒
把 DataX 当搬运工而非加工车间,链路才简单可排查。
权限收得越紧,凭据泄露的爆炸半径越小。
Hive 表的分区设计直接影响下游查询性能,写入时就该想清楚。
配置进版本库、密码进环境变量,是跨环境复用的基础。
日志里周期打印的读写速率,是定位瓶颈的第一手材料。
调优的本质是在 CPU、网络带宽和磁盘 IO 之间找平衡点,不是堆资源。
源库索引评审应作为同步查询上线的前置环节。
querySql 与 column 二选一,混用会直接报错。
限速不是限制能力,而是给其他任务留出生存空间。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
Reader 和 Writer 互不知晓,正是插件能独立扩展的原因。
Oracle 的 Reader 在连接串上用 service name,写法略有不同。
{ "reader": { "name": "oraclereader", "parameter": { "connection": [{ "jdbcUrl": ["jdbc:oracle:thin:@//h:1521/orcl"], "table": ["t"] }] } } }
背景
关系型数据库是 DataX 最常用的源。能否跑得快、能否增量、能否不锁表,几乎全靠 reader 的几个参数。我们以 MySQL 为例拆解。
操作:带 splitPk、where、querySql 的配置
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "etl", "password": "secret", "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/order"], "table": ["t_order"] } ], "column": ["id","user_id","amount","create_time"], "splitPk": "id", "where": "create_time >= '2024-01-01' AND create_time < '2024-01-02'", "fetchSize": 1000 } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://ns", "path": "/data/order/dt=20240101", "fileType": "text", "column": [ {"name":"id","type":"bigint"}, {"name":"user_id","type":"bigint"}, {"name":"amount","type":"double"}, {"name":"create_time","type":"string"} ] } } } ], "setting": { "speed": { "channel": 8 } } } }
启动命令
# 3.1 关系型数据库插件(MySQL, Oracle, PostgreSQL, SQLServer) mysql -u etl -p demo -e "SELECT COUNT(*) FROM t_order WHERE create_time>='2024-01-01' AND create_time<'2024-01-02';"
结果解读
splitPk:必须是整型主键,框架据此把表水平切段,每段一个 Task 并发读,这是关系型源提速的关键;where:增量过滤条件,配合调度日期实现每日切片;fetchSize:每次从 JDBC 拉取的批次大小,过小明文交互多、过大会吃客户端内存。
Oracle / PostgreSQL / SQLServer 的 reader 参数同构,仅连接串与部分类型映射不同。
变式
当需要做复杂抽取(如多表 join、列运算)时,用 querySql 直接写 SQL 取代 table + column,此时 splitPk 需指向查询结果里的数值列以保证仍可分片。
关系型 Reader 参数对照
| 参数 | 作用 | 误用后果 |
|---|---|---|
| splitPk | 并发切分 | 缺失则单线程 |
| where | 增量过滤 | 缺失则全量 |
| fetchSize | 拉取批次 | 过小明文开销大 |
| querySql | 自定义 SQL | 失 splitPk 则不可并发 |
💡 关键直觉:关系型 Reader 的并发几乎都来自 splitPk 把一张表「竖着切开」。没有它,再多的 channel 也只是多个线程抢同一把锁式地顺序读。
⚠️ 常见坑:用字符串主键或唯一索引列当 splitPk,框架无法做范围切分,退化为单通道;另外 querySql 与 table/column 二选一,两者同时写会冲突。