- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
DataX 异构数据源同步工具实战教程
DataX 是阿里巴巴开源的离线数据同步工具,定位在异构数据源之间搬运批量数据。本教程把它当作一条工程主线来讲:读数据、在内存里交换、写数据。围绕这条线,我们把内容拆成八个章节,从概念、架构、插件、配置、调优、部署、扩展再到生态,层层递进。
我们写这份教程的出发点很实际:很多团队把 DataX 当黑盒脚本用,跑通一条 MySQL 到 Hive 的任务就完事,一旦遇到慢、报错、数据对不上,就束手无策。真正要把它用在生产上,得先理解它的分层调度模型和插件协议,才能在并发、内存、脏数据这些旋钮上做正确取舍。
本册主线与知识地图
全册遵循「源端采集 → 交换缓冲 → 目标写入」这条物理链路展开。第一章建立问题与定位,第二章拆架构,第三章梳理 Reader/Writer 插件族,第四章讲任务配置,第五章攻性能与排错,第六章管部署运维,第七章做扩展开发,第八章看生态与未来。八章之间有依赖:没有第二章的架构认知,第五章的调优参数就是无根之木。
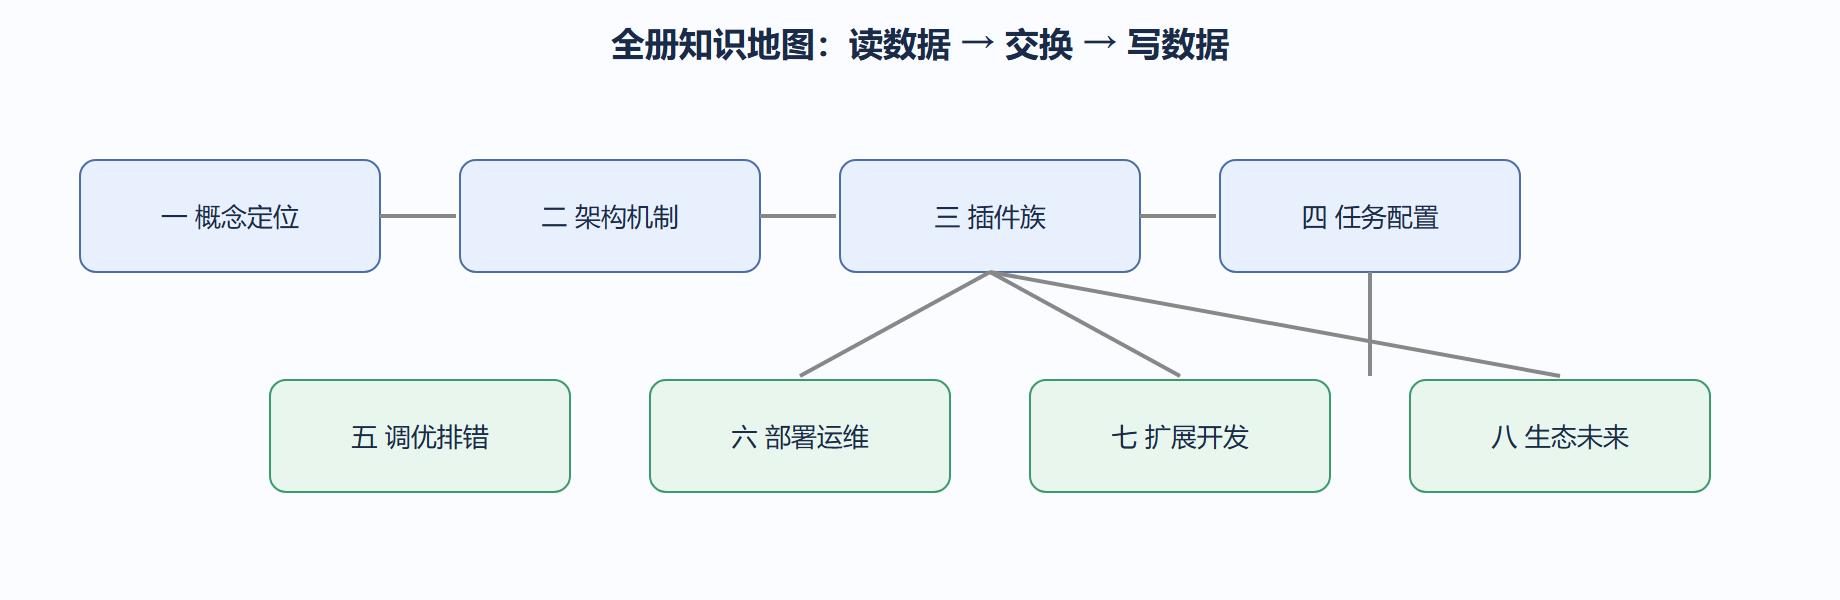
这套教程写给谁
我们假定你已经在生产环境碰过数据库或数据仓库,知道什么是主键、什么是批量导入。不需要你提前懂 Java,但第五章的 JVM 调优部分会点到一些内存模型常识。如果你只想要一条能跑的命令,直接跳到第四章和第六章;如果想搞清「为什么慢」,请耐着性子读完第二章和第五章。
阅读建议
建议按章节顺序读,因为配置参数和调优手段都建立在架构认知之上。每章开头会说明它在全册的位置和前置知识,章末给出可考核的知识点。遇到 JSON 配置样例,请动手改一两个字段再运行,比纯看印象深得多。
我们把大量篇幅放在真实 job 配置、启动命令、调优参数和报错排查上,因为这些都是文档里最容易被一笔带过、实际却最吃功夫的地方。读完你应能独立设计一条同步链路、估算它的吞吐上限、并在出错时定位到是 Reader 端、Channel 还是 Writer 端的问题。
为什么需要这样一份实战教程
DataX 是面向异构数据源之间高速稳定的离线同步工具,定位上类似「数据管道」里的水泵:一端接数据源(关系型数据库、NoSQL、消息队列、对象存储、本地文件),另一端接数据目标,中间由可插拔的 Reader 与 Writer 把数据抽出来再写进去。它在金融、通信、互联网等行业的「把业务库数据搬进数据仓库 / 数据湖」场景里几乎是标配组件。
适用人群
| 角色 | 学完能解决什么问题 |
|---|---|
| 数据开发工程师 | 写出正确、可并发的同步作业,把 MySQL、Oracle 数据稳定搬进 Hive、HDFS |
| 数仓 / ETL 工程师 | 设计每日增量同步、全量初始化、跨集群搬运的方案 |
| 运维 / 平台工程师 | 部署 DataX、排查 OOM 与超时、做资源隔离与多租户 |
| 技术管理者 | 评估 DataX 与 Sqoop、Kettle、 Canal 的取舍,规划数据集成架构 |
学完你能做什么
- 独立编写并运行一份从关系型库到 HDFS 的完整 job 配置;
- 针对「跑得慢」「内存溢出」「数据对不上」三类典型问题定位根因并调优;
- 在任务配置模块里合理设置 channel、speed.byte、splitPk、errorLimit 等参数;
- 掌握自定义 Reader / Writer 插件的扩展思路,以及 DataX Web 的可视化运维。
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "etl", "password": "***", "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/order"], "table": ["t_order"], "splitPk": "id" } ] } }, "writer": { "name": "streamwriter", "parameter": { "print": true } } } ], "setting": { "speed": { "channel": 4 } } } }
# DataX 异构数据源同步工具实战教程 python datax.py job/mysql_to_stream.json # 进程退出码为 0 表示抽取链路本身连通,再换成真正的落盘目标
💡 关键直觉:把 DataX 想成「带流量控制的双向水泵」——Reader 负责把水抽上来,Writer 负责把水排下去,中间的 Channel 就是水管,channel 数就是并排的水管数量,调大它能提速,但也会同时吃内存。
⚠️ 常见坑:初学时容易把「能跑通冒烟测试」误当成「生产可用」。冒烟只验证了连通性,真实同步还要验证字段类型映射、增量条件、写入幂等性与失败重试。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...