3.3 NoSQL数据库插件(MongoDB, Redis, ElasticSearch等)
3.3 NoSQL数据库插件(MongoDB, Redis, ElasticSearch等)
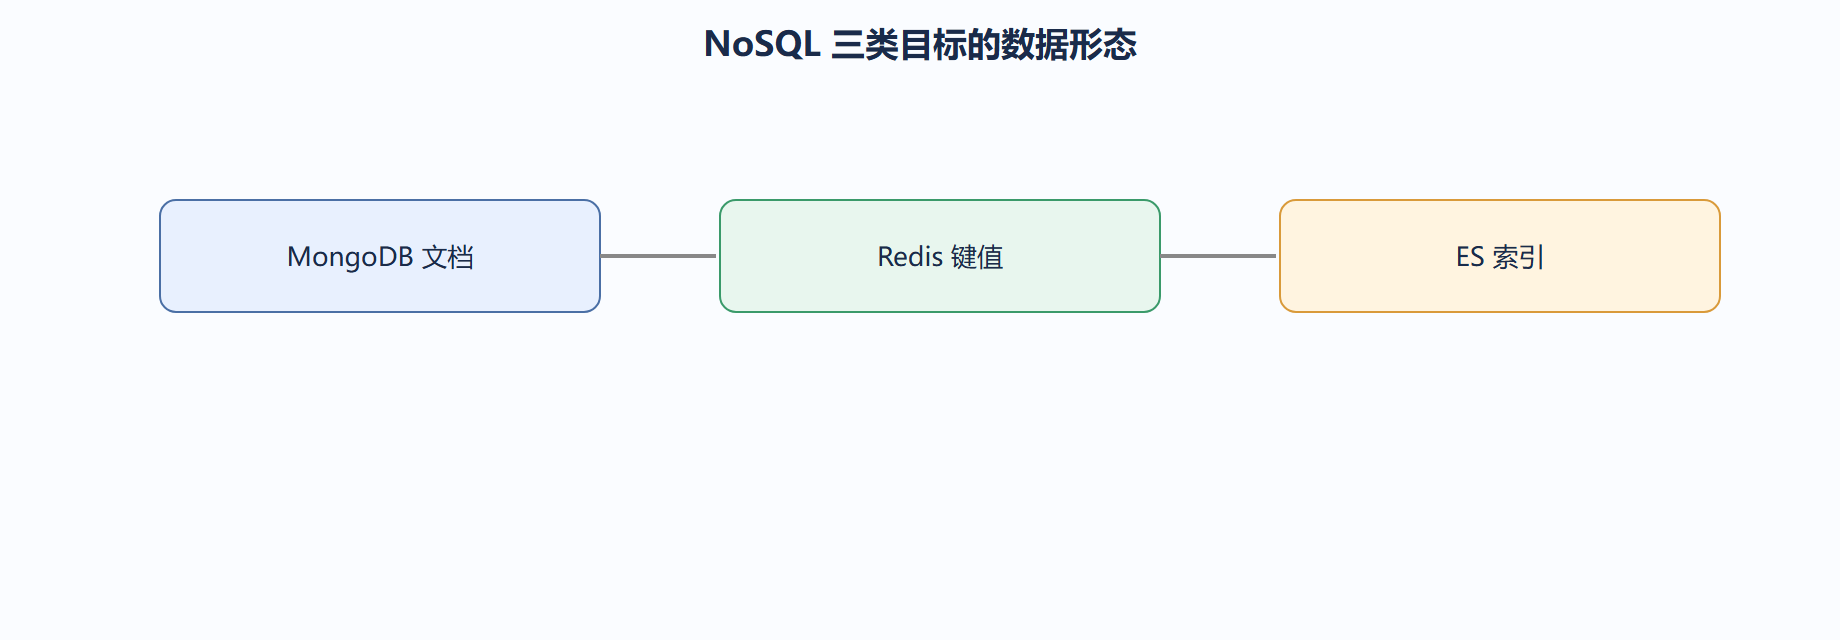
NoSQL 插件的目标系统形态差异很大:MongoDB 是文档、Redis 是键值、ES 是索引。DataX 对它们的支持程度不一,使用时要有预期。
MongoDB Reader:查询与分批
mongodbreader 支持传 query 过滤、按某字段做切分实现并发。文档里的嵌套结构需要靠 column 的 type 声明映射成扁平列。我们读 Mongo 时尽量在 query 里先过滤,避免把整个集合拉进 Channel。
{ "reader": { "name": "mongodbreader", "parameter": { "address": ["mongo:27017"], "dbName": "shop", "collectionName": "orders", "query": "{"status": "paid"}", "splitPk": "_id" } } }
Redis Writer:键值与过期
rediswriter 把记录写成 key-value,key 由配置拼出,value 可是字段拼接或 json。它支持设置过期时间。Redis 是内存存储,大批量写入要控制速率,否则把内存和带宽打满,影响在线业务。我们一般把 Redis 同步放在低峰期,并限制 channel。
ElasticSearch Writer:索引与映射
eswriter 把记录写成文档,需要指定 index 和 type(或 _doc)。字段类型需在 ES 侧建好映射,DataX 不会自动建表。批量 bulk 写入是性能关键,singleIndex 等参数控制索引策略。
工程提醒
NoSQL 插件对「一致性」的保证弱于关系型。Redis 同步中断后重跑可能产生重复 key,需要业务侧幂等。我们认为凡是用 DataX 写 NoSQL,都要先想清楚「重跑会不会出问题」,而不是只关心能不能写进去。
一致性的现实
NoSQL 插件对「写完即一致」的保证弱于关系型。Redis 同步中断后重跑可能产生重复 key,ES 写入是近实时的(refresh 后才可查)。我们写 NoSQL 前都先问:重跑会不会出问题?能否靠幂等设计兜底?
| 目标 | 一致性特点 | 重跑注意 |
|---|---|---|
| MongoDB | 靠 _id 幂等 | 可覆盖 |
| Redis | 覆盖写 | 防重复 key |
| ES | 近实时 | 等 refresh |
我们的原则是:凡是写 NoSQL 的任务,都设计成可重跑幂等。比如 Redis 用固定 key 模板,重跑就是覆盖而非新增;ES 用相同 _id,重跑即更新。这样调度重试时才安全。
延伸与提醒
splitPk 的列若分布不均,分片会倾斜,部分 Task 拖慢整体。
退出码接进调度系统,才能让失败在半夜被及时发现。
多租户隔离交给编排层,DataX 保持简单最稳妥。
Reader 和 Writer 互不知晓,正是插件能独立扩展的原因。
把复杂 join 留在计算引擎,DataX 只做贴源搬运。
orc 加 snappy 是 Hive 落地的常见稳妥组合,省空间且查询快。
自定义插件最容易踩的坑是依赖冲突,provided 范围能治本。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
Channel 是有界缓冲,填满即触发反压保护内存。
querySql 与 column 二选一,混用会直接报错。
生产环境的稳定性,常常取决于部署习惯而非某个高级特性。
监控指标和 DataX 日志交叉看,能锁定九成瓶颈。
日志里周期打印的读写速率,是定位瓶颈的第一手材料。
channel 数超过源端连接承受能力时,瓶颈会从 DataX 转移到数据库。
反压机制保护内存,看到任务变慢应去优化下游而非加并发。
数据湖贴源层保留原始形态,方便后续 schema 演化。
插件目录名必须和 job.json 的 name 完全一致,大小写都不能错。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
JVM 堆要给 Channel 缓冲留足空间,否则 GC 频繁拖慢吞吐。
机器核数、内存、带宽三者共同决定 channel 的甜点值。
全量基线加增量补充,是批流配合的常见稳妥组合。
一张参数与吞吐的经验曲线,比任何通用公式都贴近你的环境。
任务的读写速率差,比绝对速率更能说明瓶颈在哪一段。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
Redis 同步重跑要防重复 key,靠固定模板才能幂等。
关系型 Writer 的批量提交大小,要在往返开销和回滚成本间权衡。
MongoDB 的分片键可选 _id,配合 query 过滤提升效率。
{ "reader": { "name": "mongodbreader", "parameter": { "splitPk": "_id", "query": "{"status":"paid"}" } } }
背景
MongoDB、Redis、ElasticSearch 等 NoSQL / 检索系统,数据模型与关系型差异大。DataX 通过各自插件把差异封装掉,但你仍要理解「它怎么把文档 / 键值翻译成行」。
操作:MongoDB 到 ElasticSearch
{ "job": { "content": [ { "reader": { "name": "mongodbreader", "parameter": { "address": ["mongo:27017"], "dbName": "shop", "collectionName": "product", "column": [ {"name":"_id","type":"string"}, {"name":"title","type":"string"}, {"name":"price","type":"double"} ] } }, "writer": { "name": "elasticsearchwriter", "parameter": { "endpoint": "http://es:9200", "index": "product", "type": "_doc", "column": [ {"name":"_id","type":"id"}, {"name":"title","type":"text"}, {"name":"price","type":"double"} ] } } } ], "setting": { "speed": { "channel": 4 } } } }
启动命令
# 3.3 NoSQL数据库插件(MongoDB, Redis, ElasticSearch等) curl -s "http://es:9200/product/_count?filter_path=count"
结果解读
mongodbreader 通过 column 把文档字段投影成行;elasticsearchwriter 则把行按 column 映射到索引字段,其中 type:"id" 的列作为文档 _id。Redis 的 writer 类似,但需指定 key 的生成规则(如固定前缀 + 列值),因为 Redis 是键值模型而非表模型。
变式
把 writer 换成 rediswriter,用 keyField 指定哪一列做 key、valueField 指定值,即可把商品信息同步进缓存,支撑读多写少的查询场景。
NoSQL 插件对照
| 插件 | 源模型 | 映射关键 |
|---|---|---|
| mongodbreader | 文档 | column 投影 |
| elasticsearchwriter | 索引 | 字段类型映射 |
| rediswriter | 键值 | key 规则 |
| hbasewriter | 列族 | rowkey + qualifier |
💡 关键直觉:NoSQL 插件做的核心工作是「把非表模型拍平成行(读)或把行展开成非表模型(写)」。理解源 / 目标的原生模型,映射参数自然就懂了。
⚠️ 常见坑:ES writer 的 column 里把本该是 id 类型的列写成普通 text,导致每次写入都生成新 _id,出现大量重复文档而非更新。主键语义必须显式声明。