4.1 JSON配置文件的结构与语法规范
4.1 JSON配置文件的结构与语法规范
一份 DataX job 配置就是一份 JSON。它看起来简单,但字段拼错、结构错位都会让任务起不来。本节给出最小可运行结构,并标出每个块的作用。
顶层结构
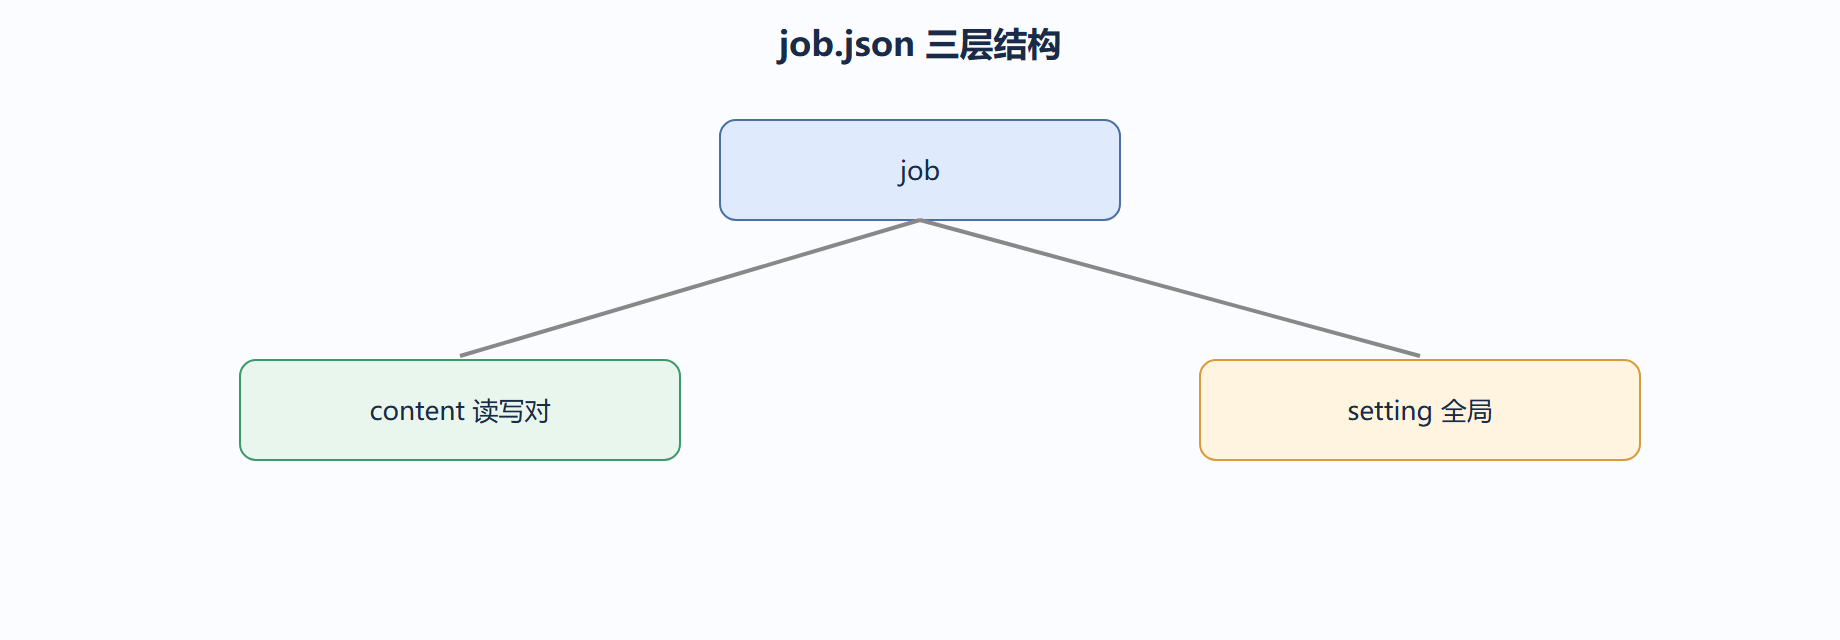
最外层是 job,内含 content 和 setting。content 是数组,每项是一对 reader+writer,代表一组同步。setting 放全局调度与容错。这样一个 job 可以包含多对读写,但通常我们一个 job 只放一对,便于独立调度和失败隔离。
{ "job": { "content": [ { "reader": { "name": "streamreader", "parameter": { "column": [{"value": 1, "type": "long"}] } }, "writer": { "name": "streamwriter", "parameter": { "print": true } } } ], "setting": { "speed": { "channel": 1 } } } }
一个常见坑:YAML 与 JSON
很多同学把 DataX 配置写成 YAML,结果引擎解析失败。DataX 只认 JSON,注释要用JSON不支持的方式处理——实际上标准 JSON 不允许注释,社区版支持 // 和 /* */ 注释是 DataX 自己做的扩展。我们建议在团队模板里统一用这种注释,但提交前用 jsonlint 验证一遍,避免带注释的写法在别的版本上翻车。
参数类型要对
column 里每个字段要带 type,type 必须和目标端匹配。比如源端是 string,目标端是 timestamp,就需要 Transformer 或 SQL 侧先转换。类型不匹配是运行期才暴露的错误,越早在校验阶段发现越好。
我们的习惯
我们把 job.json 拆成「模板 + 变量」:模板里密码、路径用 ${VAR} 占位,由启动脚本注入。这样同一份模板能跨环境复用,也避免敏感信息进仓库。第四章后续几节会逐个拆 reader、writer、全局参数。
校验比写完更重要
配置写完后,我们先用 python -m json.tool 或 jq 校验结构合法,再用一个小样本(比如 limit 100 行)试跑,确认两端连通、类型对得上,才放量到全量。这个过程几分钟,却能避免全量跑两小时才发现一个字段拼错。
| 步骤 | 目的 |
|---|---|
| 结构校验 | 防 JSON 语法错 |
| 小样本试跑 | 防类型/连通错 |
| 全量放量 | 正式同步 |
我们团队把这份「先校验后放量」的流程固化成脚本,谁提交 job 都过一遍。表面上多了一步,实际省下的排错时间远超它。
延伸与提醒
把转换逻辑下推到源库,通常比在 DataX 内部处理更高效。
writeMode 必须和数据更新语义对齐,不能凭感觉选。
Channel 是有界缓冲,填满即触发反压保护内存。
JVM 堆要给 Channel 缓冲留足空间,否则 GC 频繁拖慢吞吐。
orc 加 snappy 是 Hive 落地的常见稳妥组合,省空间且查询快。
preSql 里带 truncate 的任务,上线前必须二次确认目标表名。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
限速不是限制能力,而是给其他任务留出生存空间。
channel 数超过源端连接承受能力时,瓶颈会从 DataX 转移到数据库。
全量基线加增量补充,是批流配合的常见稳妥组合。
数据湖贴源层保留原始形态,方便后续 schema 演化。
querySql 与 column 二选一,混用会直接报错。
脏数据阈值设得太高,会掩盖源端的数据质量问题,反而埋雷。
splitPk 的列若分布不均,分片会倾斜,部分 Task 拖慢整体。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
把 DataX 当搬运工而非加工车间,链路才简单可排查。
机器核数、内存、带宽三者共同决定 channel 的甜点值。
监控指标和 DataX 日志交叉看,能锁定九成瓶颈。
任务可重跑幂等,是生产上线前的硬指标。
星型拓扑把 N 乘 M 的对接降到 N 加 M,变更成本随之下降。
源库索引评审应作为同步查询上线的前置环节。
任务的读写速率差,比绝对速率更能说明瓶颈在哪一段。
关系型 Writer 的批量提交大小,要在往返开销和回滚成本间权衡。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
权限收得越紧,凭据泄露的爆炸半径越小。
反压机制保护内存,看到任务变慢应去优化下游而非加并发。
提交前用 json 校验工具确认结构合法。
python -m json.tool job/x.json > /dev/null && echo "JSON 合法" # 或 jq empty job/x.json
背景
很多人觉得 JSON 配置「能抄就抄」,一旦报错却看不懂结构。我们把一份完整 job 的骨架逐层展开,建立「配置即文档」的直觉。
操作:完整骨架(含全部常见节点)
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "etl", "password": "secret", "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/demo"], "table": ["t_demo"], "splitPk": "id" } ], "column": ["id","name"], "where": "id > 1000" } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://ns", "path": "/data/demo", "fileType": "text", "column": [ {"name":"id","type":"bigint"}, {"name":"name","type":"string"} ] } } } ], "setting": { "speed": { "channel": 4, "byte": 1048576 }, "errorLimit": { "record": 10, "percentage": 0.01 } } } }
启动命令
# 先用 python -m json.tool 校验语法,再交给 DataX,避免把 JSON 错误甩给框架 python -m json.tool job/demo.json > /dev/null && echo "JSON 合法" python bin/datax.py job/demo.json
结果解读
骨架分三层:job.content 是同步单元数组(可放多个 reader-writer 对并行跑不同表);job.content[].reader/writer 各填插件名与参数;job.setting 是全局控制。connection 支持多个 jdbcUrl 实现多库同构表合并抽取。DataX 支持 JSON 中的 // 注释,便于在配置里标注用途。
变式
若要一次同步多张结构相同的表,把多个 {jdbcUrl, table} 塞进 connection 即可,无需写多份 job。
结构节点对照
| 节点 | 含义 | 必填 |
|---|---|---|
| job.content | 同步单元 | 是 |
| reader/writer | 读写插件 | 是 |
| connection | 数据源连接 | 是 |
| setting | 全局控制 | 建议 |
💡 关键直觉:job.json 不是黑盒,它是一张「谁、从哪、到哪、怎么控」的四元组声明。能背下骨架,就具备了读任何报错配置的能力。
⚠️ 常见坑:把注释写在字符串值里或用了 JSON 不支持的尾随逗号,导致解析失败;虽然 DataX 支持 // 注释,但 /* */ 与尾随逗号仍不被标准解析接受,写前用 json.tool 校验最稳。