7.4 资源隔离与多租户支持
7.4 资源隔离与多租户支持
当一台机器上跑多个团队的任务,资源隔离就不是锦上添花,而是能不能共存的问题。DataX 本身轻量,隔离要靠外围手段。
为什么需要隔离
DataX 任务吃内存和带宽。若 A 团队的任务把 channel 开满,B 团队的任务就会被饿死。多租户环境下,我们需要给每个租户划出资源上限,保证互相不踩。这不是 DataX 内置能力,而是部署形态要解决的问题。
# 7.4 资源隔离与多租户支持 cgcreate -g memory,cpu:/datax_teamA echo 4G > /sys/fs/cgroup/memory/datax_teamA/memory.limit_in_bytes cgclassify -g memory,cpu:/datax_teamA $(pgrep -f datax.py)
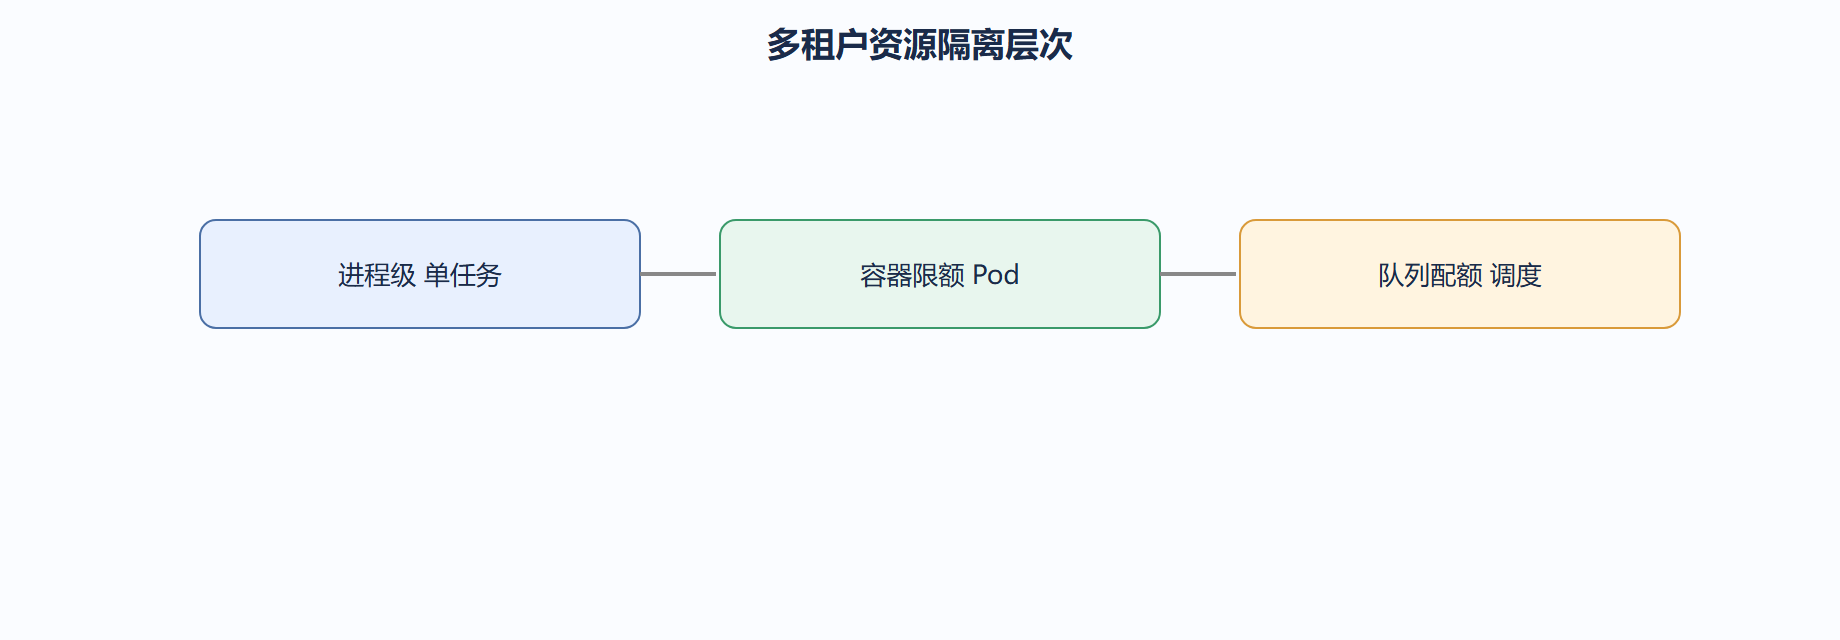
进程级隔离
最朴素的做法是「一个任务一个进程 + cgroup/容器限额」。K8s 上把每个执行器跑在限定资源的 Pod 里,天然隔离。我们倾向容器化执行器,因为限额、调度、日志收集都现成,不必自己造轮子。
配额与优先级
在调度层给不同租户不同配额和优先级:核心业务高优先、占固定槽位;分析类低优先、闲时跑。DataX 的 channel/byte 限速在这里变成「租户能用的吞吐上限」,让配额真正落地。
我们的实践
我们不在裸机上混跑多团队任务,而是每个执行器 Pod 限定 CPU/内存,调度器按租户分配 Pod。这样既隔离又弹性,扩缩容跟着 K8s 走。DataX 本身保持简单,复杂的资源博弈交给编排层。
隔离交给编排层
| 层次 | 做法 |
|---|---|
| 进程级 | 单任务单进程 |
| 容器级 | Pod 限额 |
| 调度级 | 队列配额 |
DataX 的 channel/byte 限速在这里变成「租户可用吞吐上限」,让配额真正落地。多租户环境下,隔离不是锦上添花,而是能不能共存的问题。
延伸与提醒
多租户隔离交给编排层,DataX 保持简单最稳妥。
splitPk 的列若分布不均,分片会倾斜,部分 Task 拖慢整体。
任务的读写速率差,比绝对速率更能说明瓶颈在哪一段。
把转换逻辑下推到源库,通常比在 DataX 内部处理更高效。
任务可重跑幂等,是生产上线前的硬指标。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
把 DataX 当搬运工而非加工车间,链路才简单可排查。
限速不是限制能力,而是给其他任务留出生存空间。
orc 加 snappy 是 Hive 落地的常见稳妥组合,省空间且查询快。
测试样本先小后大,几分钟校验能省下几小时排错。
日志里周期打印的读写速率,是定位瓶颈的第一手材料。
反压机制保护内存,看到任务变慢应去优化下游而非加并发。
关系型 Writer 的批量提交大小,要在往返开销和回滚成本间权衡。
Redis 同步重跑要防重复 key,靠固定模板才能幂等。
preSql 里带 truncate 的任务,上线前必须二次确认目标表名。
源库索引评审应作为同步查询上线的前置环节。
channel 数超过源端连接承受能力时,瓶颈会从 DataX 转移到数据库。
JVM 堆要给 Channel 缓冲留足空间,否则 GC 频繁拖慢吞吐。
配置进版本库、密码进环境变量,是跨环境复用的基础。
Channel 是有界缓冲,填满即触发反压保护内存。
监控指标和 DataX 日志交叉看,能锁定九成瓶颈。
Hive 表的分区设计直接影响下游查询性能,写入时就该想清楚。
机器核数、内存、带宽三者共同决定 channel 的甜点值。
权限收得越紧,凭据泄露的爆炸半径越小。
调优的本质是在 CPU、网络带宽和磁盘 IO 之间找平衡点,不是堆资源。
一张参数与吞吐的经验曲线,比任何通用公式都贴近你的环境。
星型拓扑把 N 乘 M 的对接降到 N 加 M,变更成本随之下降。
全量基线加增量补充,是批流配合的常见稳妥组合。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
插件目录名必须和 job.json 的 name 完全一致,大小写都不能错。
Web 平台解决协作与可观测,不提升同步能力本身。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
退出码接进调度系统,才能让失败在半夜被及时发现。
把复杂 join 留在计算引擎,DataX 只做贴源搬运。
用 cgroup 给执行器进程限资源,是多租户隔离的底层手段。
cgcreate -g memory,cpu:/datax_teamA echo 4G > /sys/fs/cgroup/memory/datax_teamA/memory.limit_in_bytes
背景
一台 DataX 机器若被多个团队共用,任务之间会抢 CPU、内存、带宽,甚至一个大任务把整台机器拖垮,连累他人。资源隔离与多租户就是要解决「共用不互害」。
操作:用 JVM 参数给任务划内存边界
# 给每个租户的任务单独限定堆大小,避免一家吃满全部内存 python bin/datax.py --jvm="-Xms1G -Xmx2G" job/tenant_a.json python bin/datax.py --jvm="-Xms1G -Xmx2G" job/tenant_b.json
启动命令
# 示例:把租户 A 的任务放进内存上限 4G 的容器 docker run --memory=4g -v $PWD:/job datax:latest python bin/datax.py /job/tenant_a.json
结果解读
隔离有两个层面:进程内靠 channel 与 speed.byte 限制单任务的并发与流量,避免它吃光单机资源;进程 / 主机层面靠容器(cgroup 内存、CPU 配额)或虚拟机把不同租户的任务物理隔开。多租户平台(如 DataX Web)通常再叠加「租户配额」——给每个团队分配可用 channel 上限与并发额度,从调度层防止超额。
变式
对 IO 敏感的租户,可在调度层把它的任务排到业务低峰,或单独分配一台机器组成「租户专属资源池」,彻底消除邻位干扰。
隔离层次对照
| 层次 | 手段 | 隔离什么 |
|---|---|---|
| 任务内 | channel / byte | 并发与流量 |
| 容器 | cgroup | 内存 / CPU |
| 调度 | 配额 | 租户额度 |
💡 关键直觉:多租户隔离像「一栋楼里每户独立水电表」——任务内参数管「这户用多少」,容器 / 调度管「这户不能被邻居拖垮」。两层一起才有真正的互不影响。
⚠️ 常见坑:只靠 channel 限制却没限制 JVM 堆,一个大任务仍可能把整机内存吃满触发 OOM 拖垮同机其他租户;进程级资源上限(容器 / cgroup)必须与 channel 限制配合使用。