8.1 与阿里云DataWorks等云平台集成
8.1 与阿里云DataWorks等云平台集成
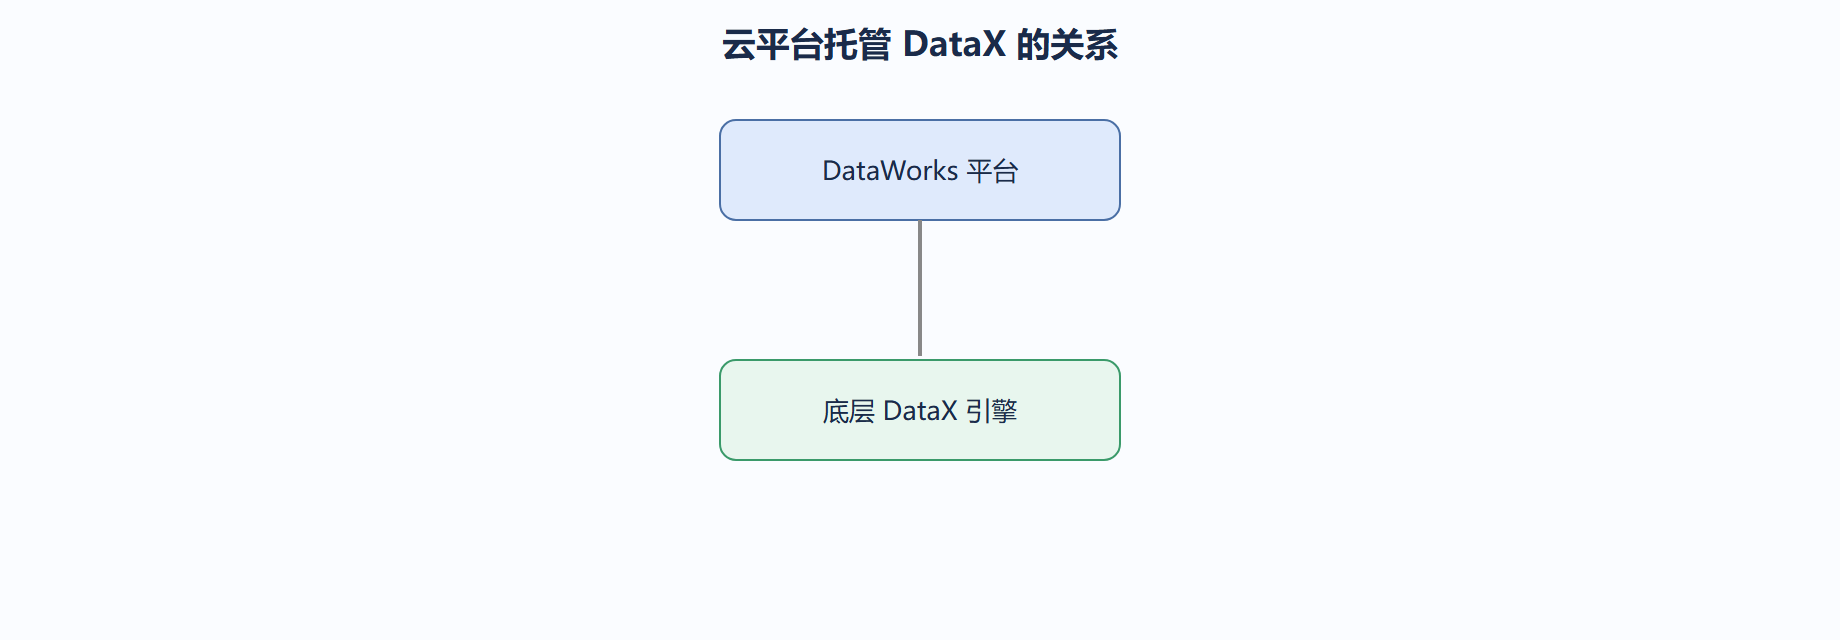
DataX 能力很强,但自己搭一套调度、监控、权限很费劲。云平台如阿里云 DataWorks 把 DataX 收编进托管服务,让同步变成界面上的点几下。
云平台做了什么
DataWorks 的「数据集成」模块底层就是 DataX 引擎。你在界面上选源、选目标、映射字段,平台生成同步任务并调度执行,日志、监控、告警都自带。它把第四章的 job.json 隐藏在向导背后,降低了上手门槛。
# 导出能力通常也能拿到底层 job 配置供审计
收益与代价
收益是免运维:不用管机器、不用管升级、出问题找云厂商。代价是绑定:任务逻辑、数据安全都进了厂商平台,迁移成本高。我们评估时把「是否接受绑定」和「团队运维能力」一起算,而不是只看功能。
何时上云
没有专职运维、任务量中等、数据本就在云上,上云最划算。若数据敏感、有合规要求、或已有成熟调度中台,自建 DataX 反而更可控。我们没有标准答案,只有「和自身运维能力匹配」这一个判据。
我们的经验
即便用云,我们也保留一份导出的 job.json 备份,防止厂商锁定导致无法迁移。工具可以托管,知识和配置不能托管给别人的黑盒。
锁定风险要防
云平台托管省运维,但任务逻辑、数据安全都进了厂商平台,迁移成本高。我们评估时把「是否接受绑定」和「团队运维能力」一起算,而不是只看功能。即便用云,我们也保留一份导出的 job.json 备份。
| 维度 | 自建 | 上云 |
|---|---|---|
| 运维 | 自己扛 | 厂商管 |
| 绑定 | 无 | 有 |
| 迁移 | 自由 | 成本高 |
我们没有标准答案,只有「和自身运维能力匹配」这一个判据。工具可以托管,知识和配置不能托管给别人的黑盒。
延伸与提醒
退出码接进调度系统,才能让失败在半夜被及时发现。
Web 平台解决协作与可观测,不提升同步能力本身。
Hive 表的分区设计直接影响下游查询性能,写入时就该想清楚。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
配置进版本库、密码进环境变量,是跨环境复用的基础。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
日志里周期打印的读写速率,是定位瓶颈的第一手材料。
writeMode 必须和数据更新语义对齐,不能凭感觉选。
关系型 Writer 的批量提交大小,要在往返开销和回滚成本间权衡。
querySql 与 column 二选一,混用会直接报错。
机器核数、内存、带宽三者共同决定 channel 的甜点值。
限速不是限制能力,而是给其他任务留出生存空间。
一张参数与吞吐的经验曲线,比任何通用公式都贴近你的环境。
测试样本先小后大,几分钟校验能省下几小时排错。
Channel 是有界缓冲,填满即触发反压保护内存。
调优的本质是在 CPU、网络带宽和磁盘 IO 之间找平衡点,不是堆资源。
orc 加 snappy 是 Hive 落地的常见稳妥组合,省空间且查询快。
生产环境的稳定性,常常取决于部署习惯而非某个高级特性。
任务可重跑幂等,是生产上线前的硬指标。
监控指标和 DataX 日志交叉看,能锁定九成瓶颈。
JVM 堆要给 Channel 缓冲留足空间,否则 GC 频繁拖慢吞吐。
脏数据阈值设得太高,会掩盖源端的数据质量问题,反而埋雷。
权限收得越紧,凭据泄露的爆炸半径越小。
preSql 里带 truncate 的任务,上线前必须二次确认目标表名。
把转换逻辑下推到源库,通常比在 DataX 内部处理更高效。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
反压机制保护内存,看到任务变慢应去优化下游而非加并发。
Redis 同步重跑要防重复 key,靠固定模板才能幂等。
星型拓扑把 N 乘 M 的对接降到 N 加 M,变更成本随之下降。
splitPk 的列若分布不均,分片会倾斜,部分 Task 拖慢整体。
源库索引评审应作为同步查询上线的前置环节。
channel 数超过源端连接承受能力时,瓶颈会从 DataX 转移到数据库。
数据湖贴源层保留原始形态,方便后续 schema 演化。
把复杂 join 留在计算引擎,DataX 只做贴源搬运。
任务的读写速率差,比绝对速率更能说明瓶颈在哪一段。
把 DataX 当搬运工而非加工车间,链路才简单可排查。
自定义插件最容易踩的坑是依赖冲突,provided 范围能治本。
插件目录名必须和 job.json 的 name 完全一致,大小写都不能错。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
多租户隔离交给编排层,DataX 保持简单最稳妥。
Reader 和 Writer 互不知晓,正是插件能独立扩展的原因。
全量基线加增量补充,是批流配合的常见稳妥组合。
Web 平台解决协作与可观测,不提升同步能力本身。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
Redis 同步重跑要防重复 key,靠固定模板才能幂等。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
云平台导出的底层配置,本质仍是 job.json。
{ "job": { "content": [{ "reader": { "name": "mysqlreader" }, "writer": { "name": "hdfswriter" } }] } }
背景
阿里云 DataWorks 等平台把 DataX 作为底层同步引擎,用户在点选界面里配置,平台翻译成 job 下发执行。理解这种关系,能让你在云上与自建之间无缝迁移。
操作:平台任务等价的自建 job
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "connection": [ { "jdbcUrl": ["jdbc:mysql://rds:3306/order"], "table": ["t_order"], "splitPk": "id" } ], "column": ["id","user_id","amount"] } }, "writer": { "name": "odpswriter", "parameter": { "datasource": "odps_demo", "table": "t_order", "partition": "dt=20240101", "column": ["id","user_id","amount"] } } } ], "setting": { "speed": { "channel": 8 } } } }
启动命令
# 自建环境直接跑;在云平台上则是由「同步节点」后台调用等价的 datax python bin/datax.py job/order_to_odps.json
结果解读
云平台的「数据集成 / 同步节点」底层多基于 DataX 改造:你点选的源、目标、字段映射,会被渲染成 job.json 交给执行引擎。因此,你在自建 DataX 上积累的 job 编写经验,能直接迁移到云平台的「高级 / 脚本模式」。区别仅在于:云上由平台托管调度、鉴权与资源,自建要自己搭这一层。
变式
同一份 reader 逻辑,writer 换成云仓库(如 MaxCompute / 对应云数仓的 writer),即可上云;反过来,云上导出的 job 也能在自建 DataX 上跑(只要插件齐备),实现混合云架构。
集成形态对照
| 形态 | 调度 | 资源 | 适用 |
|---|---|---|---|
| 自建 DataX | 自带 / crontab | 自管 | 私有化 |
| 云平台 | 平台托管 | 云管 | 快速上线 |
| 混合云 | 统一调度 | 两端 | 渐进迁移 |
💡 关键直觉:云平台是把 DataX「托管化」——执行内核没变,变的是谁管调度、谁发凭据、谁配资源。懂了内核,你就有了在云上与自建之间自由迁移的底气。
⚠️ 常见坑:把云平台的「点选生成 job」当成黑盒,一旦同步异常不会看底层配置;建议切到脚本 / 高级模式对照生成的 job.json,平台报错往往能在原生配置里找到对应根因。