4.3 动态信息获取与多源整合
多源是幻觉吗
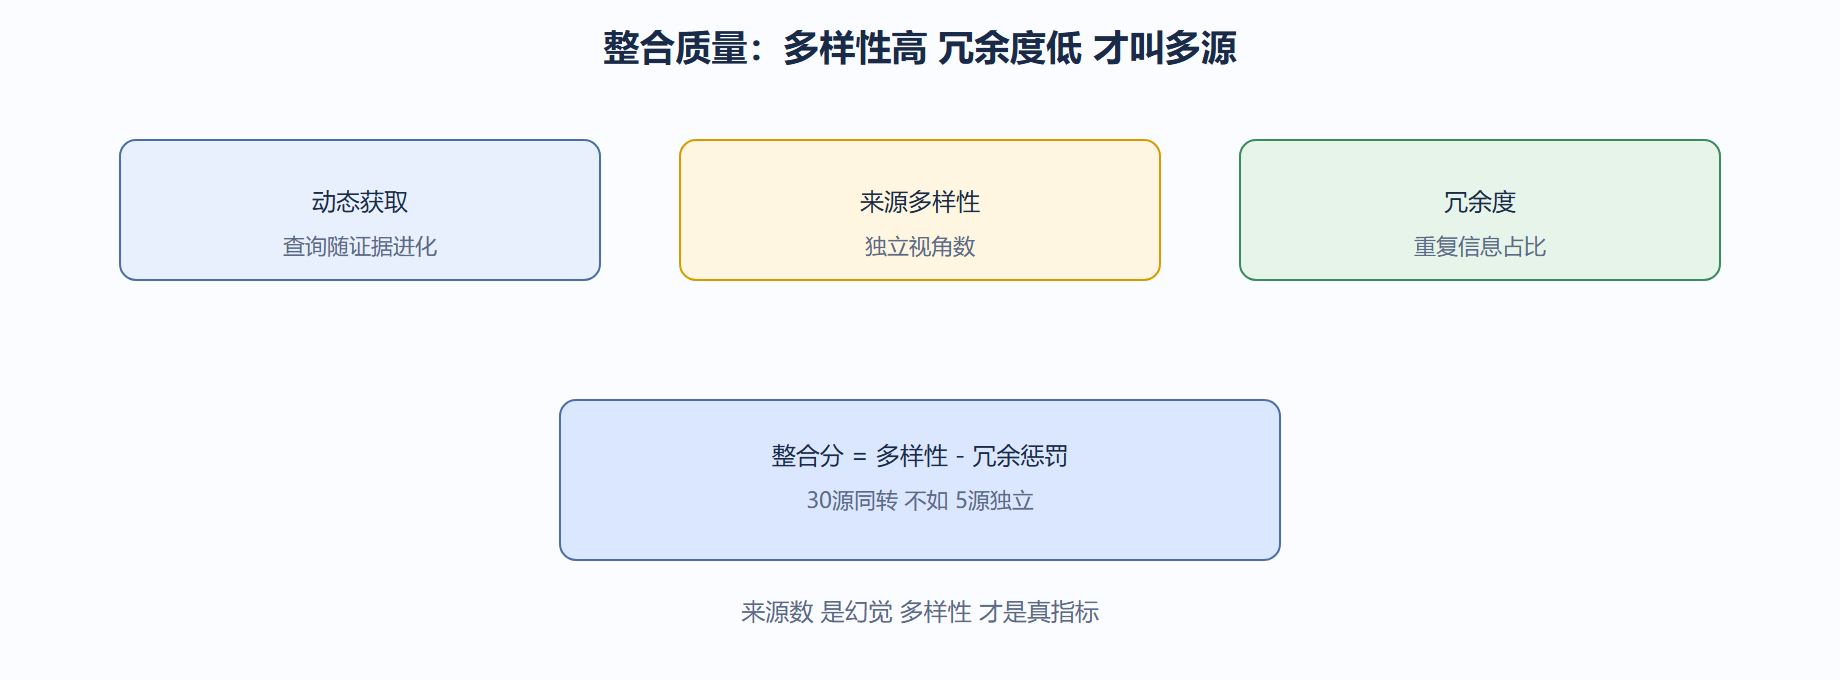
本节在评估章的第三站:动态获取与多源整合。全册里这对应检索(3.3)与综合(3.4),现在看怎么量"整得好不好"。一个反例:系统吐出 30 条来源,看着很"多源",实则 28 条是同一篇的转载,整合质量为零。整合评估的核心不是来源数量,而是来源多样性与信息冗余度。
动态获取指系统会根据已读内容调整后续检索(3.3 的查询进化)。评估动态获取,看"后续查询是否由新证据驱动"——若全程用同一句查询,说明没在动态学。整合评估看两指标:冗余度(重复信息占比,越低越好)与多样性(来源独立视角数,越高越好)。下面用代码把两者合成一个整合分。
# 整合质量评估:多样性高、冗余低 才得高分 def integration_score(sources: list) -> float: # sources: 每源含 viewpoint 标签(学术/官方/媒体/社区) total = len(sources) distinct_views = len(set(s["viewpoint"] for s in sources)) redundancy = 1.0 - distinct_views / total # 视角越单一 冗余越高 diversity = distinct_views / 4.0 # 封顶4类视角 return round(0.6 * diversity + 0.4 * (1 - redundancy), 2) # 运行示例 echo_chamber = [{"viewpoint": "media"}] * 30 # 30源 同一视角 balanced = [{"viewpoint": "学术"}, {"viewpoint": "官方"}, {"viewpoint": "media"}, {"viewpoint": "community"}] print(integration_score(echo_chamber), integration_score(balanced)) # 0.08 1.0
运行输出 0.08 与 1.0。30 个同源只拿 0.08——数量是幻觉;4 个独立视角拿满分。这个分直接打脸"多源即可靠"的直觉,也呼应 3.3 的三角验证:要的是独立印证,不是来源计数。
我们主张:整合评估必须报告"视角构成"而非"来源总数"。工程上,整合层在去重(2.4)之外还要做"视角标注",否则多样性无从算起。评估报告里附一张视角分布表,比附三十个链接更有用。
动态获取的评估可量化成"查询-证据契合度"。若后续查询含前一轮新出现的术语(如 3.3 的"临床前"),说明在动态学;若始终重复首句,说明僵化。下面演示:
# 动态获取评估:后续查询是否引入新证据术语 def dynamic_gain(initial_q: str, later_qs: list, new_terms: list) -> float: hits = sum(1 for q in later_qs if any(t in q for t in new_terms)) return round(hits / max(len(later_qs), 1), 2) print(dynamic_gain("量子 药物", ["量子 药物 临床前", "量子 药物 分子模拟"], ["临床前", "分子模拟"])) # 1.0 全由新术语驱动
输出 1.0,说明后续查询完全由新证据术语驱动,动态获取到位。若得 0,查询没进化,系统是在机械重复。
完整案例:背景→操作→结果→解读→变式
- 背景:某舆情报告列 50 源,读之发现全是同一营销稿的转载,视角单一。
- 操作:用
integration_score评估,发现视角全为"媒体",分仅 0.08。 - 结果:重抓官方与社区源补足视角,分升至 0.8,报告出现对立解读。
- 解读:整合分暴露了"多源幻觉",逼出真正的多样性。
- 变式:若任务本就是"传播态势监测",单一视角反而是信号,此时
diversity口径改为"覆盖传播节点数",指标语义随目标翻转,详见 1.1。
4.4 看它在答不出时,敢不敢说不知道——诚实,是可被评估的。
冗余度是怎么算出来的:从重复率到信息熵
4.3 用"视角多样性"和"冗余度"衡量整合质量。冗余度更精细的算法是看信息熵:若 N 条来源讲的事几乎一样,熵低、冗余高;若各讲各的角度,熵高、冗余低。用金融组合比喻——十只股票同涨同跌,组合分散度为0;十只各不相关,分散度最高。整合质量看的是"信息分散度"而非"条数"。
下面演示用简单信息熵估计来源间的冗余:
# 信息熵估冗余:视角越集中 熵越低 冗余越高 import math from collections import Counter def redundancy_of(viewpoints: list) -> float: n = len(viewpoints) if n == 0: return 1.0 cnt = Counter(viewpoints) probs = [c / n for c in cnt.values()] entropy = -sum(p * math.log(p, 2) for p in probs) max_e = math.log(len(cnt), 2) if len(cnt) > 1 else 1.0 norm = entropy / max_e if max_e > 0 else 0 return round(1 - norm, 3) # 冗余 = 1 - 归一化熵 # 运行示例 print(redundancy_of(["media"]*30)) # 1.0 全同 完全冗余 print(redundancy_of(["学术","官方","社区","媒体"])) # 0.0 四视角独立 无冗余
运行输出 1.0 对 0.0——30 个同源视角冗余拉满,4 个独立视角零冗余。这和 4.3 的 integration_score 结论一致,但用熵给"冗余"一个更平滑的度量,能区分"30 同源"和"5 同源加2 异源"这种中间状态,而前者只能给 0/1 两档。
| 来源构成 | 熵冗余 | 整合分直觉 | 处置 |
|---|---|---|---|
| 单一视角×N | 1.0 | 差 | 补异源 |
| 两视角各半 | 中 | 中 | 尚可 |
| 多视角独立 | 0.0 | 优 | 直接采用 |
💡 关键直觉:整合质量的敌人是"看似多、实则一"。熵的视角告诉我们,多样性不是"数量",是"分布的平坦度"。哪怕只有 4 个来源,只要彼此独立、视角互补,熵冗余就趋零,整合分拉满——这再次印证 3.3"要独立印证不要来源计数"。
⚠️ 常见坑:用"去重后的条数"代替"冗余度"。去重只去掉完全相同,却放过了"换措辞讲同一观点"的软重复。两条来源文字不同、核心主张一致,熵仍低、冗余仍高。所以整合层除了 2.4 的字段去重,还要做"主张级聚类"(见 3.4),否则软重复会伪装成多样性骗过高分。