- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
你有没有过这样的经历:要写一份行业分析,先搜二十个关键词,再点开三十篇网页,把有用的段落贴进文档,最后花一下午才拼出一份勉强能看的初稿?真正消耗你的不是写作,而是"找证据—判断真假—连成逻辑"这条链路。Deep-Researcher 这类深度研究智能体,干的就是把这条链路自动化。
本教程不把它当成黑盒来吹,而是把它拆开:它怎么把模糊问题拆成可执行的子任务,怎么在真实的、会变的互联网里检索和阅读,怎么判断"证据够了没有",又怎么把零散信息合成一份有出处、敢说"我不确定"的报告。我们主张一个判断——研究智能体的价值不在模型多大,而在架构能不能让模型在不确定环境里持续纠错。
全册 33 篇,分六章。第一章建立统一心智模型,第二章看系统如何组装,第三章讲清背后的算法与训练,第四章讨论它到底"能力"到哪、怎么评估,第五章落到部署与场景,第六章谈趋势与伦理。无论你是想自己搭一个、在团队里用起来,还是只是想看懂别人家的产品,这套材料都够用。
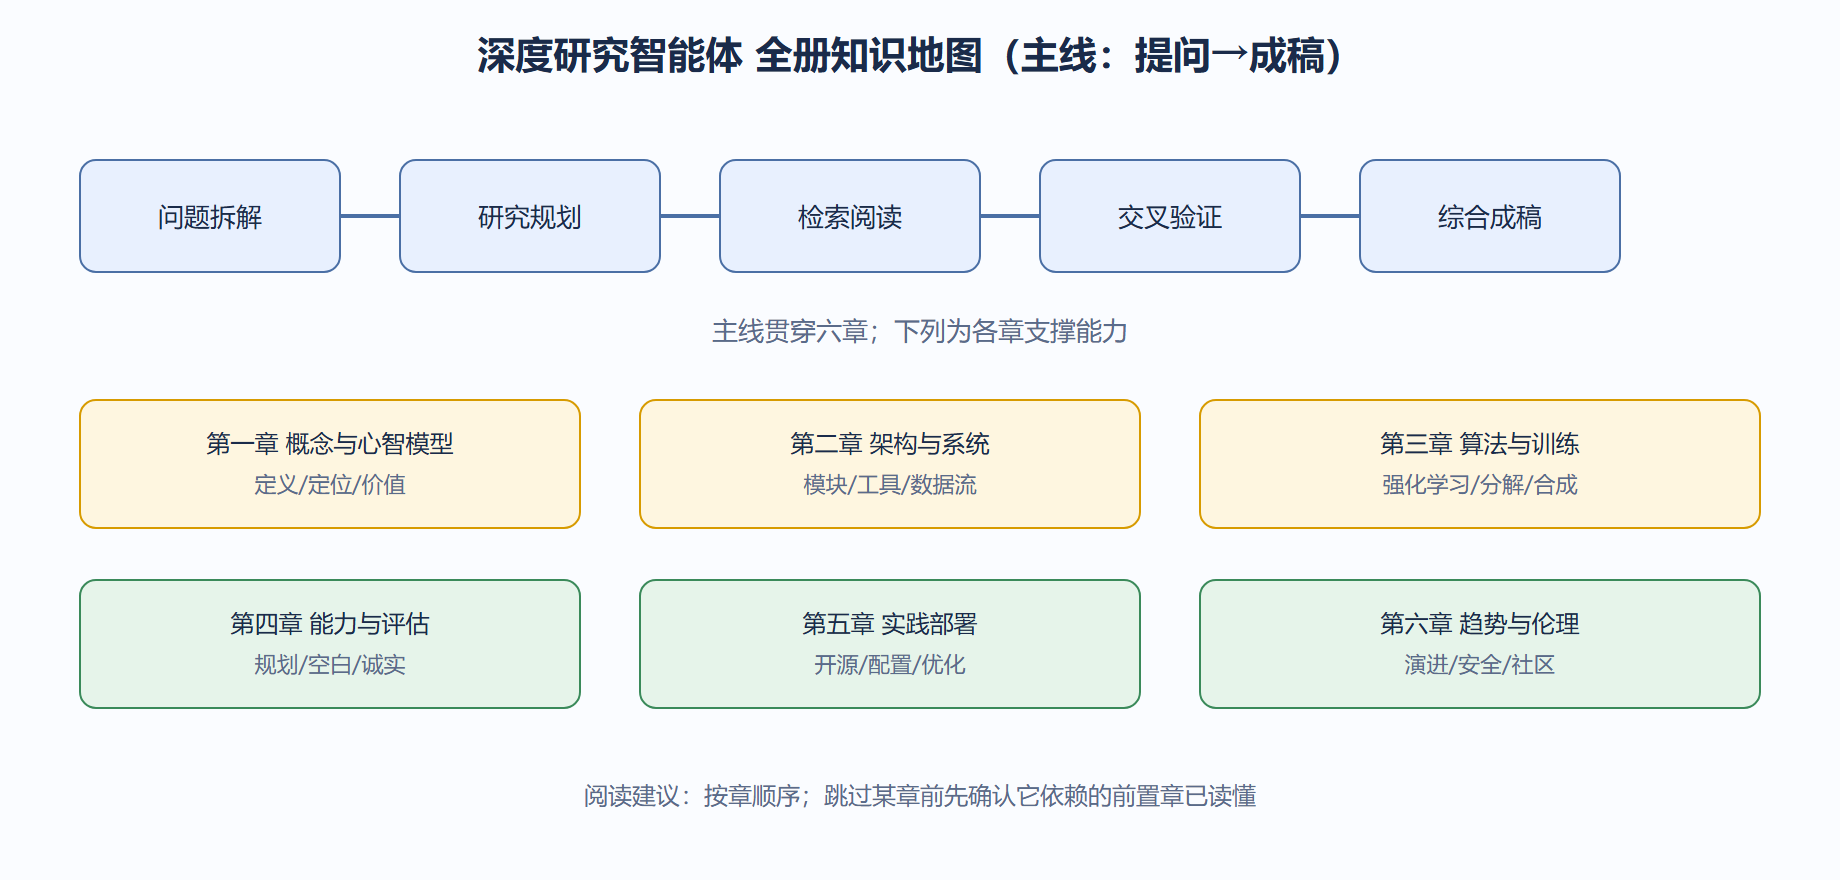
我们为什么用"深研智能体实战"作为叙事主调?因为市面上讲研究智能体的材料,要么停留在架构图层面,要么只给一段跑不通的 demo。本教程的写法相反:每一章都从"你会遇到什么真实麻烦"入手,再用可运行的代码和能复现的案例把麻烦拆掉。你不需要先成为强化学习专家,但读完后应当能独立判断一个研究智能体方案到底靠不靠谱。
各章衔接关系如下。第一章回答"它是什么、为什么值得做",是后面所有讨论的地基;第二章把系统拆成可替换的模块,你会在这一章拿到一张"哪里能换模型、哪里必须接工具"的地图;第三章进入算法核心,解释为什么在真实互联网里训练、任务如何被递归拆细;第四章给你一把尺子,能量它"研究得够不够好";第五章负责把前面三章接回地面,讲怎么部署、怎么省钱、哪里会踩坑;第六章把视线拉长,看它会往哪走、又带来哪些必须正视的问题。
给工程读者的三点提醒。第一,别把"能联网搜索的聊天机器人"和研究智能体混为一谈——差别在闭环:前者搜完就答,后者会判断证据够不够、不够就回头再搜。第二,模型规模不是天花板,架构与奖励设计往往更关键,本地小模型配好循环也能打过云端巨模型在长任务上的表现。第三,诚实性是可以被训练出来的:当奖励函数惩罚"编造且无法验证"的陈述,智能体自然学会区分已知事实、合理推断和待验证假设。
我们建议的学习路径:先把第一章和第二章连读,建立"模块—职责"的直觉;随后第三章和第四章对照看,算法和评估本是同一件事的两面;第五章和第六章可按需跳读。每一节开头都会点明它在全册中的位置,方便你随时回看上下文。
最后说一句实在话:这套材料不能让你立刻训出一个超过人类分析师的系统,但能让你少走半年弯路——知道哪些坑是架构选错,哪些坑是数据不够,哪些坑根本不该由智能体背。带着"我要解决一个具体问题"的心态来读,收获最大。
这套材料适合谁、能带走什么
适用人群大致三类。一类是工程师,想在团队里落地一个研究助手,读完后能照着第二章的模块图搭出最小可用系统,并知道哪些旋钮在第五章调。二类是产品与管理角色,不写代码也要会判断一个方案算不算真研究智能体,第一章的定义筛和第四章的评估表就是给你用的尺。三类是学生与研究者,想看懂论文里"会研究"的宣称到底兑现了几成,带着 1.3 的历史坐标和 4.5 的指标去读,不会被宣传带偏。
学完你能具体带走五样东西:
| 带走的能力 | 对应章节 | 可验证的表现 |
|---|---|---|
| 一句话说清研究智能体定位 | 第一章 | 向同事指出某产品缺了闭环哪一块 |
| 画出可替换的架构图 | 第二章 | 标出哪里换模型、哪里必须接工具 |
| 改奖励函数影响行为 | 第三章 | 调一个参数复现诚实性变化 |
| 用量化尺子评系统 | 第四章 | 搭出覆盖/特异性/校准三维表 |
| 本地跑通并控制成本 | 第五章 | 给出一份混合部署与成本方案 |
💡 关键直觉:本教程反复强调"架构与奖励比模型规模更关键",所以你不必等算力到位才开始——用本地小模型配好循环,长任务上也能打过云端巨模型。带着"我要解决一个具体问题"的心态读,收获最大;只读不练,等于看了地图没上路。
⚠️ 常见坑:别把"能联网搜索的聊天机器人"当研究智能体。差别就在闭环——前者搜完即答,后者判断证据够不够、不够回头再搜。用第一章那段四格判定函数筛一遍行为日志,比看产品宣传靠谱得多。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...