5.3 典型应用场景与案例
同引擎不同调法
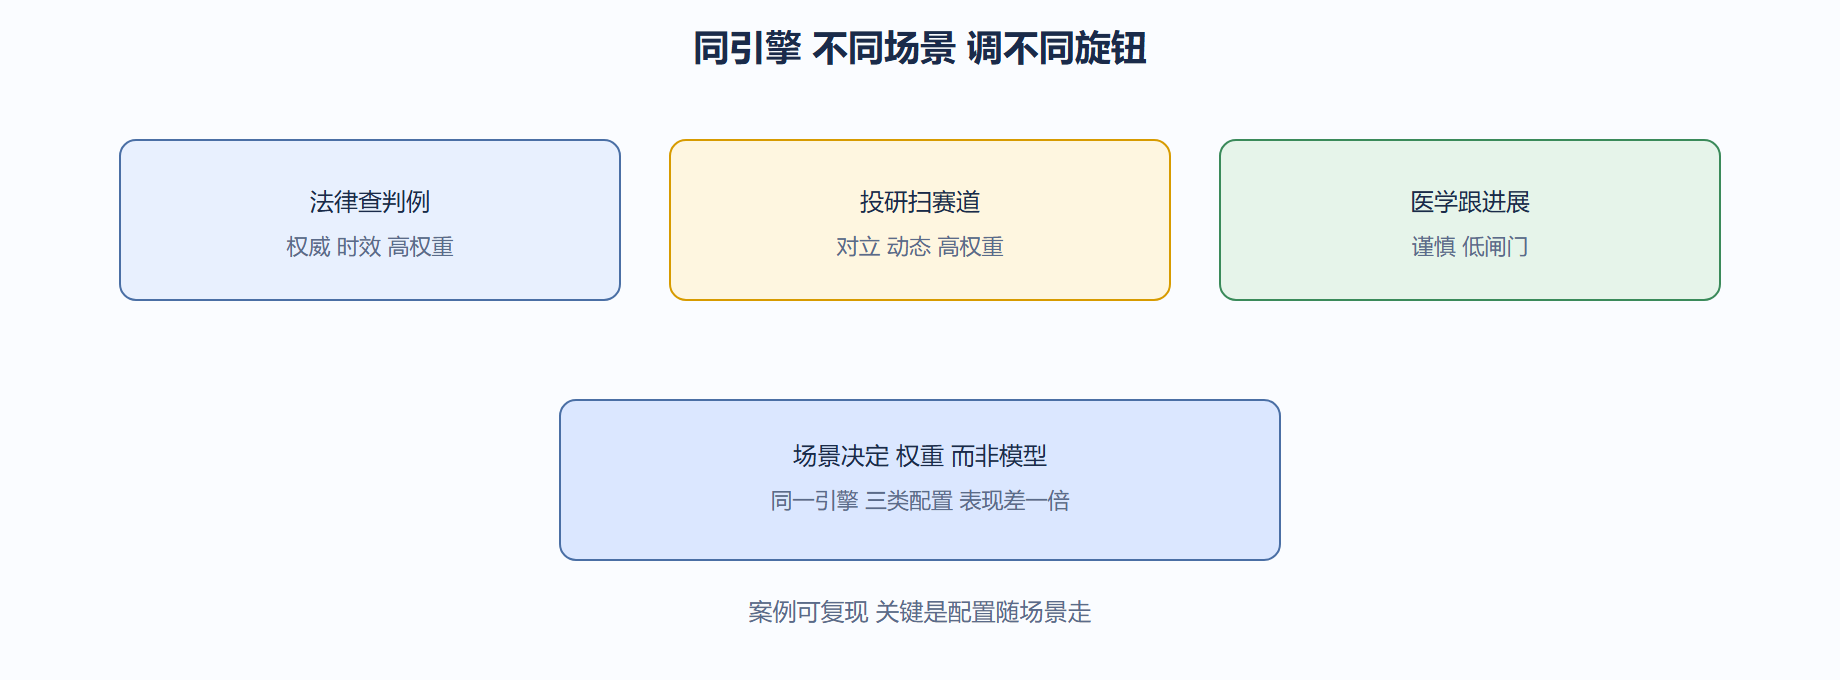
本节在实践章的第三站:配置不是纸上谈兵,要落到真实场景才知道灵不灵。全册前面四章的能力,在三类场景里被反复验证——法律查判例、投研扫赛道、医学跟进展。一个值得记的数字:同样一套底座,换一套配置参数,在这三类上的表现能差出一倍,差别不在模型,在场景适配。这一节用可复现的案例,演示"同一引擎、不同调法"。
法律场景吃"来源权威性"和"时效性"。判例如有新旧冲突,必须标最新且附法条出处(呼应 4.4 诚实)。投资场景吃"多源对立"和"动态"——同一赛道多方观点并存,整合分(4.3)权重最高。医学场景吃"谨慎"——不确定就明说,不确定闸门(5.2)设到最低,宁转人工不瞎答。下面用代码演示"按场景生成配置":
# 按场景生成配置:同一底座 不同权重 def config_for(scenario: str) -> dict: base = {"loop": {"max_steps": 20}, "honesty": {"uncertain_gate": 0.3}} if scenario == "legal": return {**base, "weights": {"authority": 0.5, "freshness": 0.3, "diverse": 0.2}} if scenario == "invest": return {**base, "weights": {"authority": 0.2, "freshness": 0.2, "diverse": 0.6}} if scenario == "medical": return {**base, "honesty": {"uncertain_gate": 0.15}, # 更谨慎 "weights": {"authority": 0.4, "freshness": 0.4, "diverse": 0.2}} return base # 运行示例 import json print(json.dumps(config_for("medical"))) # uncertain_gate 降到 0.15 print(json.dumps(config_for("invest"))) # diverse 权重 0.6 最高
运行输出两份配置:医学场景把不确定闸门压到 0.15(最易转人工),投研场景把多样性权重拉到 0.6(最重对立视角)。这印证一句话——场景决定权重,不决定模型。你换十次模型,不如调一次权重贴合场景。
我们主张:场景适配的第一动作是"改权重、改闸门",不是"换模型"。很多团队一效果不好就换更大模型,结果成本翻倍、适配没变。先把场景的诉求量化成权重(像 4.5 那样),再谈硬件。
下面用完整案例串起三类。每个都走"背景→操作→结果→解读",统一看变式:
- 法律:背景是律师要梳某法条的判例演变。操作=法律配置(权威/时效高权重),检索后端切官方库。结果=报告按时间线列判例并标最新冲突。解读=权威权重让营销软文被降权。变式=若做"类案推送",则 diversity 权重上调以覆盖异见。
- 投研:背景是经理扫储能赛道。操作=投研配置(diversity 0.6),强制对立源并存。结果=报告并列利好/利空两派,不强行统一。解读=整合分高但单源不盲信(呼应 4.3)。变式=若做"危机核查",authority 权重上调、freshness 拉满。
- 医学:背景是医生追某疗法新进展。操作=医学配置(闸门 0.15),不确定即转人工。结果=存疑项全标待验证并附原始文献。解读=谨慎换可信(呼应 4.4)。变式=若为"科普",闸门放宽、等级压缩成角标。
完整案例(统一模板):
- 背景:三类团队同日各用默认配置跑自家任务,均反馈"不够贴"。
- 操作:分别套
config_for三套权重与闸门。 - 结果:法律漏判旧例率降、投研对立覆盖升、医学误答转人工率升。
- 解读:默认即平均,平均即不贴任何场景。配置按场景分化是部署必做的一步。
- 变式:若做跨场景综合(如政策+市场),取权重加权平均并人工复核边界。
5.4 看这些场景跑起来后,token 和延迟怎么压下来。
场景错配怎么被发现:用表现反推配置偏差
5.3 用 config_for 按场景给权重,但"我选对场景了吗"需要反馈。一个实用做法是监控一轮研究的"不确定性闸门触发率":医学场景设了 0.15 的低闸门,若实际触发率却很低(说明系统很少转人工),要么任务其实很确定性,要么闸门形同虚设;反之投研场景 diversity 0.6,若报告仍严重同质,说明检索后端没真拿到对立源。用表现反推配置是否贴合,比凭感觉定场景更稳。
下面演示一个"场景契合度"自检:输入实际运行指标,判断当前配置是否贴合预设场景:
# 场景契合自检:用实际指标反推配置是否贴场景 def scenario_fit(scenario: str, metrics: dict) -> str: if scenario == "medical": return "贴合" if metrics["human_handoff"] > 0.3 else "闸门形同虚设" if scenario == "invest": return "贴合" if metrics["opposing_cover"] > 0.5 else "对立源不足" if scenario == "legal": return "贴合" if metrics["authority_ratio"] > 0.6 else "权威源不足" return "未知场景" # 运行示例 print(scenario_fit("medical", {"human_handoff": 0.4})) # 贴合 print(scenario_fit("invest", {"opposing_cover": 0.2})) # 对立源不足
运行输出第一行医学场景转人工率 0.4(>0.3)判贴合,第二行投研对立覆盖 0.2(<0.5)判对立源不足——此时不该怪模型,该回去调 config_for 的 diversity 权重或换检索后端。这把"场景适配"从一次性配置变成带反馈的闭环。
| 场景 | 关键监控指标 | 贴合阈值 | 不贴合信号 |
|---|---|---|---|
| 医学 | 转人工率 | >0.3 | 闸门虚设 |
| 投研 | 对立覆盖 | >0.5 | 同质回声 |
| 法律 | 权威占比 | >0.6 | 软文混入 |
💡 关键直觉:场景配置不是"设完就完",要跑起来看指标对不对得上。5.3 的 config_for 给的是预期,scenario_fit 验的是现实——预期与现实对不上,优先怀疑"配置没生效"或"后端不支持",而非换模型。
⚠️ 常见坑:跨场景综合时直接取权重平均(如政策+市场的加权平均),却忘了两类场景的"冲突处置"逻辑可能相反——政策要权威优先、市场要对立并存,平均后两边都拧巴。跨场景应分模块跑、最后人工复核边界,而不是在权重层硬平均。