2.3 数据类型系统与兼容性
2.3 数据类型系统与兼容性
为什么一张表读出来字段类型会漂移
本篇是第 2 章第 3 节,也是原理章收尾,解释跨源类型对齐的机制,是后面写 SQL 和清洗时的必备常识。
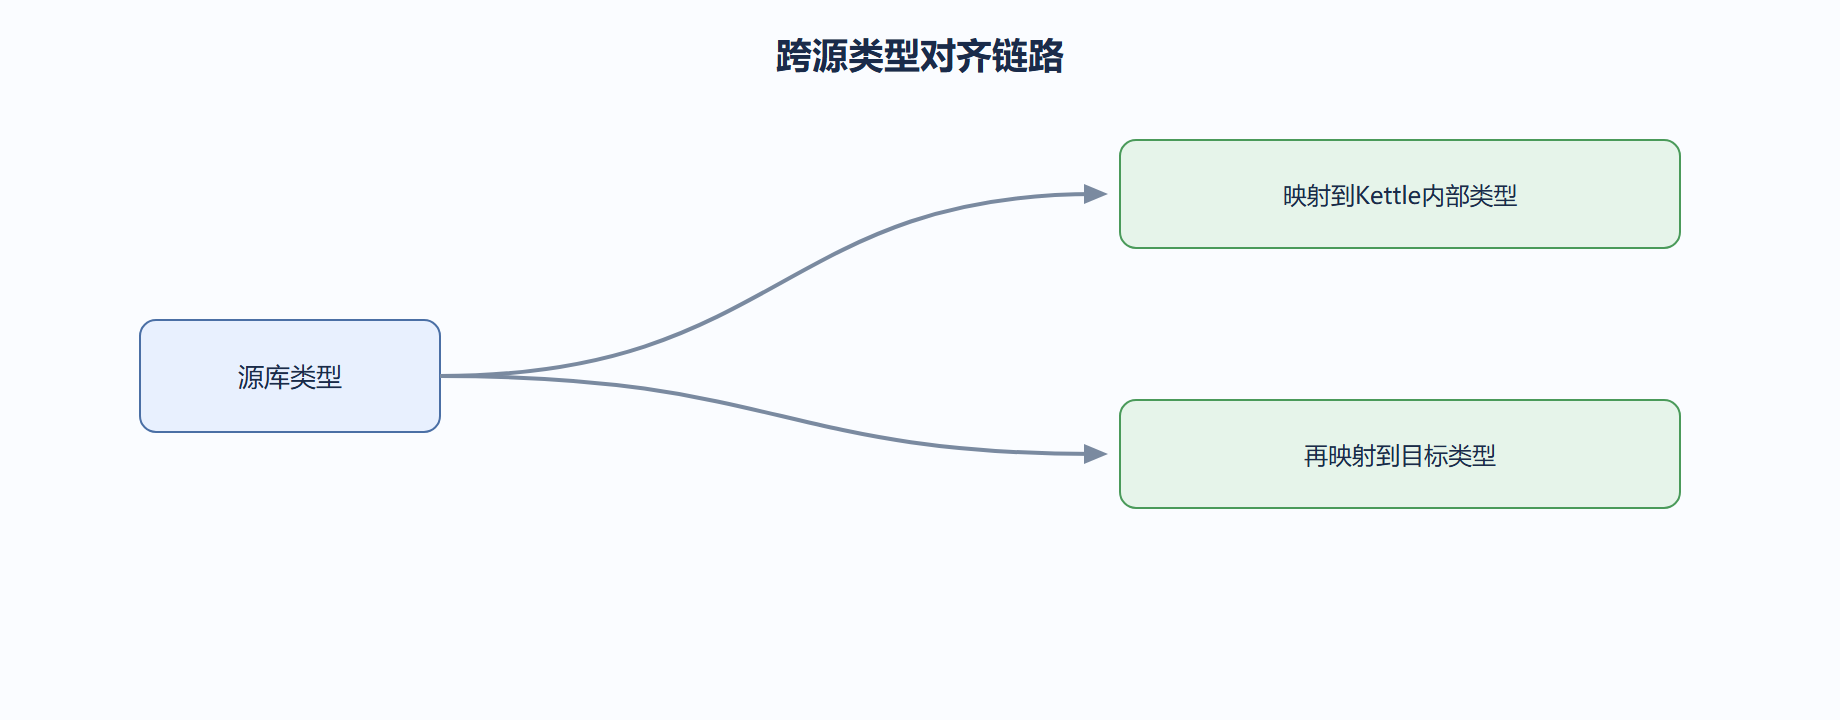
Kettle 内部有一套自己的类型体系:字符串、整型、数值、日期、布尔、二进制等。当它从一个数据库读数据时,会把源类型映射到这套内部类型;写向目标时再反向映射。我们遇到最多的问题是「Oracle 的 NUMBER 没有标度,被当成浮点,写进 MySQL 多了小数位」。
日期类型是重灾区。不同数据库对时区、精度的处理不同,Kettle 默认按连接里的会话时区解析。我们有一次跨国同步,源库存 UTC、目标存东八区,没显式指定转换,结果时间整体偏移八小时。后来在「表输入」SQL 里统一用 CONVERT_TZ,才消除漂移。
字符串长度也要当心。Kettle 内部字符串理论上不限长,但目标库有 VARCHAR(50) 之类约束,超长会截断或报错。我们在「字段选择」步骤显式设置输出长度,让错误在转换内就暴露,而不是等写到库才失败。
兼容性上,Kettle 通过 JDBC 驱动认类型,所以驱动版本很关键。我们固定每个连接使用的驱动 jar,避免升级后类型映射变了引发静默错误。这是运维层面容易忽略、却反复咬人的点。
还有「宽松类型」的诱惑:图省事把所有字段读成字符串,清洗时再转。这能避开很多映射坑,代价是失去数据库端的类型校验,且数值比较会按字典序出错。我们只在临时探查时用这招,正式管道坚持按真实类型走。
关键代码与配置
下面这段 sql 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
-- 在表输入里先把类型钉死,避免 Kettle 猜测 SELECT CAST(id AS DECIMAL(18,0)) AS id, CAST(amount AS DECIMAL(18,2)) AS amount, CONVERT_TZ(created_at,'UTC','+08:00') AS created_at FROM src_orders
与其让 Kettle 推断,不如在 SQL 层显式 CAST。我们把这段写进每个表输入,类型漂移类故障下降明显。
<step><name>字段选择</name><type>SelectValues</type> <fields> <field><name>amount</name><type>Number</type><length>18</length><precision>2</precision></field> <field><name>name</name><type>String</type><length>50</length></field> </fields> </step>
字段选择能强制输出类型与长度,相当于给下游一份契约。我们把它放在转换靠前的位置,让后面的步骤都基于稳定类型工作。
背景
财务对账发现 Kettle 同步后的金额比源库多了零头,差了几分钱级别,但累计对账不平。
操作
我们追到「表输入」把 NUMBER 映射成了双精度浮点,再经多次运算引入浮点误差。
-- 修正:用定点小数承载金额 SELECT CAST(amount AS DECIMAL(18,2)) AS amount FROM src_orders
结果
改为 DECIMAL 后,零头消失,对账完全平了。
解读
根因是浮点表示的固有误差被累加。金融类数值绝不能用浮点搬运,这是类型系统里最贵的一课。
变式
若源端本就是字符串金额,则应在「字段选择」里直接转 Number 定点,并加「校验数值」步骤拦截非法串,双保险。
常见误区与工程取舍
误区:金额用浮点。永远用 DECIMAL/定点,否则对账迟早出问题。
误区:忽略时区。跨时区日期必须显式转换,别依赖默认会话。
取舍:临时探查可全读字符串图省事;正式管道坚持真实类型,换取数据库端校验。
回到工程现场,我们处理 2.3 数据类型系统与兼容性 时最忌讳只看单点性能而忽略端到端链路。2.3 数据类型系统与兼容性 的真实代价往往藏在步骤之间的缓冲与序列化里,而不是某一步骤本身。我们在多次压测中验证过这一点,并把对应的监控指标固化进自动化巡检脚本。当数据量翻倍时,瓶颈位置常会转移,因此不要把一次观测结论当成永久真理。
深入:跨源类型怎么对齐
Kettle 内部有一套类型系统(String、Integer、Number、Date、Boolean、Binary 等),它负责在「各数据库/文件格式的类型」与「Kettle 内部类型」之间做映射。麻烦在于:同一个 Date,在 Oracle 是 DATE、在 MySQL 是 DATETIME、在 CSV 里只是一串文本,Kettle 要用「格式掩码」把它们统一。字符集更是重灾区——源是 GBK、目标是 UTF-8 时不显式声明,中文就乱码。字段选择步骤里的「类型」与「格式」两列,就是你对齐跨源类型的控制面板。
<field> <name>create_time</name> <type>Date</type> <format>yyyy-MM-dd HH:mm:ss</format> <!-- 与源数据实际格式一致,否则解析失败 --> <encoding>UTF-8</encoding> </field> <!-- 类型/格式/编码三件套决定了跨源对齐是否干净(输入:异构源;输出:统一内部类型) -->
⚠️ 常见坑(数据类型)
- 忽略字符集:源 GBK、目标 UTF-8 不声明,中文乱码到下游才爆发。
- 日期格式掩码写错:格式不匹配直接报解析异常或悄悄变成 null。
- 数值精度丢失:BigDecimal 类金额用 Number 默认精度可能截断,需显式指定。
💡 关键直觉
- 类型对齐发生在「边界」:每跨一个源/目标就是一次映射,越多的异构源越要在输入口就统一。
- 字段选择步骤是「类型治理第一关」,在它里面把类型、格式、编码定死,下游才省心。
| 源类型 | Kettle 内部 | 易错点 |
|---|---|---|
| Oracle DATE | Date | 格式掩码 |
| CSV 文本 | String→转型 | 编码、分隔符 |
| MySQL DATETIME | Date | 精度/时区 |