- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Kettle 数据 ETL 工具使用与实战
这套教程到底在解决什么
我们写这本教程,起点是一个反复出现的现场困境:数据散在十几个源里,需求方明天就要一张干净的对账表,而你手里只有一堆拼凑的脚本。脚本能跑,但没人敢改、出错了查不动、换个人就接不住。Kettle 要解决的正是这个「能跑但不可持续」的痛。
全册知识地图
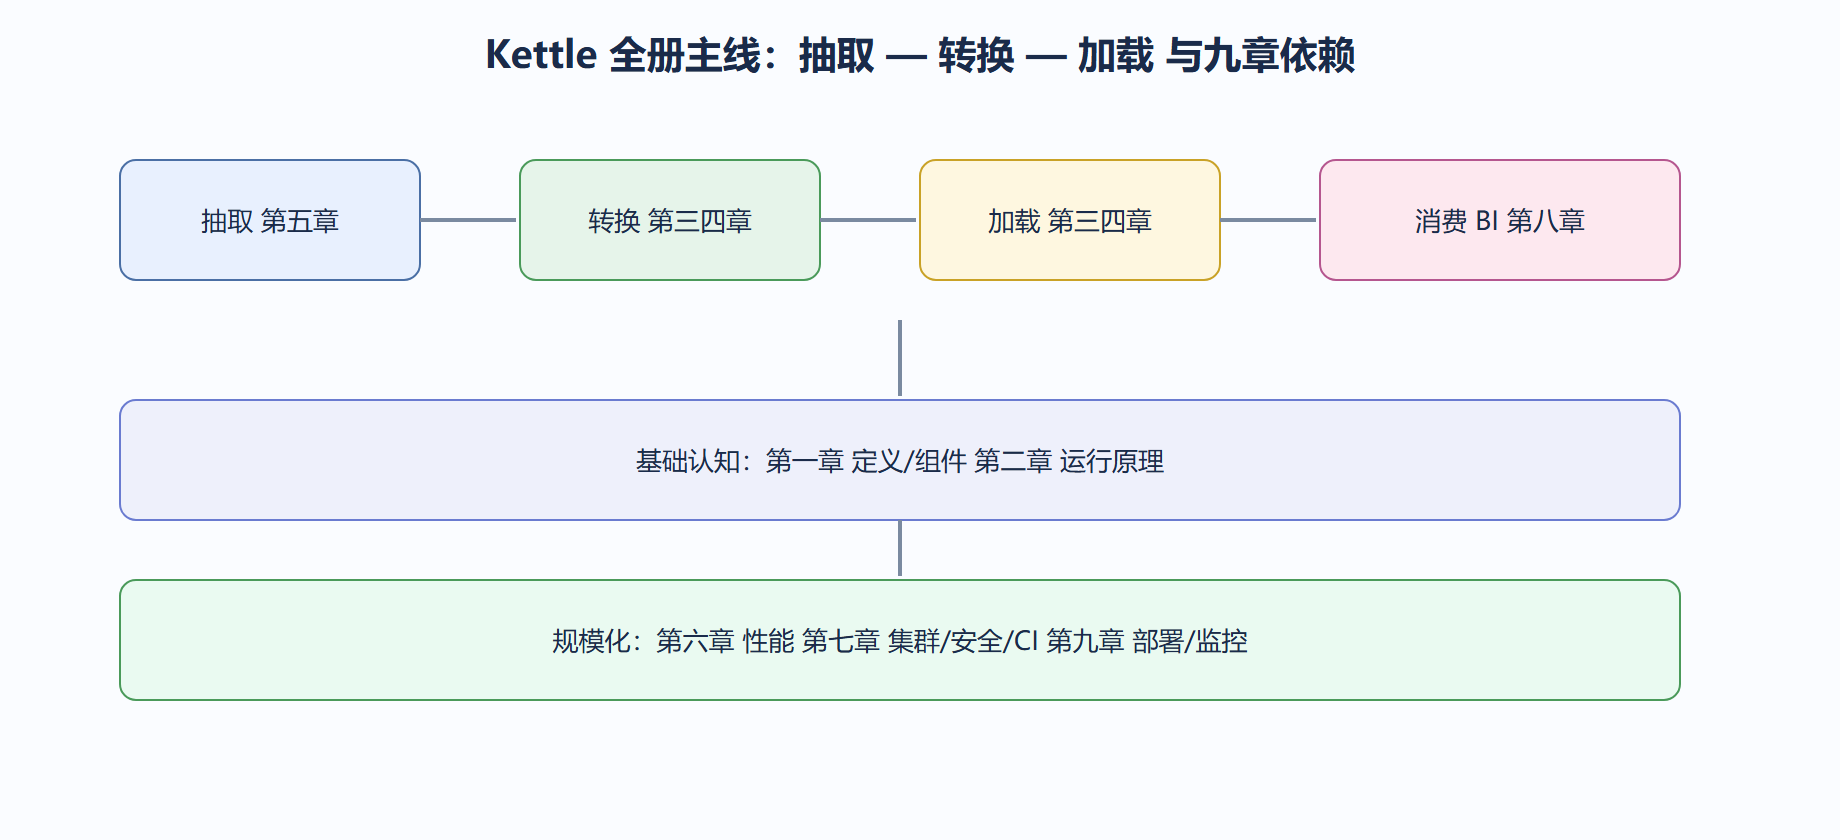
下面这张图给出主线与九章的依赖关系,建议你随时回看,知道自己在哪一层。
我们坚持的写法立场
第一,讲因果不堆概念。每节开头先点明它在全册体系里的位置,再解释「为什么这样设计」。第二,用工程取舍代替绝对优劣——Kettle 不是银弹,实时场景它力不从心,我们会在对应章节把边界说清。第三,案例完整:背景、操作、结果、解读、变式五段齐备,让你照着能复现、改了能预判。第四,配图与代码不缺席,转换链、架构分层、作业依赖都用图示,SQL、XML、Shell、JavaScript 片段都带输入输出说明。
给不同起点的读者
如果你刚接触 ETL,建议从第一章顺着读到第九章,九章顺序本就是循序渐进。如果你已会画简单转换、卡在性能或生产化,可直奔第六章与第九章。如果你要做平台集成,第八章给你与 Hadoop、云、BI 衔接的切实路径。无论哪条路,遇到陌生步骤,记得第十章(9.6)给出的读源码与沉淀片段习惯,那是把本书变成你团队资产的那一步。
这套教程的打开方式
读这套教程前,先确认环境就位:一台能跑 Java 8 及以上版本的机器、解压即用的 Kettle 发行包(社区版目录名通常为 data-integration)、以及一个可用的数据库用于练习。我们强烈建议你不要只在图形界面里点点点,尽早用命令行 Pan 与 Kitchen 把同一个转换和作业各跑一遍——生产环境里它们才是真正的执行入口,图形界面只是设计与调试的画布。本册所有案例基于 Kettle 8.x 的行为描述,核心概念在新旧版本间基本稳定,但菜单名称可能略有差异,请以你本地版本为准,遇到偏差时以官方帮助文档的术语为锚。
一个贯穿全册的最小例子
我们把「按天同步一张订单表,并把状态码翻译成中文」作为反复出现的练习线索:第三章把它画成转换,第四章把它编成作业,第五章确保连接稳妥且凭据安全,第六章在数据量大时把排序下推、把装载改批量,第九章把它部署到生产并配上监控。跟着这条线走完,你得到的不是零散知识点,而是一套可迁移的方法——接到任何「把 A 处的数据变成 B 处干净数据」的需求,都知道先拆成抽取、转换、加载三段,再判断哪段该用转换、哪段该用作业。
为什么我们坚持配图与代码并重
纯文字容易让人「以为懂了,一上手就卡」。所以我们每个关键概念都配一张图和一段可直接复制运行的代码或配置;图与代码不是装饰,而是让你在不动手时也能建立正确心智模型的脚手架。你会在全册看到大量 ktr 片段(转换的 XML 元数据)、SQL、Shell 启动命令与 JavaScript 清洗脚本,它们都带输入与输出的注释,方便你照着复现并预判改动后果。
遇到困难时怎么用本册
当你在某个步骤报错,先别急着搜网页,回看对应章的「常见坑」小节——我们把高频踩坑按「现象—根因—解法」整理好了。如果属于性能问题,直接跳第六章看瓶颈定位流程;如果属于生产化问题,跳第九章。这种「按问题回查」的读法比从头翻快得多。我们也刻意让每章支柱页带上速查清单,方便你贴在工作台旁当备忘。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...