3.2 数据输入步骤
3.2 数据输入步骤
数据从哪进:输入步骤的百宝箱
本篇是第 3 章第 2 节,承接结构,专门盘点「数据怎么进来」,这是任何转换的第一块砖。
最常用的是「表输入」,用一条 SQL 从数据库拉数据。我们习惯在 SQL 里就把类型钉死、把过滤下推到库端,而不是拉全表再在 Kettle 里筛,这样网络和时间都省。下推过滤是输入步骤的核心心法。
「文本文件输入」读取 CSV/TXT,支持正则文件名、头部跳过、编码指定。我们对接第三方导出时,常让他们按约定命名每天一个文件,用通配符一次吃进多天数据,再用「获取文件名」步骤先枚举再循环。
「JSON 输入」和「XML 输入」适合接口返回。我们用「HTTP 输入」拉接口、再用「JSON 输入」按路径抽取字段。注意大报文要限制单次拉取量,否则内存爆。我们给接口类输入都加了分页参数。
「表输入」还有个隐藏技巧:勾选「替换变量」后,SQL 里的 ${var} 会被参数替换,配合「从步骤获取变量」可以实现「每读一行参数、跑一次子转换」的循环抽取。我们用它做按门店逐店拉数的场景。
输入步骤要特别声明字符集和分隔符,中文环境默认 GBK 的文件若按 UTF-8 读会乱码。我们所有文本输入都显式指定编码,并在测试库放一份含生僻字的样本做冒烟。
关键代码与配置
下面这段 sql 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
-- 表输入:过滤下推到库端,只取需要的天和字段 SELECT id, user_id, amount, created_at FROM src_orders WHERE created_at >= '${p_start}' AND created_at < '${p_end}'
下推过滤让数据库先裁掉无关行,Kettle 只搬运必要数据。我们禁止在表输入写 SELECT * 再靠步骤筛,那是典型的资源浪费。
<step><name>文本输入</name><type>CSVInput</type> <file><name>/data/in/*.csv</name></file> <encoding>UTF-8</encoding> <delimiter>,</delimiter> <header>Y</header> </step>
通配符 + 显式编码 + 跳过头,是文本输入的稳健三件套。我们对第三方文件都先小样验证分隔符再批量跑。
背景
合作方导出 CSV 是 GBK,我们按默认 UTF-8 读,中文姓名全变问号,导致后续按姓名去重失效。
操作
在「文本文件输入」步骤显式设编码为 GBK,并加「字段选择」校验长度。
<step><name>文本输入</name><type>CSVInput</type> <encoding>GBK</encoding> <field><name>name</name><type>String</type><length>64</length></field> </step>
结果
姓名正确还原,去重恢复正常,数据质量校验通过。
解读
根因是编码假设错误。输入步骤的编码声明不是小事,跨系统对接第一关就是字符集,我们后来把它写进接入 checklist。
变式
若源头编码不固定,可在前置作业里用「执行脚本」调用 iconv 统一转 UTF-8,Kettle 内部只认一种编码,运维更简单。
常见误区与工程取舍
误区:表输入 SELECT *。应下推过滤与投影,减少搬运量。
误区:忽略编码。跨系统文本必须显式声明字符集,否则中文乱码。
取舍:接口大数据要分页;文件多天用通配符;都为了稳和快。
深入:输入步骤的取舍与参数化
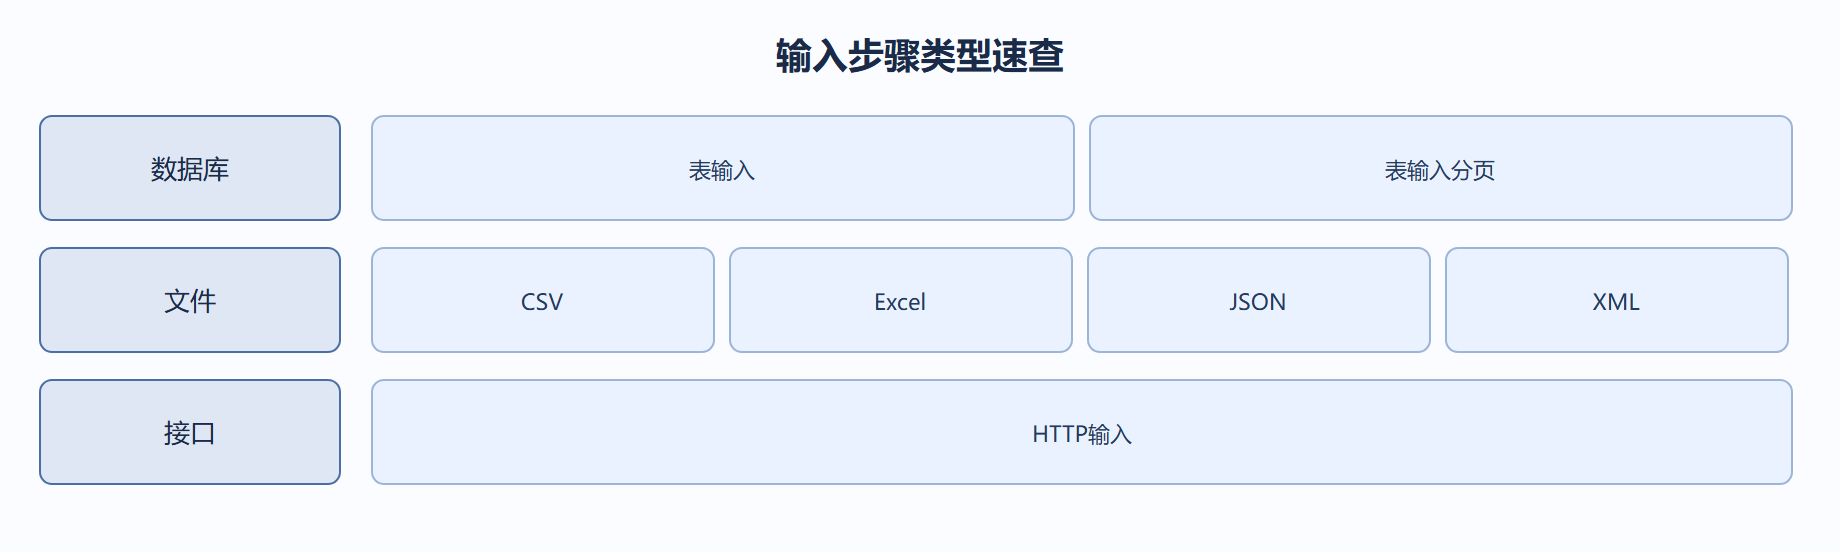
输入步骤决定了「数据从哪来、以什么形态进管道」。表输入最常用,但务必用 ${参数} 做增量抽取,否则每次全量拉全表,量大时直接拖垮源库。文本文件输入要盯紧分隔符、编码、字段类型推断;JSON/XML 输入需要你写路径表达式抽取字段;HTTP 输入则用于拉接口数据,要处理分页与认证。一个共同原则:输入的字段名、类型、编码在入口就定死,下游才不用反复补偿。
-- 表输入做增量抽取(输入:源表带时间字段;输出:前一天变更行集,供下游清洗) SELECT id, amount, status, update_time FROM src_orders WHERE update_time >= TO_TIMESTAMP('${p_day}','YYYY-MM-DD') - INTERVAL '1' DAY AND update_time < TO_TIMESTAMP('${p_day}','YYYY-MM-DD'); -- ${p_day} 由 Kitchen 注入,做到「同一文件每天换参复用」,避免为每天另存 ktr
⚠️ 常见坑(数据输入)
- 不做增量:全量抽取把源库读爆,增量靠时间字段+参数。
- 编码声明缺失:文本文件中文乱码,输入口就要定 UTF-8。
- 字段类型推断错:金额被推断成 Integer 丢小数,输入处显式指定类型。
💡 关键直觉
- 输入的干净程度决定下游的复杂度:入口治理好,下游少写十个补救步骤。
- 参数化是复用的命根子:一个
.ktr靠${p_day}等变量每天跑,文件零拷贝。
| 输入方式 | 适用 | 关键点 |
|---|---|---|
| 表输入 | 关系库 | 增量+参数化 |
| 文本/CSV | 文件 | 分隔符+编码 |
| JSON/XML | 半结构 | 路径表达式 |
| HTTP | 接口 | 分页+认证 |
工程实录:增量抽取救活源库
全量抽取一张亿级表,每次把源库读爆,业务查询被拖死。
表输入用时间字段加 ${p_day} 做增量,每天只取前一天变更。
SELECT id, amount, status FROM src_orders WHERE update_time >= TO_TIMESTAMP('${p_day}','YYYY-MM-DD') - INTERVAL '1' DAY AND update_time < TO_TIMESTAMP('${p_day}','YYYY-MM-DD');
源库压力从全表扫描降到一天增量,业务不再受影响。
增量是输入步骤的第一原则,参数化让其每天复用。
无时间字段时用自增 id 或 CDC 日志做增量。
参数与阈值速查
| 增量方式 | 适用 | 注意 |
|---|---|---|
| 时间字段 | 有 update_time | 时区一致 |
| 自增 id | 只增不改 | 漏改数据 |
| CDC | 强一致 | 源支持 |