3.4 数据输出步骤
3.4 数据输出步骤
数据最终去哪:输出步骤的出口管理
本篇是第 3 章第 4 节,也是转换章收尾,讲数据怎么落下去,直接关系到目标端一致性与性能。
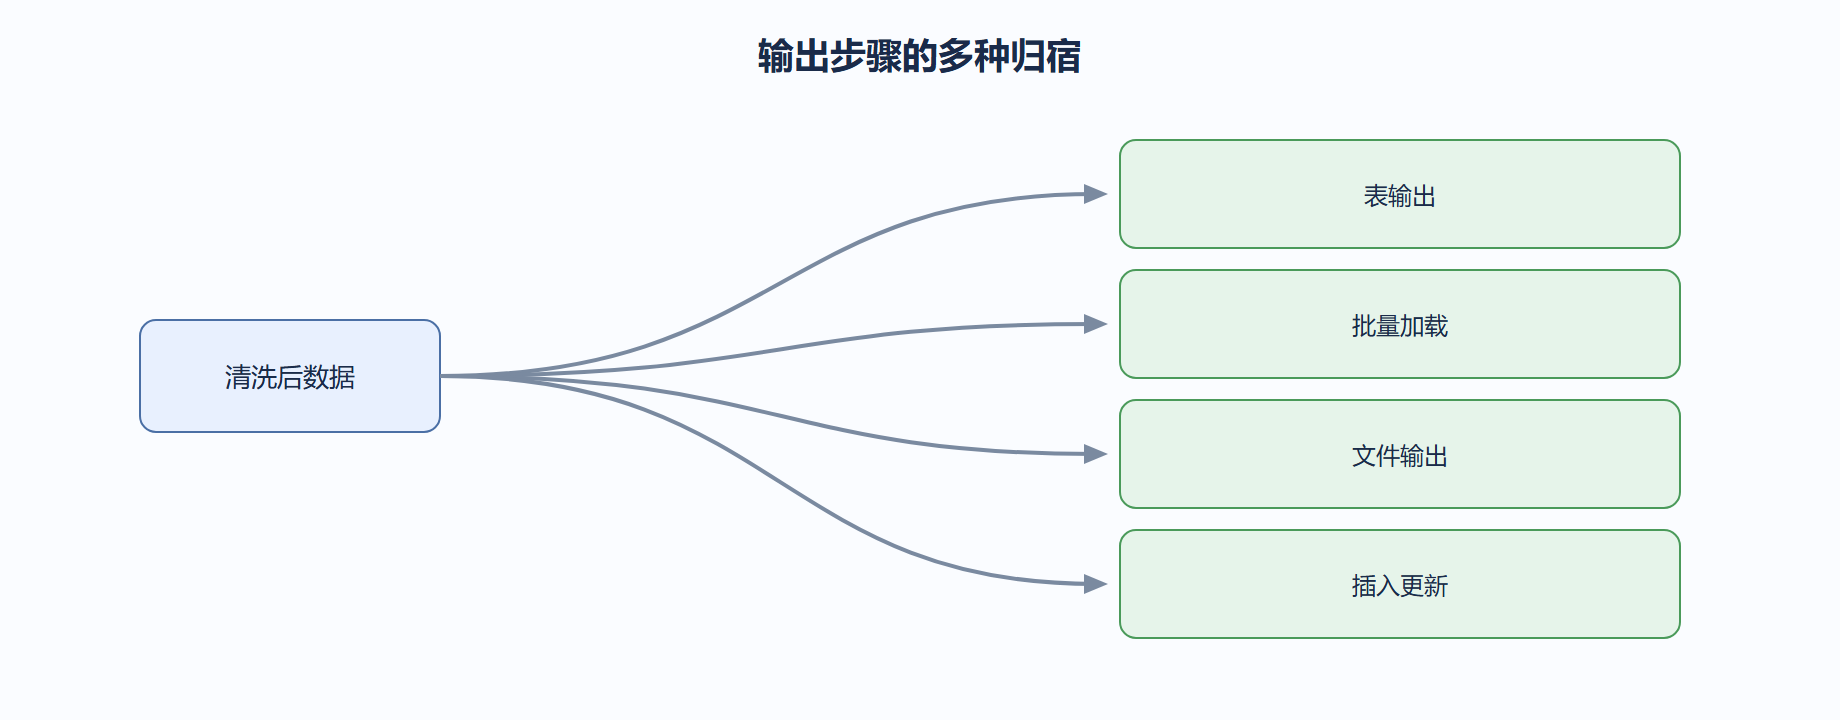
「表输出」写关系库,关键参数是批量提交大小。我们默认设 1000~5000,太小则频繁提交慢,太大则事务长、锁久。这个值和行集、内存要一起调,是性能章节的常客。
「插入更新」按关键字匹配后决定插入或更新,适合增量同步。但它每行都要先查再写,慢。我们只在无可替代时用;能先判增量区间再纯插入的场景,坚决不用它。
「文本文件输出」落 CSV,常用于给下游系统喂文件。我们写文件时固定编码、加日期后缀,并先写临时名再重命名,避免下游读到半截文件。这个「写临时再 rename」的小习惯救过多次。
「批量加载」步骤(如 MySQL 的 LOAD DATA、PostgreSQL 的 COPY)绕过逐行插入,速度数量级提升。我们大表初始装载一律走批量加载,日常增量才用表输出。代价是绕过了部分约束检查,所以前置清洗要更严。
输出还要注意目标表结构演进:加字段时,输出步骤的字段映射要同步。我们用「字段选择」在输出前对齐列,让输出步骤只管写、不管结构差异,这样改表时只动「字段选择」一处。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<step><name>表输出</name><type>TableOutput</type> <table>dwd_orders</table> <commit>2000</commit> <!-- 每2000行提交一次 --> <use_batch>Y</use_batch> <!-- 开启批量 --> </step>
批量提交 + 批量模式是表输出的加速双键。我们按目标库承压能力定 commit 值,并在压测中找拐点。
# 3.4 数据输出步骤 LOAD DATA LOCAL INFILE '/data/out/orders.csv' INTO TABLE dwd_orders FIELDS TERMINATED BY ','; # 比逐行表输出快约 10 倍
我们把「生成文件 + 批量加载」拆成两步:Kettle 负责出干净文件,数据库负责高速装载,各用所长。
背景
转换直接写最终名 CSV,某天下游调度比预期早触发,读到了还没写完的文件,解析报错一连串。
操作
改成先写 orders.csv.tmp,写完后再重命名为 orders.csv。
<step><name>文件输出</name><type>TextFileOutput</type> <file>orders.csv.tmp</file> </step> # 转换结束后由作业执行:mv orders.csv.tmp orders.csv
结果
下游永远只见到完整文件,半截文件问题消失。
解读
根因是「写可见」与「写完成」没分开。输出步骤的原子性要靠临时名+重命名保证,这是文件输出的铁律。
变式
若目标支持分区,可直接写带日期的分区文件,下游按分区消费,连重命名都省了,且天然幂等。
常见误区与工程取舍
误区:插入更新随便用。它慢在逐行查,能纯插入就别用它。
误区:直接写最终文件名。务必临时名+重命名,保证原子可见。
取舍:大装载走批量加载;日常增量走表输出,按量定手段。
深入:输出步骤怎么写才稳
输出步骤把管道结果落到目标。表输出最直接,但大批量时要开「批量提交」并关掉目标表索引/约束,写完再重建,速度可差一个数量级。插入/更新(Insert/Update)按关键字匹配,适合增量合并但比纯插入慢。文本文件输出要注意编码与换行符跨平台一致。一个常被忽略的点:输出前要确认字段顺序、类型与目标表对齐,并在作业里加「行数校验」步骤,防止空跑或翻倍写入。
<step> <name>表输出</name> <type>TableOutput</type> <table>dst_orders</table> <use_batch>Y</use_batch> <!-- 批量提交,大批量提速关键 --> <commit_size>10000</commit_size> <!-- 每 1 万行提交一次,平衡内存与事务 --> <truncate>N</truncate> </step> <!-- 输出落地(输入:清洗后行集;输出:dst_orders,批量 1 万行/事务) -->
⚠️ 常见坑(数据输出)
- 不开批量提交:逐行插入,大表写到天亮。
- 字段顺序/类型不对齐:写出报错或静默截断。
- 缺行数校验:空跑或翻倍写入无人察觉,污染下游。
💡 关键直觉
- 输出是「最后一公里」,前面再干净,写出翻车全盘皆输;批量+校验是铁律。
- 增量合并用 Insert/Update,全量刷新用 truncate+表输出,二者选型看幂等要求。
| 输出方式 | 适用 | 速度 |
|---|---|---|
| 表输出(批量) | 全量/大批量 | 快 |
| 插入/更新 | 增量合并 | 中 |
| 文本输出 | 文件交换 | 视编码 |
工程实录:批量提交救回写库
表输出逐行插入,百万行写到天亮。
开启批量提交,关目标表索引,写完再重建。
<step><name>表输出</name><type>TableOutput</type> <use_batch>Y</use_batch> <commit_size>20000</commit_size> </step>
写库从小时级降到分钟级。
批量+关索引是输出提速的两板斧,行数校验兜底。
增量合并用 Insert/Update,全量刷新用 truncate+表输出。
参数与阈值速查
| 方式 | 适用 | 速度 |
|---|---|---|
| 表输出批量 | 全量大批量 | 快 |
| 插入/更新 | 增量合并 | 中 |
| 文本输出 | 文件交换 | 视编码 |
现场口诀
输出环节记住一句话:「批量提交 + 行数校验 + 字段对齐」三件套,少了任何一个都可能半夜翻车。批量决定速度,校验决定正确,对齐决定不报错。三者齐备,输出才是可信的最后一公里。
输出后的对账:行数与金额双校验
输出写完不等于输出对。我们在作业里补一段对账:源端行数与目标端行数比对,数值型字段再比一次金额汇总。行数对得上但金额对不上,往往是字段类型截断或列错位——行数校验抓不到,金额校验能抓到。对账通过才通知下游,失败则告警并保留临时文件,避免坏数据先到下游、再返工的来回拉扯。配合前文的行数校验,输出这最后一公里才算闭环。