5.2 文件系统连接与管理
5.2 文件系统连接与管理
文件也是一种数据源,而且很挑剔
本篇是第 5 章第 2 节,承接数据库,扩展到文件类源,讲清本地、分布式、云存储的接入差异。
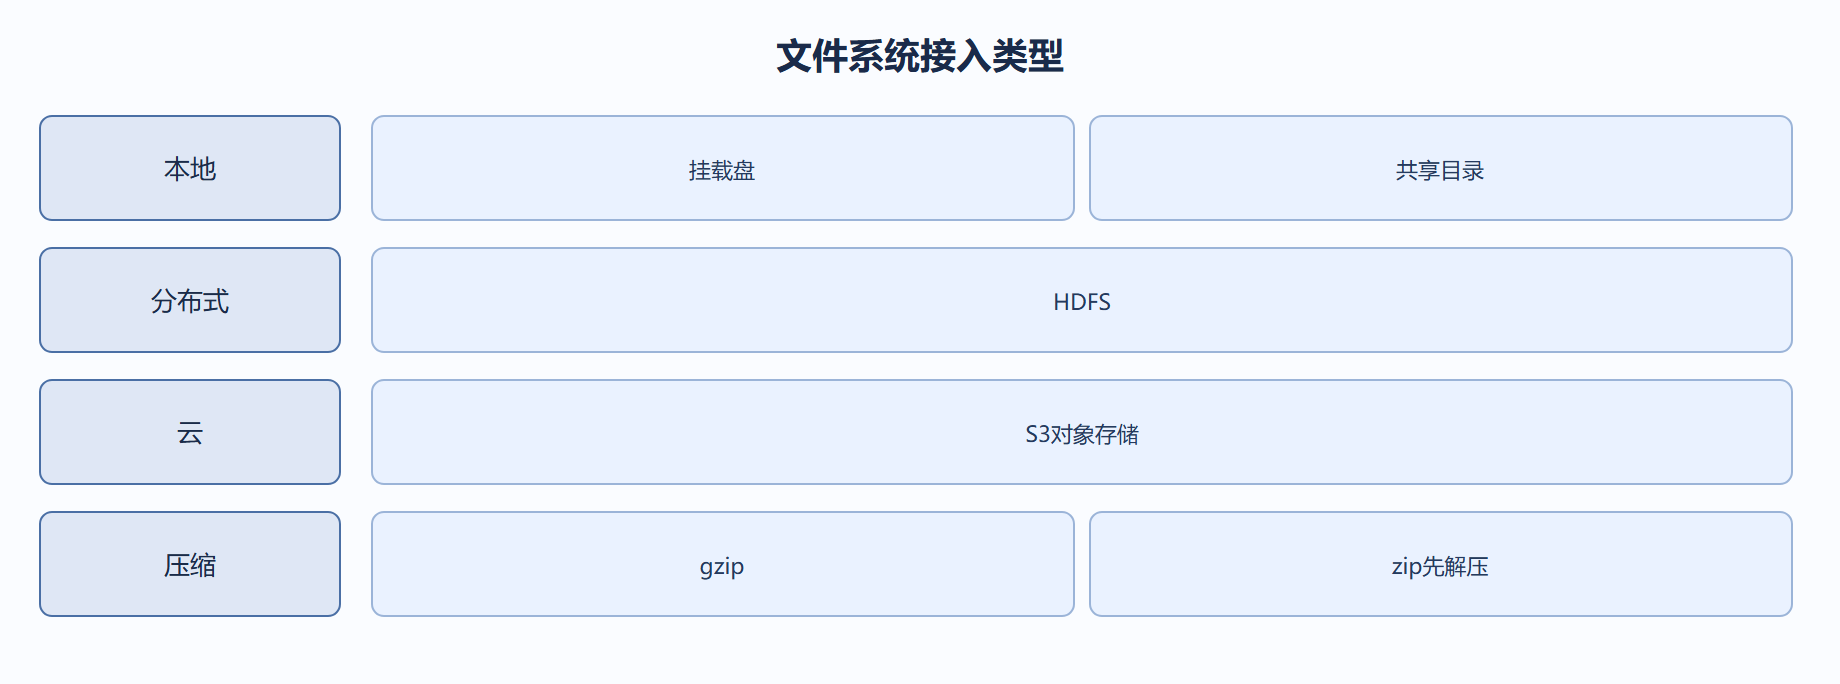
本地文件最简单,但生产上我们更常用共享目录或挂载盘,需留意权限和路径。Kettle 跑在服务器用户下,若对该目录无读权限,输入步骤会静默报错。我们给 ETL 账号统一授权并做冒烟。
HDFS 通过「Hadoop 文件输入」步骤接入,要配 core-site 和鉴权。我们处理日志类数据时大量读 HDFS,关键是把集群配置文件放进 Kettle 的 hadoop 目录,版本对齐,否则认证失败信息很隐晦。
对象存储如 S3 用「S3 文件输入」,凭据走 AccessKey 变量。我们数据湖的落地文件都在 S3,Kettle 读后再转换写回仓库。注意大文件用流式而非整块读,避免内存爆。
压缩文件要显式处理:gzip 可直接被输入步骤识别解压,但 zip 内含多文件需先「解压文件」步骤。我们对接方爱发 zip,所以作业开头固定放解压条目,解完再喂给转换。
文件 schema 漂移是隐患:对方加了一列,我们的「字段选择」若按位置取会错位。我们优先按列名映射,并加「校验文件结构」步骤,列不符就失败告警,而不是默默错位产出错数。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<step><name>HDFS输入</name><type>HadoopFileInput</type> <uri>hdfs://ns1/logs/access_${p_day}.log</uri> <hadoop_conf>/opt/kettle/hadoop/conf</hadoop_conf> </step>
HDFS 输入靠配置文件寻址。我们把 hadoop 配置作为环境的一部分固化,避免每次手动填,也减少出错。
# 5.2 文件系统连接与管理 cd /data/in && unzip -o orders.zip -d /data/stage/ # 转换随后读取 /data/stage/orders.csv
zip 多文件先解压再读。我们所有 zip 接入都走这道,避免输入步骤不认压缩包。
背景
合作方在 CSV 末尾加了一列,我们的「文本输入」按位置取字段,结果金额读成了备注,下游全错。
操作
改为按列名映射,并在作业里加「校验文件结构」步骤,列数不符即失败。
<step><name>校验结构</name><type>Validator</type> <expect_columns>id,user_id,amount,created_at</expect_columns> </step>
结果
加列当天作业直接失败告警,没产生错数,对方也被及时通知修正。
解读
根因是按位置取数太脆。文件接口必须按名取、且对结构做契约校验,schema 漂移才能被挡在门外。
变式
若对方 schema 经常变,可让接口先发一份 schema 描述,Kettle 动态生成映射,适应性更强但实现更复杂。
常见误区与工程取舍
误区:按位置取文件字段。必须按列名,并校验结构。
误区:zip 直接喂输入。先解压,多文件尤其要。
取舍:大文件走流式读;HDFS/S3 配置与版本要和环境对齐。
深入:文件类连接的细节雷区
文本/CSV 输入输出的坑集中在分隔符、编码、字段类型推断。分隔符别只用逗号——含逗号的字段要用引号或换分隔符;编码务必显式 UTF-8,Windows 默认 GBK 是乱码源头;类型推断常把金额判成 Integer 丢小数,要手动指定。Excel 输入注意表头行、sheet 名跨版本差异。文件路径用变量 ${p_root} 注入根目录,避免硬编码绝对路径导致换机失效。大文件优先流式读,避免一次性 load 进内存。
# 在作业/转换的「命名参数」或 kettle.properties 中定义: p_root=/data/etl/incoming # 这样同一套文件在 dev/test/prod 只需切换 p_root 与 p_day,无需改步骤配置
⚠️ 常见坑(文件系统)
- 分隔符默认逗号:字段含逗号时错位,需显式指定或加引号。
- 编码随环境:Windows GBK vs Linux UTF-8,必须显式声明。
- 绝对路径硬编码:换机器全失效,用
${p_root}变量化。
💡 关键直觉
- 文件步骤的「编码+分隔符+类型」三件套,是文件类连接 90% 问题的根源。
- 路径变量化让同一套文件跨环境零修改运行,是部署可移植的前提。
| 要素 | 易错 | 正确 |
|---|---|---|
| 分隔符 | 逗号冲突 | 显式/引号 |
| 编码 | 环境默认 | 指定 UTF-8 |
| 路径 | 绝对硬编码 | 变量注入 |
工程实录:文件编码之坑
Windows 开发的文件步骤到 Linux 全乱码,路径也找不到。
显式指定 UTF-8 与分隔符,根目录用 ${p_root} 变量化。
# kettle.properties 或作业参数定义 p_root=/data/etl/incoming # 文本文件输入路径写为 ${p_root}/orders_${p_day}.csv
同一套文件跨环境零修改运行。
编码+分隔符+类型三件套是文件连接九成问题根源。
大文件流式读,避免一次性 load 进内存。
参数与阈值速查
| 要素 | 易错 | 正确 |
|---|---|---|
| 分隔符 | 逗号冲突 | 显式/引号 |
| 编码 | 环境默认 | UTF-8 |
| 路径 | 绝对硬编码 | 变量 |
现场口诀
文件连接记住三件套:「编码 UTF-8、分隔符显式、路径变量化」。这三者搞定,文件类 90% 的乱码与找不到文件问题就消失了。路径用 ${p_root} 注入,同一套文件在 dev/test/prod 零修改运行,是部署可移植的前提。
文件生命周期:读走之后怎么办
文件接进来还要安排它的「后事」。我们按 incoming / processing / archive / failed 四层目录管理:新文件落 incoming,转换读取时移到 processing 防止重复处理,成功后转 archive 按天归档,失败进 failed 留待排查;再配保留策略(如 archive 保留 30 天自动清理),磁盘不会无限涨。文件移走后 incoming 空出来,下一轮作业只看到新文件,天然规避重复消费。
触发方式:定时扫描加 .ok 标记
文件任务的触发通常用「定时扫描 incoming」而非事件驱动,因为对方何时传完不可控。我们约定:对方先传 .ok 标记文件、再传数据文件,作业只在看到 .ok 时才认为本批完整,否则跳过等下一轮。相比「目录非空就开跑」,这能挡住传了一半的目录被误当完整批次。