9.2 监控与告警机制
9.2 监控与告警机制
管道没人盯,也得自己会喊疼
本篇是第 9 章第 2 节,承接部署,讲可观测性,是无人值守的底线。
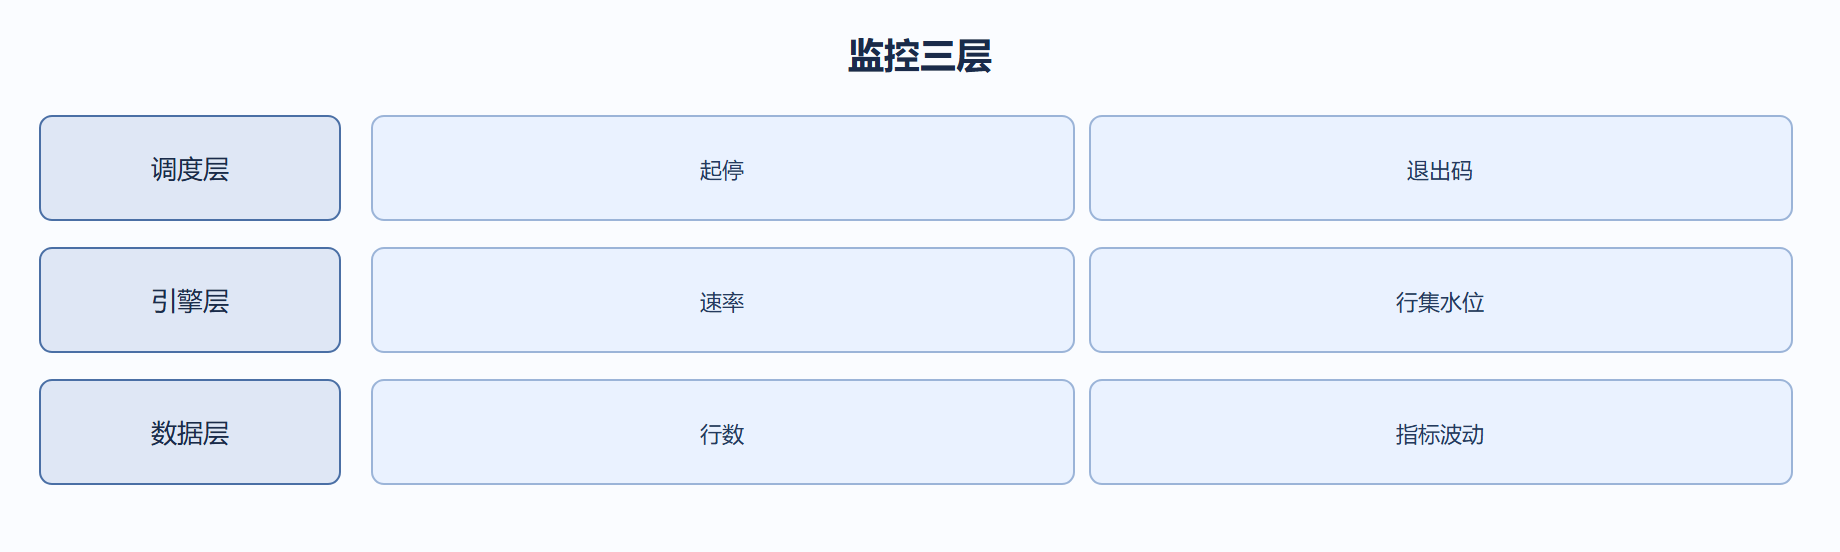
我们监控三层:调度层(作业是否按时起、退出码)、引擎层(步骤行数、速率、行集水位)、数据层(产出行数、关键指标波动)。只看第一层会漏掉「跑成功但数据错」的静默故障,所以我们强制三层都看。
行集水位和步骤速率来自 Detailed 日志,我们把它采集进时序库,画成曲线。某步骤水位持续满、某天速率骤降,都能从曲线一眼看出。这是第六章定位手段的常态化。
数据层校验最关键也最易被省。我们在作业末尾加「校验」步骤:比对源与目标行数、检查金额合计、判空。不达标则作业失败告警,把「成功但错」变成「明确失败」,运维反应快得多。
告警要分级:数据质量类立刻电话 oncall,延迟类工单跟进, informational 类只记日志。我们被「告警风暴」教训过——什么都告警等于没告警,分级后才有人真看。
可观测性还靠血缘。复杂管道用文档或工具记录字段从哪来到哪去,出问题时顺藤摸瓜。我们每个转换都配一张简易血缘说明,新人排错不用从零摸。
关键代码与配置
下面这段 sql 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
-- 作业末尾的数据质量校验(示例) SELECT COUNT(*) AS cnt FROM dwd_orders WHERE dt='${p_day}'; -- 若 cnt 与源端差异超阈值,则触发失败告警
行数比对是最 cheap 的质量闸。我们每个装载作业都带这道,差异超 1% 即失败,静默错数无所遁形。
# 9.2 监控与告警机制 pan.sh /file:job.ktr -level:Detailed 2>&1 \ | grep 'speed' >> /var/log/kettle_metrics.log # 由采集器读入时序库画图告警
把引擎指标变成时间序列,是监控从「看日志」升级到「看趋势」的关键一步。我们据此设动态阈值。
背景
某日作业退出码 0,但业务发现报表数字腰斩,排查才知源端分区少了一半,Kettle 照常跑完。
操作
在作业末尾加行数校验:源与目标比对,差异超阈值则作业失败告警。
SELECT (SELECT COUNT(*) FROM src_orders WHERE dt='${p_day}') AS s, (SELECT COUNT(*) FROM dwd_orders WHERE dt='${p_day}') AS t;
结果
次日同类分区缺失立刻告警,业务在报表发布前就收到,没再出错的看板。
解读
根因是「退出码≠数据对」。监控必须下沉到数据层,成功信号要包含质量校验,否则假成功最危险。
变式
可进一步做指标同比:今日行数与七日均值比,异常波动即告警,比固定阈值更能抓隐性退化。
常见误区与工程取舍
误区:只看退出码。必须加数据层校验,防静默错。
误区:什么都告警。分级,否则告警疲劳没人看。
取舍:三层监控(调度/引擎/数据);每个装载带行数比对。
深入:监控与告警怎么才算到位
作业跑完不能只求「没报错」,还要确认「数据对」。监控分两层:执行层(成功/失败、耗时、退出码)由调度系统采集;数据层(行数波动、空跑、重复)由 Kettle 内的「行数校验」「写日志」步骤采集。告警要在失败时即时发(邮件/IM),并附关键日志片段;对数据异常(如当日行数较前日跌 50%)也要阈值告警,因为「跑成功了但数据少了」比「跑失败」更危险。日志要留存足够天数供回溯。
-- 数据层监控:把每日行数写入监控表(输入:当日处理结果;输出:监控表,供阈值比对) INSERT INTO etl_monitor (job_name, run_day, row_cnt, run_status) SELECT 'orders_pipeline', '${p_day}', COUNT(*), 'SUCCESS' FROM dst_orders WHERE dt = '${p_day}'; -- 下游比对:若 row_cnt 较 7 日均值跌超阈值,自动触发告警,捕捉「成功但空跑」
⚠️ 常见坑(监控告警)
- 只监控成败不监控数据:跑成功但行数暴跌无人知,比失败更阴险。
- 告警无上下文:只说「失败」,排错还要翻日志,响应慢。
- 日志不留存:事后复盘无据,同类问题反复犯。
💡 关键直觉
- 监控要「双保险」:执行层保「跑没跑完」,数据层保「跑得对不对」。
- 「成功但空跑」是 ETL 最隐蔽的故障,阈值告警专治它。
| 层 | 监控什么 | 告警触发 |
|---|---|---|
| 执行 | 成败/耗时 | 失败即时 |
| 数据 | 行数波动 | 超阈值 |
工程实录:双保险监控
作业跑成功,但当日行数暴跌无人知。
行数写入监控表,与前七日均值比对超阈值告警。
INSERT INTO etl_monitor (job_name, run_day, row_cnt, run_status) SELECT 'orders_pipeline','${p_day}', COUNT(*),'SUCCESS' FROM dst_orders WHERE dt='${p_day}'; -- 下游比对:row_cnt 较均值跌超阈值即告警,捕捉「成功但空跑」
静默污染被及时拦下。
监控要双保险:执行层保跑完,数据层保跑对。
日志留存足够天数,事后可复盘。
参数与阈值速查
| 层 | 监控 | 告警 |
|---|---|---|
| 执行 | 成败/耗时 | 失败即时 |
| 数据 | 行数波动 | 超阈值 |
现场口诀
监控要「双保险」:执行层保「跑没跑完」,数据层保「跑得对不对」。只监控成败会漏掉最危险的「成功但空跑」——行数暴跌却退出码为 0。给行数设波动阈值告警,才能把静默污染拦在下游之前。
补充:告警日志片段要带关键上下文(出错步骤名、当日行数、对比基线),让人收到消息就能定位,而不是只知道「失败了」再去翻日志。保留日志 30 天以上,便于事后复盘同类问题,避免反复踩同一个坑。