2.2 节点 (Node) 的类型与功能
2.2 节点 (Node) 的类型与功能
节点不只是函数
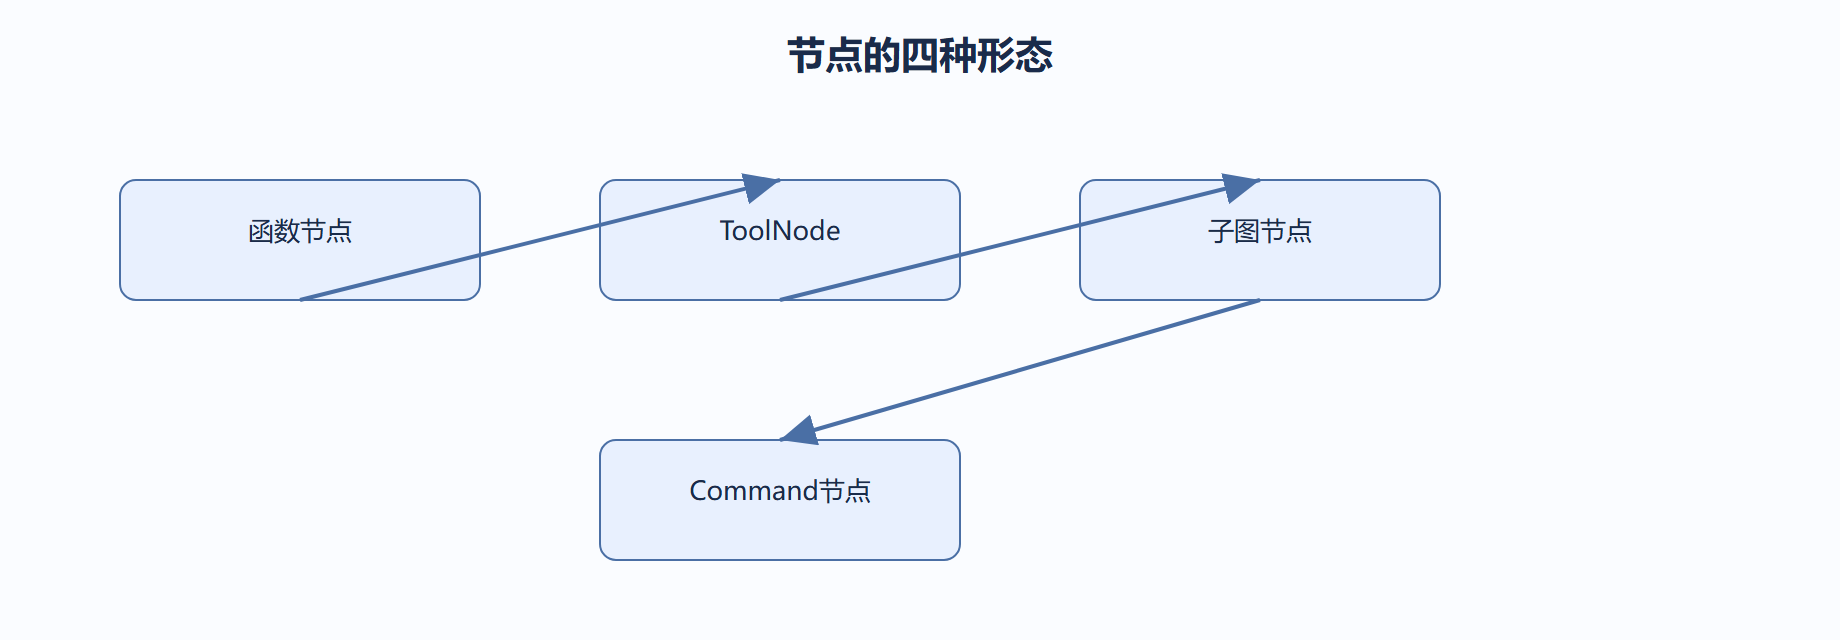
本节在全册位置:细化节点这一原语。最常见的是普通 Python 函数节点,返回状态增量;此外有工具节点(ToolNode)、封装子图的节点、以及用 Command 精确控制流转的节点。节点是图里唯一产生副作用或调用模型的地方。我们建议把副作用收口到少数节点,图其余部分保持纯函数,便于测试。
类型:从纯函数到指令节点
普通节点签名是 (state) -> 增量。ToolNode 把工具列表包成节点,配合 tools_condition 自动决定调不调。子图节点把一个编译好的图当节点嵌入,实现模块化。Command 节点在返回增量的同时用 goto 指定下一步,适合需要中途改写流向的场景。类比游戏:普通节点像技能,ToolNode 像装备栏,子图像副本,Command 像连招取消。把节点粒度设计好,比事后重构图便宜得多。
from langchain_core.tools import tool from langgraph.prebuilt import ToolNode @tool def calc(expr: str) -> str: """计算算术表达式""" return str(eval(expr)) # ToolNode 自动把工具结果写回消息通道 tn = ToolNode([calc]) print(tn.invoke({"messages": [("user", "算 1+2")]}))
# 用 Command 在节点内直接决定去向 from langgraph.graph import Command def router(s): if s["done"]: return Command(goto=END, update={"note": "结束"}) return Command(goto="next", update={"note": "继续"}) # Command 的价值是:节点既能改状态,又能改写控制流
节点返回的三种写法
调用一个节点后,图执行器拿什么作为"这一轮的结果"?三种写法各有取舍。
# 写法一:返回增量字典(最常用、最安全) def node_a(state): return {"count": state["count"] + 1} # 写法二:原地修改 state 本身(省一次拷贝,但破坏可重放性) def node_b(state): state["count"] += 1 return state # 写法三:返回 Command,把"改状态"和"定去向"一起交出去 def node_c(state): if state["done"]: return Command(goto=END, update={"note": "结束"}) return Command(goto="next", update={"note": "继续"})
写增量的节点保持纯函数:同样的入参必然得到同样的输出,断点续跑、重放、并行都依赖这个性质。原地修改省内存,但一旦配合检查点做断点重放,历史状态会被悄悄污染,排查成本远高于省下的那点开销。Command 则适合"路由 + 更新"绑定的场景,后面会专门展开。
add_node 与节点命名
from langgraph.graph import StateGraph builder = StateGraph(State) builder.add_node("research", research_fn) # 显式命名 builder.add_node("write", lambda s: {"draft": s["research"]}) # 匿名函数 builder.add_node(END, lambda s: s) # 错误示范:保留名
节点名有三个隐藏用途:日志里定位哪一步出错、检查点按节点名切片、追踪面板按节点名分组。所以命名要像给函数起名一样认真,别用 n1、n2。两条铁律:不能与 START/END 冲突;同一张图内不能重名。匿名 lambda 的节点名由 add_node 第一个参数决定,与函数对象无关——两个不同的 lambda 若用了同一个节点名,后注册的会覆盖前者,运行时静默替换,这是"节点行为莫名其妙变掉"的常见来源之一。
ToolNode 与工具调用循环
工具节点最容易被忽视的细节是它"读什么、写什么"。ToolNode 从最新的 AI 消息里提取 tool_calls,逐个执行工具,再把结果以 ToolMessage 写回消息通道,一次调用处理整批工具请求:
from langchain_core.tools import tool from langgraph.prebuilt import ToolNode @tool def calc(expr: str) -> str: """计算算术表达式""" return str(eval(expr)) tn = ToolNode([calc], handle_tool_errors=True) print(tn.invoke({"messages": [("user", "算 1+2")]}))
handle_tool_errors=True 时,工具内部抛出的异常会被捕获并转成 ToolMessage(内容为错误信息)写回,图不会崩,模型读到后还能"自我纠错"再调一次。同一轮请求里若有多个 tool_calls,ToolNode 会并行执行(同步工具走线程池,异步工具走事件循环),这也是吞吐优化里最容易白拿的一档收益。要接入的工具 schema 由函数签名自动推导,参数名、类型、docstring 都影响模型能否正确调用,写 docstring 时把"参数含义 + 边界情况"写清楚,模型调对的概率会明显上升。
单点路由与扇出:Command 与 Send 的分工
两者都改变控制流,但适用场景相反:
| 维度 | Command | Send |
|---|---|---|
| 触发时机 | 节点结束时 | 节点执行过程中 |
| 去向数量 | 单一 goto | 一对多扇出(给多个目标各发一条) |
| 典型场景 | 路由、提前结束 | Map-Reduce、并行子任务 |
| 状态语义 | update 合并进主状态 | 每个 Send 携带独立片段状态 |
Command 是"我自己接下来去哪";Send 是"我同时派活给一批人"。做并行处理的套路是:一个分发节点循环构造 Send 列表返回,收集节点等所有子任务结果就绪后再聚合——扇出的粒度、聚合的等待逻辑都要自己维护,别指望框架帮你收尾。
节点不动的排查顺序
图"卡住"时先别怀疑运行时,按下面的顺序查:
- 边连上了吗:节点没有入边或入边来源从未执行,它永远不会被调度。
- 条件边评估结果对吗:条件函数返回的字符串必须精确匹配某条边或节点名,大小写差一个字符就是静默不路由。
- 返回的 key 与状态通道名一致吗:
{"user_msg": ...}而通道叫user_message,图不报错,只是状态没变。 - 循环有没有终止条件:条件边永远为真 = 无限循环;把计数放进状态并在条件里递减,是最简单的保险。
这四条按顺序查完,九成"节点不动"都有答案;剩下的再去看检查点是否从旧快照恢复导致状态过期。
案例:把子图当节点
背景:一个「预处理」流程在多个主图里复用,既出现在研究助手也出现在客服分流。
操作:把预处理编译成子图,用 add_node 嵌入主图。
结果:主图更干净,子图可单独测试、单独升级。
解读:节点粒度决定了可复用性与可读性,子图是天然的抽象边界,别把所有逻辑摊平在一个图里。
变式:子图带自己的检查点命名空间,详见第四章持久化,这点是模块化不被状态污染的关键。
工程清单
-
普通函数节点返回增量,ToolNode 把工具结果写回消息通道,是接入外部能力的最短路径。
-
子图节点把一张编译好的图当节点嵌入,是天然的抽象边界,便于单独测试与升级。
-
Command 节点在返回增量同时用 goto 指定下一步,适合中途改写流向,但别滥用成全动态路由。
常见误区
把副作用(发信、写库)直接写进普通节点,导致不可重放;应抽成独立节点并配检查点,中断时才能精确停在副作用之前。