5.2 多 Agent 系统协作与编排
5.2 多 Agent 系统协作与编排
多个智能体怎么分工
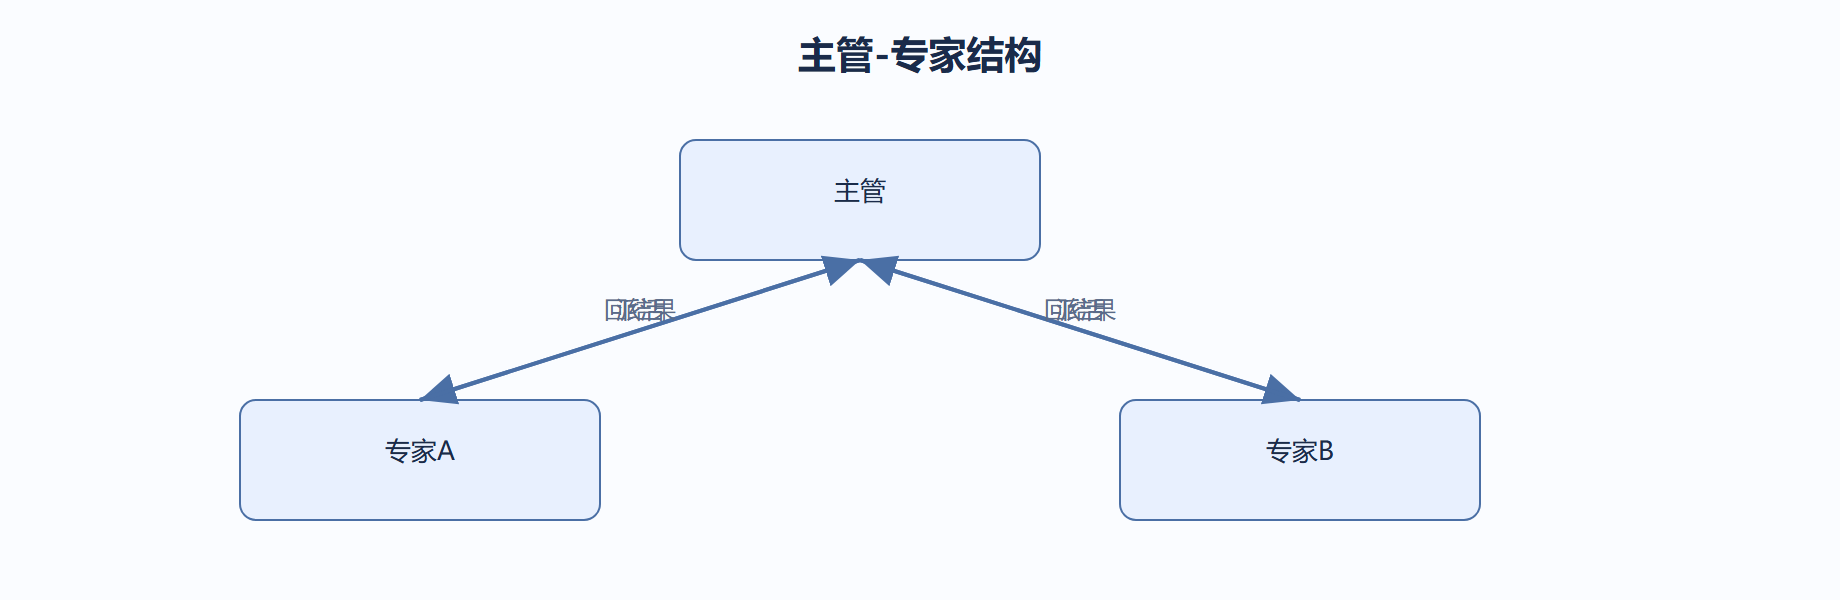
本节在全册位置:单智能体不够时上多智能体。主管-专家(supervisor)模式最常用:一个主管节点读状态、决定派给哪个专家,专家做完把结果写回,再回主管,直到任务完成。各专家是子图,共享状态。我们把主管-专家当成「组织图」,职责隔离是它存在的理由。
编排:主管路由与子图
主管用模型输出「下一步该谁做」;条件边按输出路由到对应专家子图;专家子图内部可再循环。共享状态让专家之间不靠 prompt 传话,而是读同一份上下文。退出由主管判断。类比建筑:主管像总包,专家像分包,图纸(状态)共享。我们建议专家之间不要互相直接改全局状态,所有协调经主管,避免竞态。
from langgraph.graph import StateGraph, START, END, MessagesState from langgraph.prebuilt import ToolNode, tools_condition def supervisor(s: MessagesState): # 主管:读消息,决定下一个工人或结束 decision = model.invoke(s["messages"]) return {"messages": [decision]} # 两个专家子图(这里简化成单节点) def expert_a(s): return {"messages": [model.invoke(s["messages"])]} def expert_b(s): return {"messages": [model.invoke(s["messages"])]} b = StateGraph(MessagesState) b.add_node("supervisor", supervisor) b.add_node("expert_a", expert_a) b.add_node("expert_b", expert_b) b.add_edge(START, "supervisor") b.add_conditional_edges("supervisor", lambda s: _route(s)) b.add_edge("expert_a", "supervisor") b.add_edge("expert_b", "supervisor") b.add_edge("supervisor", END)
# _route 解析主管决策,返回 'expert_a' / 'expert_b' / END def _route(s): txt = s["messages"][-1].content if "交给A" in txt: return "expert_a" if "交给B" in txt: return "expert_b" return END # 主管输出即路由信号,图结构保持扁平易读
案例:研报三人组
背景:研报需检索、计算、写作三类能力,单一提示难以同时做好。
操作:主管按当前缺口派给检索/计算/写作专家,轮流直到成稿。
结果:各专家专注本职,主管控节奏,质量与可维护性都提升。
解读:多智能体把「能力隔离」显式化,便于替换与测试单个专家,是规模化智能体的骨架。
变式:专家间也可直接 Send 协作(见 3.5),减少主管瓶颈,但只在无共享写冲突时这样做。
工程清单
-
主管-专家模式:主管读状态派活,专家做完写回,再回主管,所有协调经主管避免竞态。
-
各专家是子图,共享状态而非靠 prompt 传话,避免写入冲突与难以回溯的状态污染。
-
退出由主管判断,避免某个专家无限接管,主管输出即路由信号,图结构保持扁平。
常见误区
让专家之间直接改全局状态而不经主管,出现写入冲突与竞态;职责隔离是主管-专家存在的理由,所有跨专家协调都应显式经过主管节点。
让主管输出结构化路由
主管「下一步派给谁」如果靠自由文本解析,路由必然脆弱。把决策约束成结构化输出,路由函数就稳定了:
from typing import TypedDict, Optional class RouteDecision(TypedDict): target: str # 枚举约束:expert_a / expert_b / END reason: str # 给下游看,不参与路由 # 模型带结构化输出调用,路由直接读 target 字段 def supervisor(s): decision = model.with_structured_output(RouteDecision).invoke(s["messages"]) return {"route": decision["target"], "reason": decision["reason"]} def route(s): # 白名单校验:非法值一律走 END,绝不崩溃 return s["route"] if s["route"] in {"expert_a", "expert_b"} else END
两条防线:结构化输出把「说人话」变成「填字段」,路由函数只认白名单里的值。就算模型输出了奇怪的 target,也回落到 END 而不是抛异常。别在路由函数里做字符串匹配自由文本,那是把可靠性押在模型措辞上。
把专家升级成子图
单节点专家只是占位,真实专家内部往往还有自己的循环与工具调用,升级成子图后主管侧一行不改:
# 专家子图:内部含 agent -> tools 循环 def build_expert(tools, prompt): b = StateGraph(MessagesState) b.add_node("agent", call_model) b.add_node("tools", ToolNode(tools)) b.add_edge(START, "agent") b.add_conditional_edges("agent", tools_condition) b.add_edge("tools", "agent") return b.compile() # 主图:子图当节点注册,主管继续按 name 路由 b.add_node("expert_a", build_expert(tools_a, prompt_a)) b.add_node("expert_b", build_expert(tools_b, prompt_b))
升级的收益:专家内部逻辑内聚在子图里,可单独测试、单独换版本;主管看到的还是两个名字,路由逻辑不变。注意子图读主图状态时只读自己需要的通道,别把主管的中间字段也读走——子图与主图共享状态,但边界意识要自己维护。
多智能体的通信模式对比
| 模式 | 谁到谁 | 状态写冲突 | 适用 |
|---|---|---|---|
| 主管中转 | 专家 -> 主管 -> 专家 | 无,经主管收口 | 默认首选 |
| 直接 Send | 专家 -> 专家(扇出) | 需谨慎 | 无共享写、纯并行 |
| 共享状态 | 所有专家读写同一状态 | 高 | 消息通道,配合归约 |
默认走主管中转,理由在前面说过:协调点集中,竞态可控。直接 Send 在「专家确实互不依赖」时能提速,但要先确认写入通道都有归约器。共享状态不是不能用,而是只用于消息类通道——专家之间的「传话」一律走消息,别靠各自往不相关的字段里塞东西。