5.3 工具调用 (Tool Calling) 的高级应用
5.3 工具调用 (Tool Calling) 的高级应用
工具怎么接进图
本节在全册位置:工具是智能体与外部世界的接口。ToolNode 把工具列表包成节点,tools_condition 按模型是否请求工具决定流向。高级用法包括工具结果校验、工具级人工确认、并行工具。我们主张:工具的能力与权限要分开管。
应用:ToolNode 与条件分流
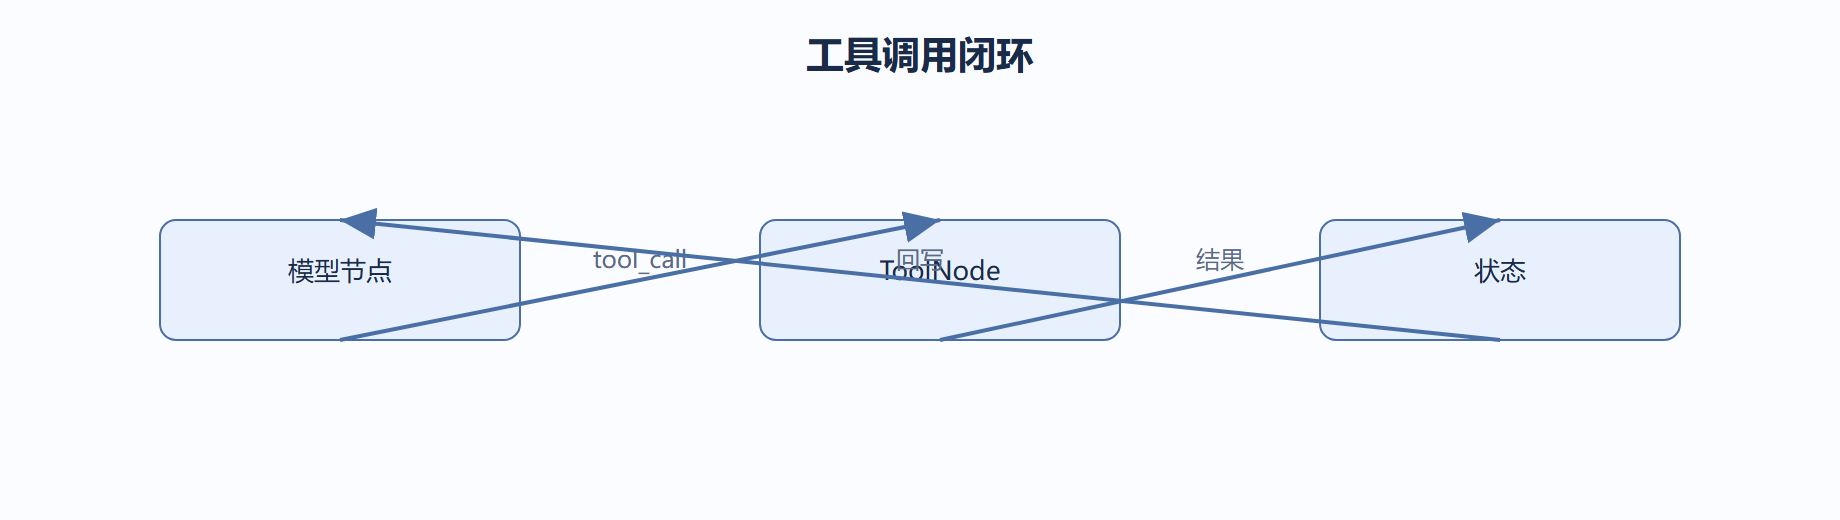
模型在消息里输出 tool_call,tools_condition 检测到就路由到 ToolNode;ToolNode 执行并把结果以 tool 消息写回状态;再回模型。可在 ToolNode 外包一层做结果校验或限流。对危险工具,先 interrupt 再执行。类比物理:工具像探头,ToolNode 像执行机构,条件边像联锁。把写操作工具拦在人工确认之后,是上线的底线。
from langgraph.prebuilt import ToolNode, tools_condition from langchain_core.tools import tool from langgraph.graph import StateGraph, START, END, MessagesState @tool def query_db(sql: str): """查数据库""" return "[" + sql + "]" @tool def send_sms(text: str): """发短信(敏感)""" return "sent" tools = [query_db, send_sms] model_with_tools = model.bind_tools(tools) def agent(s: MessagesState): return {"messages": [model_with_tools.invoke(s["messages"])]} b = StateGraph(MessagesState) b.add_node("agent", agent) b.add_node("tools", ToolNode(tools)) b.add_edge(START, "agent") b.add_conditional_edges("agent", tools_condition) b.add_edge("tools", "agent") b.add_edge("agent", END)
# 想给敏感工具加人工确认:用 interrupt 包一层 from langgraph.types import interrupt def safe_tools(s): decision = interrupt({"pending": s["messages"][-1].tool_calls}) return ToolNode(tools).invoke(s) if decision == "allow" else s # 只读工具放开,写操作加闸,按工具标签分流
案例:敏感工具加闸
背景:send_sms 不能随意自动发,发错就是对外事故。
操作:tools 节点前置 interrupt,人允许才执行。
结果:自动调用与人工安全兼得,写操作零误发。
解读:工具的「能力」与「权限」要分开管,图让这层显式,而不是藏在 prompt 里。
变式:对只读工具放开、写操作加闸,按工具标签分流,比一刀切更顺手。
工程清单
-
ToolNode 包工具列表,tools_condition 按 tool_call 路由,工具结果以 tool 消息写回状态。
-
危险工具前置 interrupt 再执行,只读工具可放开,工具的能力与权限要分开管。
-
可在 ToolNode 外包一层做结果校验或限流,把工具调用收敛成可控节点。
常见误区
把发短信这类写操作也自动执行,出事才加闸;应默认对写操作加人工确认,按工具标签分流比一刀切更顺手,这也是上线的底线。
工具结果校验层
工具返回的数据不能无条件信任,尤其来自外部 API 的结果。在 ToolNode 外层包一个校验节点,把不合格结果标记出来:
def validate_tools(s): results = s["messages"][-1] bad = [] for m in results: # 遍历本轮工具消息 if isinstance(m, ToolMessage): ok = check_schema(m.content) # 校验结构是否符合预期 if not ok: bad.append(m.name) if bad: # 把校验结论写回状态,走修复边而不是继续生成 return {"tool_errors": bad} return {}
# 校验结论作为条件边的输入: # 有坏结果 -> 修复节点,无坏结果 -> 回 agent
校验层解决的是「工具说成功但格式不对」的隐性故障。校验规则别在工具内部写死,集中在校验节点维护,新增工具时不用改校验逻辑,只要工具返回结构符合约定。判断约定是否成立,用类型校验或 JSON schema 比对,别用 if 碰运气。
工具调用的批处理与限流
模型一次可以请求多个工具(一个消息带多个 tool_calls),ToolNode 默认并行执行这批调用。这里藏着两个工程点:
# 并行执行是默认行为,同步工具走线程池 # 同一批内的工具互不可见、不能互相依赖
第一,批内工具并行,若两个工具写同一个外部资源,要自行协调,框架不管。第二,并发没有上限约束,批量大时可能打垮下游,需要自己做信号量限流。第三,工具执行失败默认不影响其它同批工具,失败结果以错误消息写回,模型读到后还能决定要不要重试。把「批内并行、失败隔离、结果回写」这三条记牢,工具层的行为就完全可预期了。
工具命名与 schema 的纪律
模型能不能调对工具,一半取决于函数签名与文档写得好不好。三条纪律直接提升调用成功率:
- 函数名用动词 + 对象的清晰组合:send_email、query_stock_price,避免抽象名字。
- 参数名与业务术语一致,类型写具体:str 参数标注格式(日期、JSON 字符串)。
- docstring 写清「做什么、参数含义、边界行为」,模型靠它决定传什么参数。
@tool def send_email(to: str, subject: str, body: str): """发送一封邮件。 to: 收件人邮箱地址,必填。 subject: 主题,长度建议不超过 100 字符。 body: 正文内容。 邮件发送成功返回确认编号。""" ...
工具 schema 是由函数签名自动推导的,写函数时多花的功夫,直接变成模型调对的概率。别为省事把参数名改成 a、b 之类的缩写,模型猜错参数的成本比写长名字高得多。