5.5 异常处理与回滚机制
5.5 异常处理与回滚机制
节点报错怎么办
本节在全册位置:生产图必须容错。节点抛异常时,可在节点内 try/except 把错误写回状态走「降级边」;也可用 with_retry 给节点加重试;严重错误用 interrupt 让人处置。LangGraph 没有自动回滚,需显式设计。我们把异常当普通状态分支,图天生可容错。
机制:降级边与重试
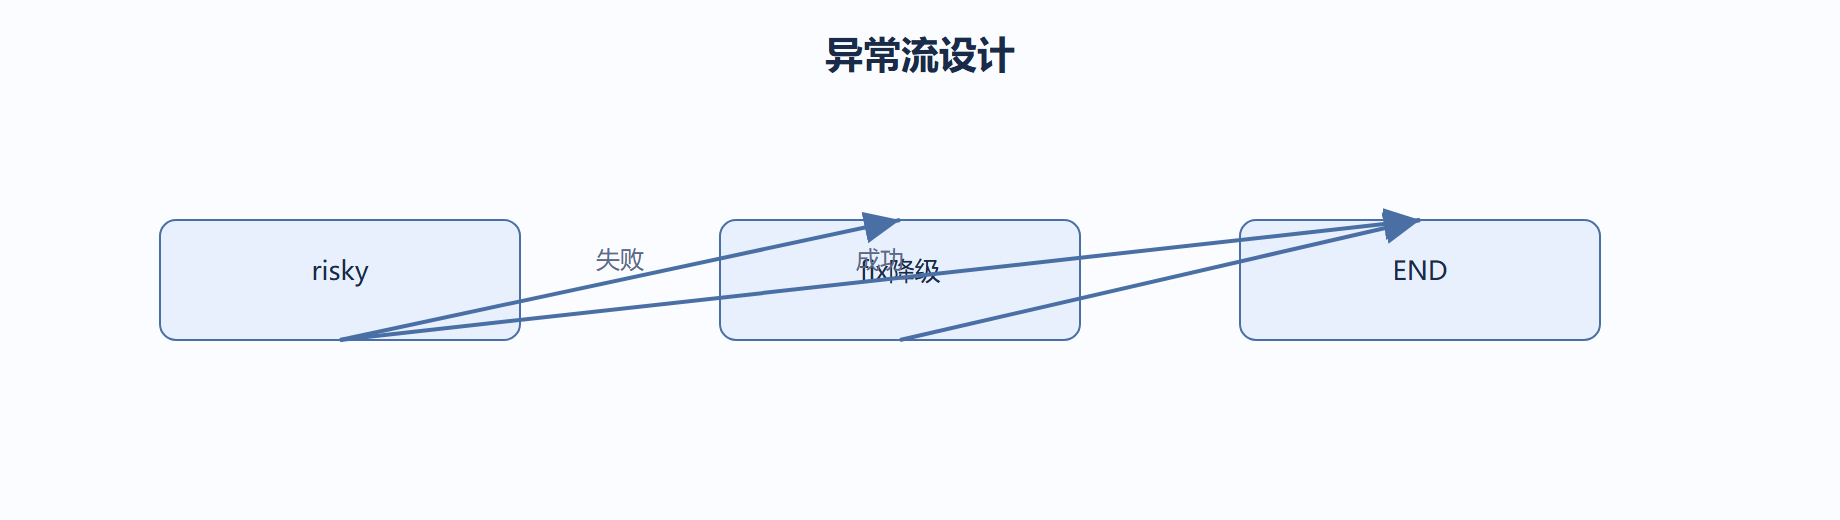
最佳实践是把「正常流」与「异常流」都画进图:节点捕获异常后返回错误标记,条件边据此去修复节点或 END。with_retry 对瞬时错误自动重试。状态因有检查点,失败时从断点 resume 即可,不必全重跑。类比物理:异常流像泄压阀,重试像自动合闸。降级边让主流程不崩,用户至少收到兜底。
from langgraph.graph import StateGraph, START, END from typing import TypedDict class S(TypedDict): ok: bool err: str def risky(s: S): try: # 可能失败的外呼 return {"ok": True} except Exception as e: return {"ok": False, "err": str(e)} def fix(s: S): return {"ok": True, "err": ""} b = StateGraph(S) b.add_node("risky", risky) b.add_node("fix", fix) b.add_edge(START, "risky") b.add_conditional_edges("risky", lambda s: "fix" if not s["ok"] else END) b.add_edge("fix", END)
# 用内置重试装饰节点(瞬时错误) from langgraph.prebuilt import InjectedState b.add_node("risky", risky.with_retry(retry_on=Exception, max_attempts=3)) # 两层保险:瞬时错误自动恢复,持久错误走降级
案例:外呼失败降级
背景:通知节点调第三方接口偶尔超时,直接抛异常会让整图中断。
操作:节点内捕获异常写 err,条件边去 fix 节点做本地兜底通知。
结果:主流程不崩,用户至少收到降级提示,而非毫无响应。
解读:把异常当普通状态分支,图天然可容错,比在调用处裸 try 更清晰。
变式:对不可恢复错误,用 interrupt 升级给人,避免静默失败,关键链路不留盲区。
工程清单
-
节点内 try/except 把错误写回状态走降级边,异常流像泄压阀让主流程不崩。
-
with_retry 对瞬时错误自动重试,重试耗尽再走修复节点,两层保险覆盖不同故障。
-
严重错误用 interrupt 升级给人,避免静默失败,关键链路不留盲区。
常见误区
以为框架会自动回滚;LangGraph 没有自动回滚,异常流必须自己画进图,把异常当普通状态分支比在调用处裸 try 更清晰可测。
异常分级与处理策略
不是所有异常都该用同一种处理方式,先分级再定策略,异常流才不至于一把抓:
| 异常类型 | 特征 | 处理策略 | 示例 |
|---|---|---|---|
| 瞬时错误 | 重试大概率成功 | with_retry 自动重试 | 网络超时、连接中断 |
| 业务错误 | 重试无意义 | 降级边走兜底 | 参数非法、余额不足 |
| 严重错误 | 需要人介入 | interrupt 升级 | 权限异常、数据损坏 |
| 未知错误 | 无法分类 | 记录 + 走兜底 | 其它异常 |
# 分级实现:把异常分类逻辑集中在节点入口 def risky(s): try: return {"ok": True} except TimeoutError: return {"ok": False, "err": "retry"} # 瞬时 -> 重试 except ValueError as e: return {"ok": False, "err": "fallback"} # 业务 -> 降级 except Exception as e: raise # 未知 -> 让框架按全局兜底处理
分级的价值在于让「重试、降级、升级」三条路各司其职,不会出现「业务错误重试三次还是错」「瞬时错误直接中断」这类浪费。分类规则建议集中写,别在每个节点里各写一套。
with_retry 的参数与局限
内置重试装饰器适合瞬时错误,但它的参数要理解到位:
node.with_retry(retry_on=TimeoutError, # 只对特定异常重试 max_attempts=3, # 最多尝试 3 次 wait_seconds=1.0, # 重试间隔 retry_on_stall=False) # 是否对无进展也重试
三个注意点:retry_on 用具体的异常类型而不是裸 Exception,避免把业务错误也无限重试;max_attempts 之后抛出的还是原始异常,要在外层捕获走降级;重试是「同节点重跑」,节点内若有部分副作用已经发生,要靠幂等去重兜底(见 4.5)。重试不是万能药,它只覆盖「瞬时且无副作用残留」的场景。
回滚的三种策略
LangGraph 没有自动回滚,但可以组合出现有的机制实现「准回滚」,按代价从小到大排列:
| 策略 | 做法 | 代价 | 适用 |
|---|---|---|---|
| 继续修正 | 降级边走修复节点,从当前状态继续 | 低 | 大部分业务错误 |
| 回退快照 | update_state 把状态改回历史检查点再重跑 | 中 | 状态被污染 |
| 补偿动作 | 已产生的副作用用反向操作抵消 | 高 | 写类副作用 |
# 回退快照:从历史检查点取旧状态,覆盖当前后继续 old = list(g.get_state_history(cfg))[2].values g.update_state(cfg, old) g.invoke(Command(resume=True), cfg)
选择顺序:能修正就修正,不能修正才回退,回退不行才补偿。补偿动作本身也要幂等(反向操作重复执行无副作用),否则补偿又引入新一轮问题。把这三种策略想清楚,异常流的兜底就完整了。
异常流的测试方法
异常处理代码最容易「写了不测、上线才发现」。测试异常流有两个要点:注入故障要可控,断言要走完整条降级链。
# 用 monkeypatch 让节点抛特定异常,验证降级边生效 def test_risky_falls_back(monkeypatch): monkeypatch.setattr(service, "call", raise_timeout) out = g.invoke({"ok": None}) assert out["ok"] is True # 修复节点兜住了 assert out["err"] == "" # 错误已清除
故障注入的粒度到「哪条边该走哪条路」即可:分别测瞬时错误走重试、业务错误走降级、严重错误触发 interrupt。每条异常路径都是一等公民,和正常路径一样配测试。把「每个节点会失败」当默认假设来测,异常流才能真正抗住线上变化。