5.4 流式输出 (Streaming Output) 处理
5.4 流式输出 (Streaming Output) 处理
token 怎么一个一个来
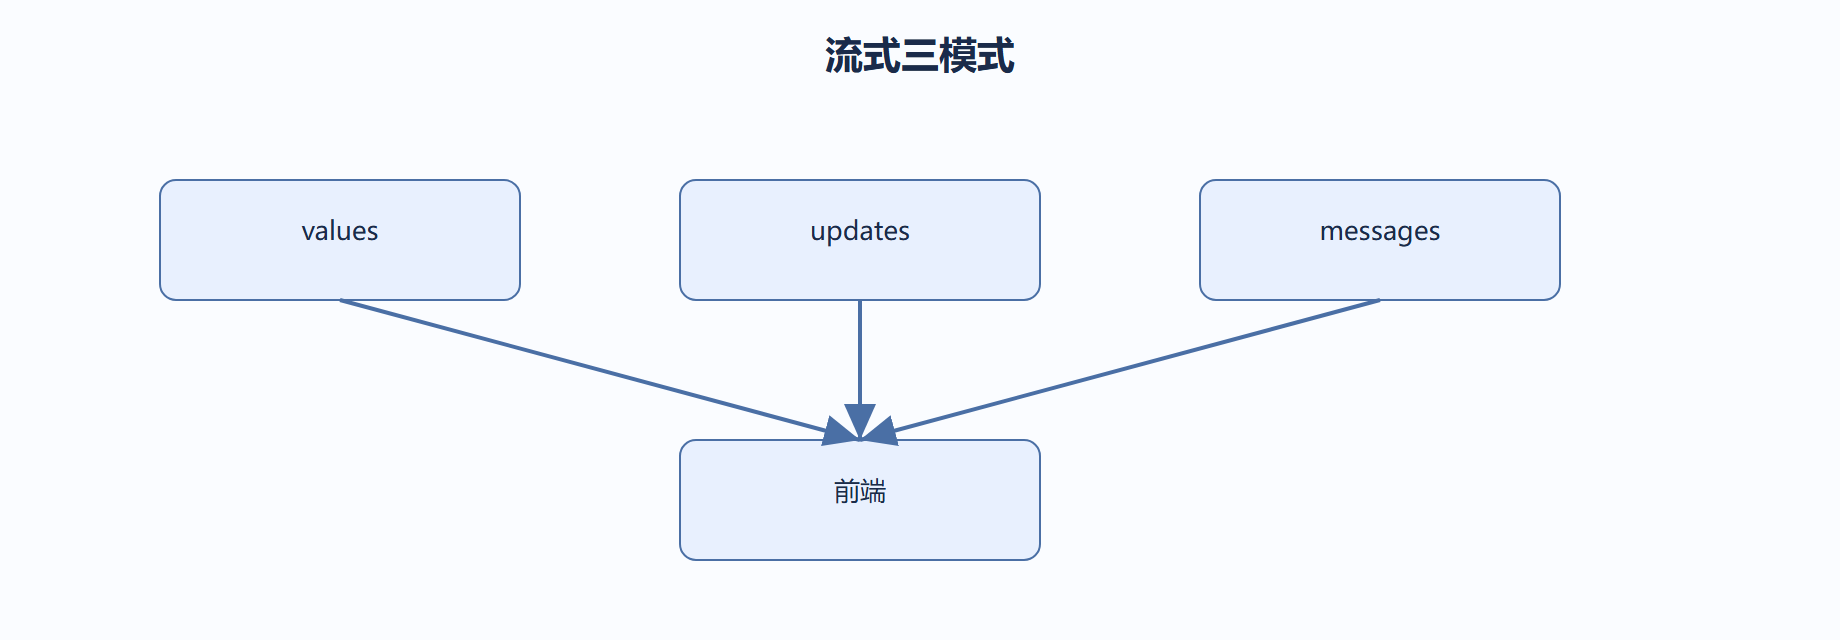
本节在全册位置:用户体验靠流式。LangGraph 提供多种 stream_mode:values(每步完整状态)、updates(每节点增量)、messages(token 级)。messages 模式直接对接前端打字机效果,背后依赖第四章检查点提供的增量状态。我们强调:流式不改变图结构,只是消费轨迹。
处理:三种流模式
stream_mode="values" 适合看整体进度;"updates" 适合看每个节点改了什么;"messages" 适合把模型生成逐字推给前端。流式不额外改变图结构,只是消费执行轨迹。类比金融:values 像日终余额,updates 像逐笔流水,messages 像行情 tick。把 token 透传给前端是框架职责,模型侧才决定延迟。
from langgraph.graph import StateGraph, START, END from typing import TypedDict class S(TypedDict): out: str def gen(s: S): # 真实场景里这里调用流式模型 return {"out": (s.get("out") or "") + "思考中..."} b = StateGraph(S) b.add_node("gen", gen) b.add_edge(START, "gen") b.add_edge("gen", END) g = b.compile() # 5.4 流式输出 (Streaming Output) 处理 for chunk in g.stream({"out": ""}, stream_mode="updates"): print("节点更新:", chunk) # 逐 token(需模型支持 streaming) for tok in g.stream({"out": ""}, stream_mode="messages"): print(tok[0].content, end="")
# 无需在节点内部手写 yield,框架已处理透传
案例:前端打字机
背景:用户希望回答边生成边显示,首字延迟低体验才好。
操作:前端订阅 stream_mode="messages",把 token 追加到界面。
结果:首字延迟低,体感更顺,长答案不再干等。
解读:流式的成本在模型侧,框架只负责把增量透传出来,别在节点里手写逐字逻辑。
变式:用 updates 模式可同时驱动「进度条」与「结果区」两个 UI,信息更丰富。
工程清单
-
stream_mode 有 values/updates/messages 三档,messages 对接前端打字机,背后依赖检查点增量。
-
流式不改变图结构,只是消费执行轨迹,框架负责把模型侧 token 透传出来。
-
values 看整体进度,updates 看每节点改了什么,按 UI 需求选模式。
常见误区
为了流式在节点里手写逐字 yield,绕开框架;正确做法是外层 stream_mode 透传增量,节点保持普通调用,模型侧才决定首字延迟。
三种模式的输出结构对比
同一个图、同一个输入,三种 stream_mode 吐出来的结构完全不同,看清差异才能选对:
# values:每轮吐完整状态快照,dict 结构 {'out': ''} {'out': '思考中...'} {'out': '思考中...完成'} # updates:每轮吐节点名 + 该节点增量 {'gen': {'out': '思考中...'}} {'gen': {'out': '思考中...完成'}} # messages:每轮吐 (chunk, metadata) 二元组 (AIMessageChunk(content='你'), {'langgraph_node': 'gen'})
values 适合「进度整体展示」,前端拿最新一轮渲染即可;updates 适合「谁做了什么」的面板,多智能体场景按节点名分组展示;messages 是打字机的唯一选择,每轮一个 token 级 chunk。metadata 里通常带节点名,前端可以用它给不同节点的输出打标签。选模式的依据永远是「前端需要什么粒度」,而不是框架能给什么。
流式与检查点的配合
流式不是独立于持久化之外的旁路,它消费的正是检查点产生的增量轨迹。两点配合要清楚:
# 中断后 resume,仍然可以继续流式 for chunk, meta in g.stream(Command(resume="ok"), cfg, stream_mode="messages"): print(chunk.content, end="")
第一,interrupt 挂起后,剩余节点的生成仍然可以流式输出,前端从挂起点继续展示,不用重新拉全文。第二,stream 逐轮产生的中间状态同样进检查点,中途断开会话,下次从最近快照继续。理解这条,就知道「流式 + 检查点 + interrupt」三者是一套组合拳:流式负责体验,检查点负责可靠,interrupt 负责人工介入,缺一个都是残次品。
首字延迟的来源与优化
「首字延迟」由模型侧决定,但工程侧能做的优化也不少,按收益排序:
- 模型本身:选首 token 快的模型,比任何工程优化都直接。
- 减少前置串行节点:把「先全做完再开始生成」改成「先进入生成节点」,其余工作并行或后置。
- 检查点写入放在生成之外:大状态每次更新都落盘会拖慢节奏,必要时裁剪通道。
- 预热连接:长任务开始时预建立模型与存储连接,省掉首轮握手时间。
# 把非关键的整理工作挪到生成之后,首字时间只看生成链路
排查首字延迟时先分清:是模型侧慢,还是工程侧的前置节点串行拖慢。用 6.2 的可观测性手段量出每个节点的耗时,首字延迟的问题能精确到「从请求到第一个 token 之间谁占了时间」。别一上来就怀疑流式实现,它通常不是瓶颈。
流式任务的部署注意点
流式对运行环境有一个隐含要求:请求必须保持长连接直到流结束,这直接影响部署形态。网关超时设短、负载均衡强制断开、代理缓冲整包才转发,这三类问题都会让流式表现为「明明支持,却半天不出字」。部署时给流式接口单独设超时,不与其他请求共用一套短超时配置;客户端要做断线重连,中途断流后从最近检查点续流,而不是重新开始。把这些部署细节和业务代码一起评审,流式体验才能真正交付。