7.1 典型应用案例解析
7.1 典型应用案例解析
把全册零件拼成系统
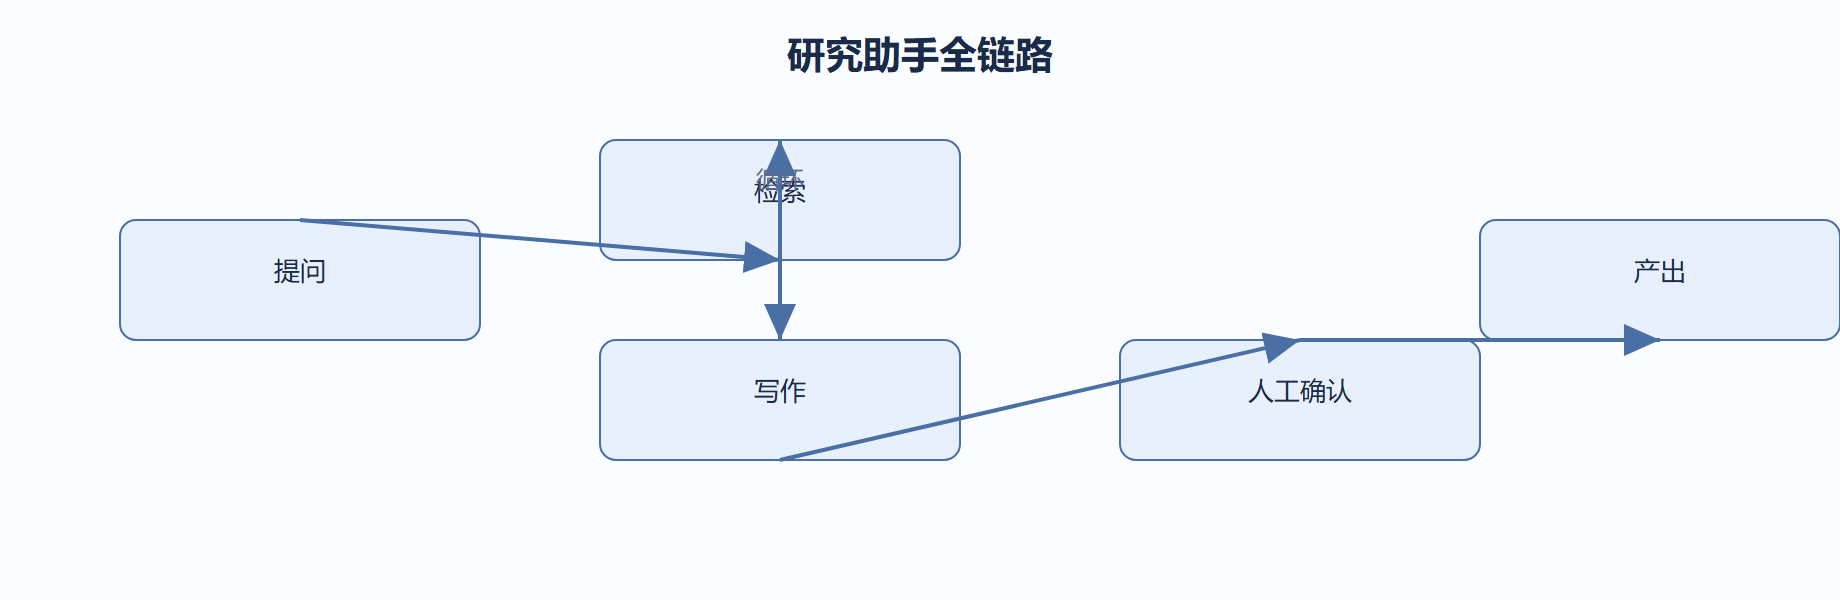
本节在全册位置:收口实战。我们走通一个「检索增强研究助手」:用户提问 -> 检索节点 -> 主管判断够不够 -> 不够回到检索,够则写作 -> 人工确认 -> 产出。它用到第三、四、五章几乎所有零件。这个案例不是玩具,而是生产里最常见的形态之一。
案例:研究助手全链路
状态用 MessagesState 累积对话与检索片段;检索节点调向量库;主管(agent 节点)决定继续检索还是写作;写作节点生成草稿;review 节点 interrupt 人工确认;检查点保证长任务可恢复;流式把生成推前端。各环节都可单独替换。类比建筑:这是一栋用前面各章「构件」盖成的楼。模块化让单点改进不影响全图,是图式编排的长期收益。
from langgraph.graph import StateGraph, START, END, MessagesState from langgraph.prebuilt import ToolNode, tools_condition from langgraph.types import interrupt # 检索 + 写作 + 人工确认 的骨架 def research(s: MessagesState): return {"messages": [model.invoke(s["messages"])]} def write(s: MessagesState): return {"messages": [model.invoke(s["messages"])]} def human_check(s: MessagesState): d = interrupt({"draft": s["messages"][-1].content}) return {} b = StateGraph(MessagesState) b.add_node("research", research) b.add_node("write", write) b.add_node("human_check", human_check) b.add_edge(START, "research") b.add_conditional_edges("research", tools_condition) # 检索循环 b.add_edge("tools", "research") b.add_edge("research", "write") b.add_edge("write", "human_check") b.add_edge("human_check", END) g = b.compile(checkpointer=MemorySaver())
# 跑一次:先检索聚合,再写作,最后人确认 from langgraph.types import Command cfg = {"configurable": {"thread_id": "r1"}} g.invoke({"messages": [("user", "总结量子计算进展")]}, cfg) # 第一次在 human_check 处 interrupt,返回待确认草稿 g.invoke(Command(resume="ok"), cfg) # 人点确认后继续到 END # 结构清晰、可恢复、可审计,长任务中途断点也能续
案例:上线后的两个改动
背景:用户反馈检索太慢、且想要引用来源,原图没接这些。
操作:检索节点加缓存与并行(第六章),写作节点要求输出引用段落。
结果:延迟降、答案可溯源,改动只落在两个节点。
解读:模块化让单点改进不影响全图,是图式编排的长期收益,也是它相对大单体 prompt 的优势。
变式:把写作拆成大纲-正文-校审三个专家(多智能体),质量再上一层,主图几乎不动。
工程清单
-
研究助手状态用 MessagesState 累积,检索节点调向量库,主管决定继续检索还是写作。
-
review 节点 interrupt 人工确认,检查点保证长任务可恢复,流式把生成推前端,各环节可单独替换。
-
模块化让单点改进不影响全图,是图式编排相对大单体 prompt 的长期收益。
常见误区
把检索与写作耦合在一个巨节点,任一处改都要重测整段;模块化让单点改进不影响全图,上线后加缓存、加引用只落在两个节点,这正是前面各章零件拼装的回报。
案例用到的零件对照
研究助手不是新概念,它是前面各章零件的一次拼装。把「哪个节点用了哪章的能力」列清楚,回查和维护都有抓手:
| 零件 | 落地位置 | 对应章节 |
|---|---|---|
| 消息状态 | MessagesState 累积对话与检索片段 | 4.1 |
| 检索节点 | 调向量库,结果写回消息 | 2.5、5.3 |
| 工具循环 | tools_condition 决定继续检索 | 5.1 |
| 人工确认 | human_check 节点 interrupt | 4.4 |
| 断点续跑 | checkpointer 配 thread_id | 4.3 |
| 流式输出 | 生成阶段 messages 模式 | 5.4 |
这张表本身就是架构文档:新同事接手时按表逐行读,先看章再读代码,比从入口读到底快得多。案例的价值就在这——它示范的是「零件如何按需选择」,而不是「这段代码怎么背下来」。
把案例改造成另一个系统
研究助手的骨架换成别的业务,只动节点不动结构。两个典型变体:
# 变体一:客服分流。research 换成分流节点,write 换成回复生成 b.add_node("triage", triage) # 意图分流 b.add_node("answer", answer) # 生成回复 b.add_node("human_check", human_check) # 复杂工单转人工
# 变体二:报告生成。加一个 gather 节点汇总多源检索 b.add_node("gather", gather) # 汇总所有检索片段 b.add_node("outline", outline) # 先出大纲 b.add_node("write", write) # 再写正文
改造的判断标准只有一个:新业务的控制流和原案例是否同构。同构就直接换节点实现,结构不动;不同构才动边。大多数常见业务(客服、报告、审批、问答)都落在「检索-决策-生成-确认」这个骨架里,学会识别同构,等于学会了快速搭建。
案例的测试策略
完整案例的测试分两层,缺一层都会在改版时吃亏:
# 第一层:结构测试,每个分支都能走到 def test_structure(): g = build_research_graph() g.compile() # 构造输入覆盖:检索循环、直接写作、人工拒绝三条路径 # 第二层:行为测试,关键节点用桩替换 def test_behavior(monkeypatch): monkeypatch.setattr(retriever, "search", fake_search) out = g.invoke({"messages": [("user", "测试")]}) assert "结论" in out["messages"][-1].content
结构测试保证「边没断」,行为测试保证「节点没写错」。行为测试里用桩替换模型与检索,测试就稳定且快速,不依赖真实服务。案例系统上线后,把每一条失败记录沉淀成测试输入,回归矩阵越滚越大,改图的安全感也随之上升。