7.2 LangGraph 社区与资源
7.2 LangGraph 社区与资源
去哪找资料与人
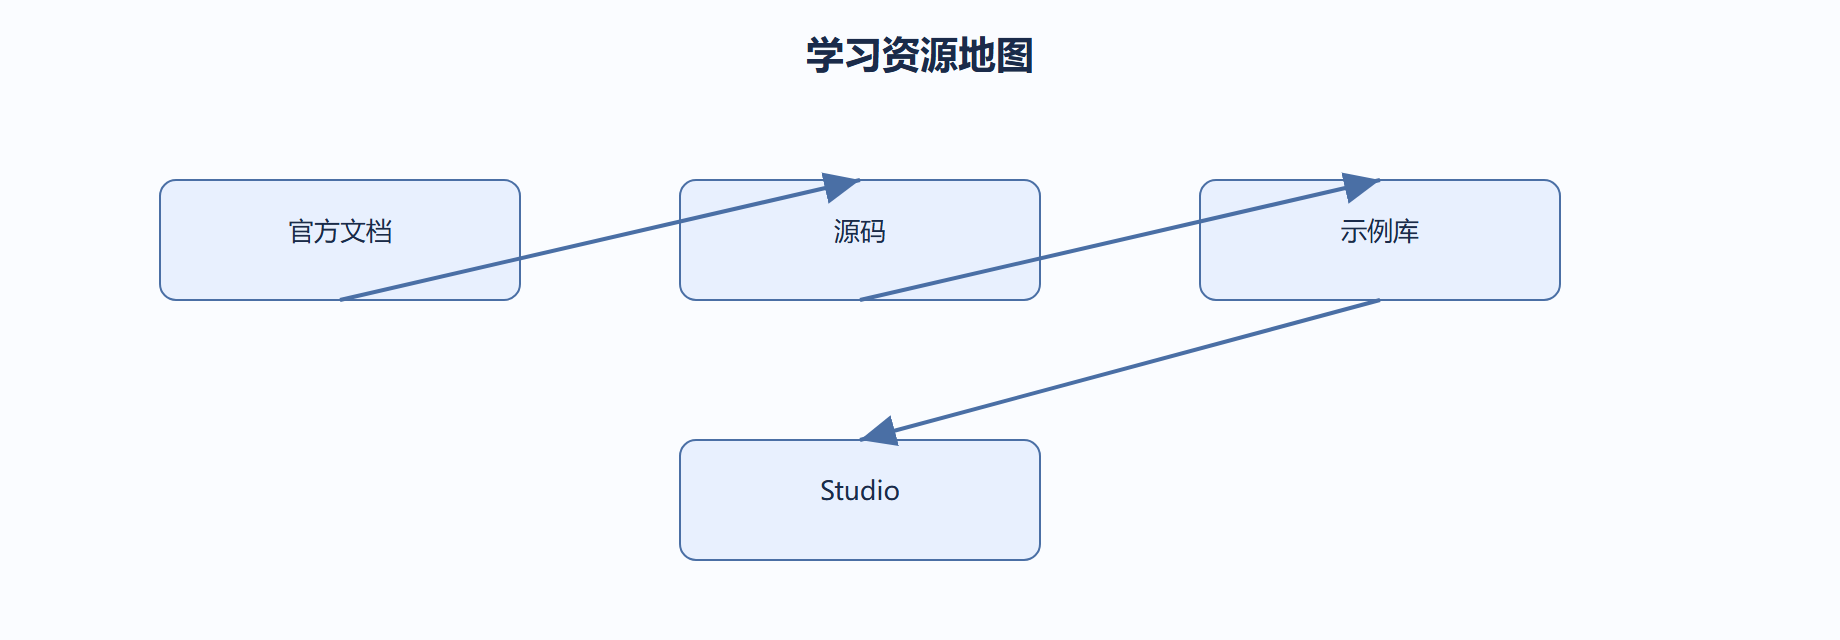
本节在全册位置:走出本教程。官方文档与源码是最权威的;GitHub 的示例库覆盖常见模式;LangGraph Studio 适合交互调试;社区论坛与讨论区能搜到真实踩坑。我们建议的学习顺序:先跑通预置智能体,再照案例改自己的图,最后才回看执行源码。
资源:文档、源码与模板
文档分概念篇与 API 篇,概念篇讲原理、API 篇查签名。示例库按场景组织(多智能体、人机协作、流式),可直接 fork。Studio 把检查点可视化,调试长图很省力。遇到问题先查 issue 与变更日志,再看源码——图的执行逻辑并不神秘。类比游戏:文档像攻略,源码像地图,社区像公会。把示例库当起点比从零写更稳。
# 用官方预置智能体快速起手,再改造 from langgraph.prebuilt import create_react_agent from langchain_openai import ChatOpenAI agent = create_react_agent(ChatOpenAI(model="gpt-4o-mini"), [search]) # 想加分支:拿它的图结构,add_conditional_edges 扩展 print(agent.get_graph().draw_mermaid())
# 模板的价值是省去结构摸索,精力放在业务节点
案例:照模板改出工单机器人
背景:团队要一个内部工单分流机器人,不想从零设计图结构。
操作:以多智能体模板为基,专家换成「分类/回复/升级」三节点。
结果:两天内可用,后续按反馈迭代,结构不用重来。
解读:模板的价值是省去结构摸索,精力放在业务节点,比造轮子快得多。
变式:把升级节点接人工确认(见 4.4),合规更稳,模板改一行即可。
工程清单
-
文档分概念篇与 API 篇,示例库按场景组织可直接 fork,Studio 把检查点可视化调试长图。
-
学顺序:先跑通预置 ReAct 智能体,再照案例改自己的图,最后才回看执行源码。
-
模板的价值是省去结构摸索,精力放在业务节点,比从零造轮子快得多。
常见误区
一上来读源码不求甚解,被执行细节劝退;先跑通模板再回看原理更高效,社区与 issue 往往比文档先给出真实踩坑的解法。
调试长图的工作流
遇到长图跑飞,最快的复盘是拿 thread_id 把那次运行完整回放,逐节点看状态。
# 用相同 thread_id 复现并逐步检查 cfg = {"configurable": {"thread_id": "case-7"}} g.invoke(bad_input, cfg) # 先复现 snaps = list(g.get_state_history(cfg)) # 拿全部快照 for i, s in enumerate(snaps): print(i, s.next, "->", s.values) # 看每步走向与状态 # 定位到某一快照后,可从该检查点续跑做修复验证
| 资源 | 适用阶段 | 用法 |
|---|---|---|
| 官方文档 | 入门 | 查概念 |
| 示例库 | 起手 | fork 改 |
| Studio | 调试 | 可视化回放 |
| 源码 | 深挖 | 看执行 |
⚠️ 常见坑:出问题时只改代码不回放,靠猜定位,反复试错;先用 thread_id 把那次运行拉出来,定位成本骤降。
💡 关键直觉:可复现是调试的前提,thread_id 就是那根能把任意一次运行「冻结」的线头。
学习路线四阶段
资源再多,没有顺序就容易半途而废。把学习路径切成四段,每段有明确产出,进度可感知:
| 阶段 | 做什么 | 产出 |
|---|---|---|
| 起手 | 跑通 create_react_agent | 一个能对话的智能体 |
| 改造 | 给模板加一个节点、一条边 | 属于自己的第一个图 |
| 深挖 | 读模板内部结构、改条件边 | 能解释每一步为什么 |
| 自研 | 从零建图,只查文档当参考 | 独立设计完整流程 |
关键在第二到第三段之间别断档:很多学习者停在「会跑模板」,卡在「不会改造」。中间的桥是「先打印模板结构,再动手加东西」——把 get_graph().draw_mermaid() 的输出当成学习材料,每看懂一个节点就往下推进一层。
从模板到自研的渐进路径
模板的价值是提供「标准答案」,但直接照抄会失去结构判断力。渐进路径是把模板当成脚手架逐层拆掉:
# 第一步:跑通模板,打印结构 agent = create_react_agent(model, tools) print(agent.get_graph().draw_mermaid()) # 第二步:把模板结构手工重写一遍,理解每个节点 b = StateGraph(MessagesState) b.add_node("agent", call_model) b.add_node("tools", ToolNode(tools)) b.add_conditional_edges("agent", tools_condition) b.add_edge("tools", "agent") b.add_edge("agent", END) # 第三步:替换成自己的条件边与节点 # 第四步:不再看模板,从状态设计开始独立画图
手工重写一遍的价值在于「被迫面对每个决定」:为什么 tools 要回 agent?为什么用条件边不用普通边?这些在模板里被隐去的决定,重写时会一一浮出来。走完四步,模板就不是拿来抄的,而是拿来验证自己设计的参照系。
提问与排障的技巧
在社区求助时,提问质量直接决定回复质量。一套高效的问题模板包含四要素:
# 问题模板:版本 + 图结构 + 复现 + 现象 # 1. 版本:langgraph 与 langchain 的版本号 # 2. 图结构:get_graph().draw_mermaid() 的输出 # 3. 复现:能跑的最小代码 + 输入 # 4. 现象:实际输出 vs 期望输出
不带结构图的问题,别人只能猜;不带最小复现的问题,别人没法验证。先把「是什么版本、结构长什么样、怎么复现、差在哪」四件事写清楚再提问,绝大多数问题在写的过程中自己就解决了——把问题讲清楚的过程,本身就是一次排障。
模板与示例的筛选标准
示例库资源很多,不是每个都值得花时间。用三个标准筛:结构是否与你的需求同构;是否配了检查点与持久化;是否持续维护、版本是否对得上。前两条决定「能不能直接改」,第三条决定「改了能不能长期跑」。版本对齐尤其容易被忽略——LangGraph 迭代快,照着旧版本示例写的代码,新版本可能已经改了 API。看示例时先看它的依赖版本声明,再决定照抄多少。花十分钟筛选,比花两小时改一个过时示例划算。