7.3 与 LangChain 生态的深度融合
7.3 与 LangChain 生态的深度融合
生态不是孤岛
本节在全册位置:LangGraph 与 LangChain 共享状态与组件。模型、检索器、记忆、工具全部复用;LangSmith 同时观测链与图;LangServe 可把图当 API 部署。融合的意义是「不重复造轮子」。我们认为生态融合度,直接决定你上线要写多少胶水代码。
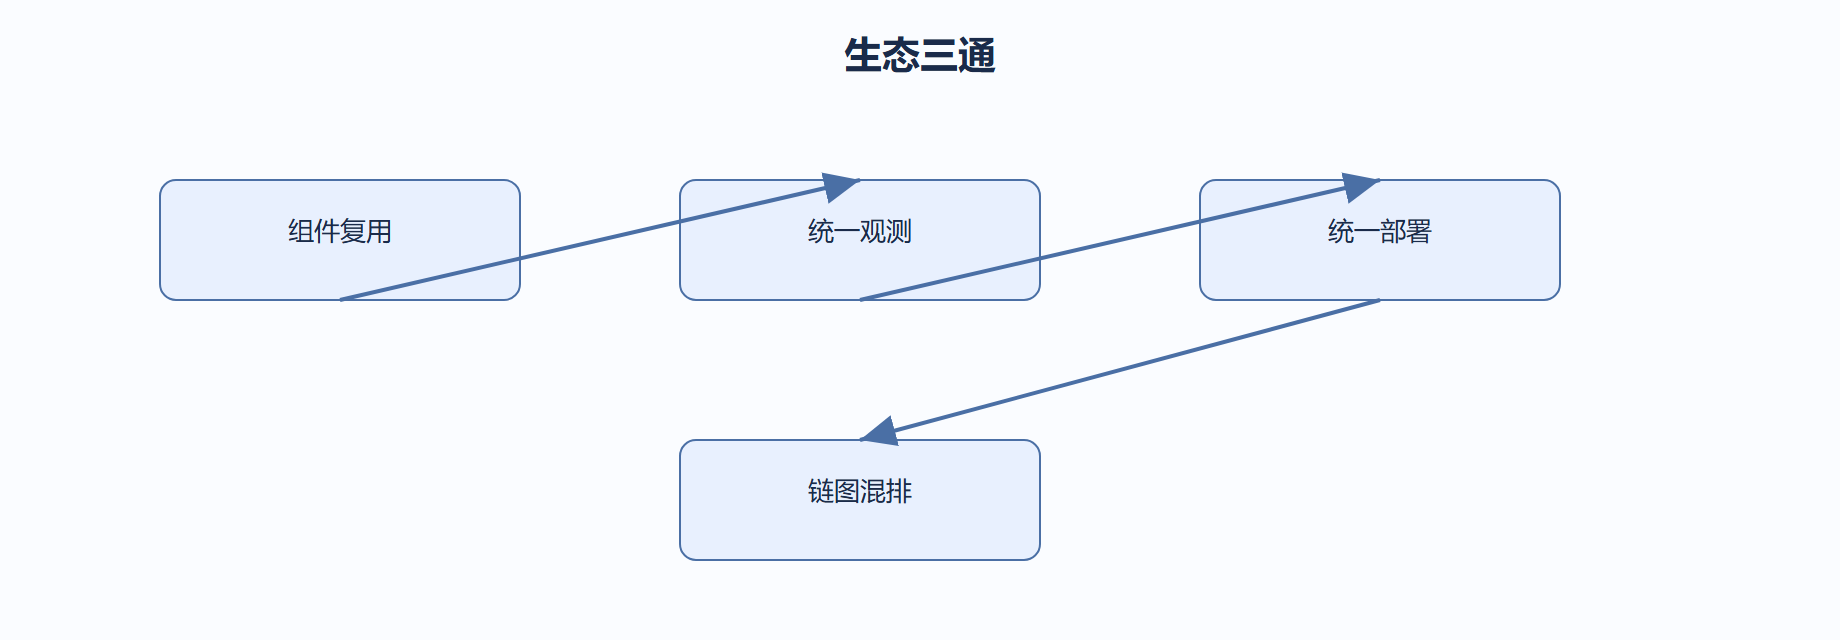
融合:组件、观测、部署三通
组件层:任意 Runnable 即节点,向量库即检索节点。观测层:LangSmith 把链与图的运行统一成 trace。部署层:LangServe 暴露图,前端无感调用。这样一条链路可前半段用链、后半段用图,按阶段选型。类比金融:生态像同一清算网络的多个产品。链图混排契约一致,是成熟做法。
# 复用 LangChain 记忆做长期用户画像 from langchain_community.chat_message_histories import RedisChatMessageHistory history = RedisChatMessageHistory(session_id="u1", url="redis://localhost") # 记忆与编排解耦,记忆可独立替换
# 链与图混排:前处理用链,复杂决策用图 from langchain_core.runnables import RunnableLambda pre = RunnableLambda(clean_input) # 链 post = g # 图(已编译) pipe = pre | post # 直接拼,契约一致 # 不必全图或全链,按段选型
案例:链图混排管线
背景:输入清洗固定,但决策复杂要循环,硬塞进图反而别扭。
操作:清洗用链,决策用图,竖线相接。
结果:各自用最合适的抽象,整体仍是一条管线,可读性好。
解读:不必「全图」或「全链」,按段选型是成熟做法,胶水代码最少。
变式:把图作为链的一个步骤嵌入更大 LangServe 服务,对外只暴露一个端点。
工程清单
-
组件层任意 Runnable 即节点,向量库即检索节点,观测层 LangSmith 统一 trace 链与图。
-
部署层 LangServe 暴露图,前半链后半图按阶段选型,契约一致胶水代码最少。
-
生态融合度直接决定上线要写多少胶水代码,复用比自研检索/记忆更稳。
常见误区
为了统一硬把固定清洗也塞进图,失去链的简洁;前半链后半图才是成熟做法,把图作为链的一个步骤嵌入更大 LangServe 服务,对外只暴露一个端点。
在 LangServe 中暴露图
图写好后,用 LangServe 把它当成一个 Runnable 端点对外提供,前端无感调用链或图。
# 把编译好的图直接交给 LangServe from langserve import add_routes from fastapi import FastAPI app = FastAPI() add_routes(app, g, path="/agent") # g 是已编译图 # 链与图用同一套接口,前端不用改
| 融合层 | 复用内容 | 收益 |
|---|---|---|
| 组件 | 模型/工具/检索 | 不重造 |
| 观测 | LangSmith trace | 统一 |
| 部署 | LangServe | 同接口 |
⚠️ 常见坑:为了「纯图」把本可用 LangChain 组件的地方重写一遍,既慢又易错;能复用的组件直接当节点,融合度越高胶水越少。
💡 关键直觉:生态融合的衡量标准是「上线要写多少胶水代码」,复用比自研稳,也更快。
组件复用的典型场景
哪些东西值得从 LangChain 生态复用,哪些该自己写,一张表说清:
| 组件 | 复用方式 | 自研的代价 |
|---|---|---|
| 模型接入 | 直接用 ChatOpenAI 等 | 适配各家协议,维护量大 |
| 检索器 | 向量库封装直接用 | 索引与召回自己实现 |
| 消息历史 | RedisChatMessageHistory 等 | 持久化与并发自己扛 |
| 输出解析 | PydanticOutputParser | 解析与校验自己写 |
| 工具定义 | @tool 自动推导 schema | schema 手工维护 |
判断标准:组件是否稳定、是否被广泛使用。稳定的通用件(模型、解析、历史)直接复用;领域特有、变数大的逻辑(业务规则、流程编排)自己写。别为「不用别人的东西」而自研,也别为「用生态」而强行套不适配的组件,两条路都会多写胶水。
记忆集成的两种方式
记忆是智能体常见需求,LangChain 提供历史存储,但集成方式有两种,别搞混:
# 方式一:外部历史存储,与图状态解耦 # 每次调用前把历史拉进消息,调用后把新消息写回 history = RedisChatMessageHistory(session_id="u1") msgs = history.messages + [current_input] # 方式二:图状态内累积,靠检查点持久化 # 消息就在状态里,thread_id 即会话标识
方式一适合「记忆生命周期独立于运行」的场景:同一个会话跨多个图、多个服务共用历史。方式二适合「记忆跟着运行走」的场景:图内累积,恢复时随检查点一起回来。选哪种看记忆归谁管:归业务系统就方式一,归图运行就方式二。两者也可以并存——短记忆在状态里,长记忆在外存,分层使用是成熟做法。
混排管线的测试与契约
链图混排之后,测试的边界要重新划。混排管线里链与图各自已有测试,新增的是「接口衔接」的测试:
# 契约测试:链的输出字段,图能直接作为输入 def test_chain_graph_interface(): pre_out = pre.invoke({"raw": " 你好 "}) assert "input" in pre_out # 链输出契约 graph_out = g.invoke(pre_out) # 图接受该字段 assert "answer" in graph_out # 图输出契约
# 字段改名是混排最常见的断裂点: # 链输出 call_input,图输入 q,中间必须有一层映射
契约测试要锁住两点:字段名不漂移、类型不变。只要契约测试绿着,链图各自随便改内部实现都不怕。这也是混排相对大单体最实在的好处——内部自由,接口稳定,两边可以独立演进。
渐进式引入图编排
在既有 LangChain 项目里引入 LangGraph,不必推倒重来,按「由外到内」的次序渐进改造:第一步,把现有链原样包成图节点,图结构先搭起来,行为不变;第二步,在图上新增一条分支或循环,尝到控制流红利;第三步,把重复出现的手写状态管理替换成状态通道。每一步都能回退、都可单独上线,改动面控制在单点。这样引入图的成本最低,团队对图的价值建立信心后,再决定要不要把更多逻辑迁移进来。