3.3 Python API编程指南
API 是能力暴露的边界
在实践的第三步,我们把 LEANN 接进真实业务。API 设计的核心取舍是:暴露足够能力,但把索引、重排这些细节藏起来,让调用方只关心「问」和「答」。
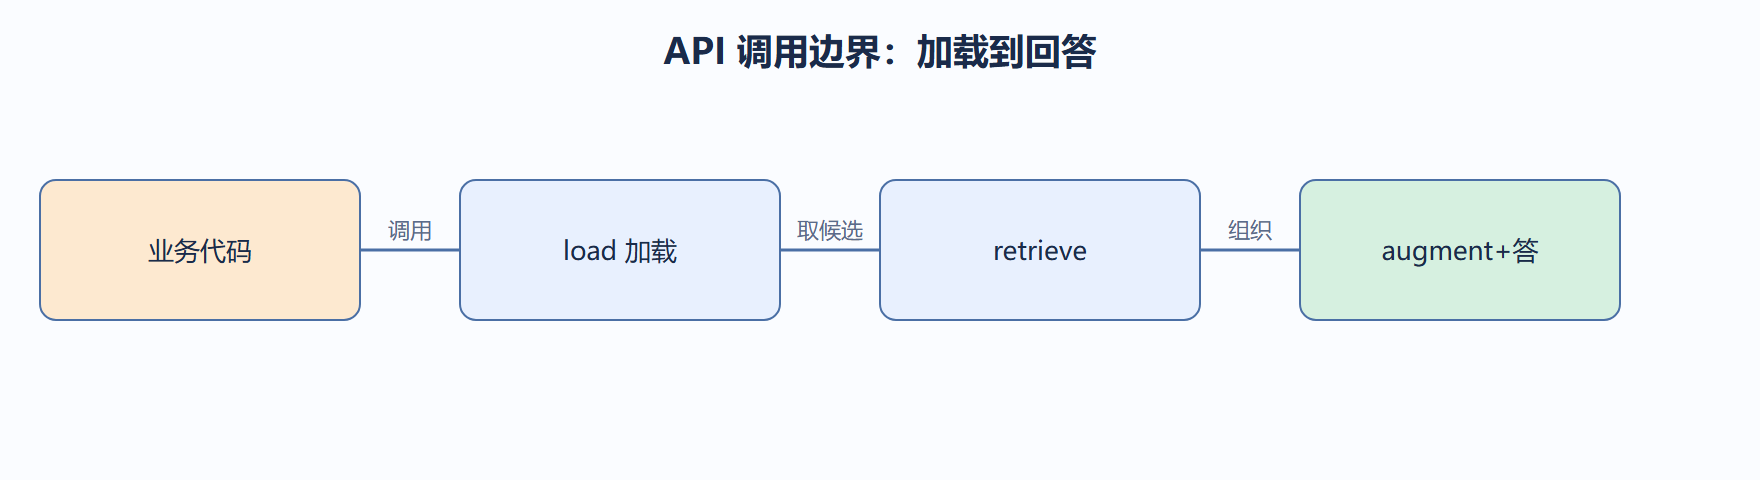
下面给出一段最小可运行的 API 用法。我们刻意让它读起来像「加载→检索→增强→回答」四步,和架构主线一致。
from leann import LEANN app = LEANN.load('idx/manual_v2') # 加载索引与重排头 hits = app.retrieve('主轴异响怎么处理', top_k=5) answer = app.augment(hits, style='concise') print('检索命中:', [h.text[:20] for h in hits]) print('生成答案:', answer)
retrieve 内部做了「多召回 + 重排」,augment 决定答案的组织方式。把这两步分开,业务方可以只取检索结果做别的事(比如给人工复核),不必走完整个链路。
下面用 mermaid 把 API 调用的数据流画出来,方便你向团队协作时解释边界。
进阶一点,我们用上下文管理器保证索引资源正确释放,边缘端内存紧,这点很关键。
from contextlib import contextmanager @contextmanager def leann_session(path): app = LEANN.load(path) try: yield app finally: app.close() # 释放索引内存,避免边缘端泄漏 with leann_session('idx/manual_v2') as app: print(app.retrieve('如何更换滤芯', top_k=3))
案例:漏关索引导致内存泄漏
- 背景:服务长期运行,每来一个请求 load 一次索引,从不 close。
- 操作:用上面的
leann_session上下文管理器包裹,请求结束即释放。 - 结果:常驻内存从持续上涨变为稳定,设备不再周期内 OOM。
- 解读:边缘端没有「无限内存」兜底,资源释放必须写进 API 使用规范。
- 变式:若并发高,可改为进程级常驻单例,避免反复 load 的开销。
API 方法清单
把 LEANN 的公开方法列一张表,写代码前先对照:
| 方法 | 职责 | 常用参数 | 返回 |
|---|---|---|---|
| load | 加载索引与重排头 | path | app 实例 |
| retrieve | 多召回 + 重排 | query, top_k, ef | 候选列表 |
| augment | 组织答案 | hits, style | 文本 |
| close | 释放资源 | 无 | 无 |
这张表也是职责划分的速记:retrieve 管找,augment 管写,load 与 close 管生命周期。四个方法分别对应架构层的数据流,和第二章的模块一一对应。
参数怎么传:三个高频旋钮
top_k 决定最终返回条数;ef 控制检索深度,越大越准越慢,对应 2.4 的 ef_search;style 决定答案组织方式,concise 给短答,verbose 给带引用的长答。经验起点:top_k=5、ef 用索引默认值、style 按业务终端尺寸选。三个参数都可以在调用时覆盖配置,不必为不同场景维护多份代码。
错误处理:区分「调用错」与「数据错」
API 编程里两类异常要分开处理:参数错(top_k 传负数、path 不存在)应尽早抛出并返回明确信息;数据错(个别文档向量缺失、索引损坏)应给出可恢复路径而不是让进程崩溃。下面给出带兜底的调用封装。
def safe_retrieve(app, q, **kw): try: return app.retrieve(q, **kw) except KeyError as e: return [] # 数据错:返回空结果,调用方决定兜底文案 except ValueError as e: raise # 参数错:直接抛,问题在调用方
区分两类错误的收益是:线上偶发数据问题不至于拖垮服务,参数错误会在开发期被立刻发现。养成在调用入口做这一层分流的习惯,排障时能省一半时间。
并发与批处理
边缘端并发度通常不高,但一批查询同时来也要顶住。原则是复用同一个 app 实例,而不是每请求 load 一次——load 的开销远大于检索本身。若多个查询无依赖,可以并行发出,但要控制并发数,避免内存瞬间打满。
from concurrent.futures import ThreadPoolExecutor def batch_retrieve(app, queries, workers=4): with ThreadPoolExecutor(max_workers=workers) as ex: return list(ex.map(lambda q: app.retrieve(q, top_k=3), queries))
并发数 workers 从 4 起步,实测内存与延迟后再上调;边缘端 CPU 核数少,超过核数反而因线程切换变慢,得不偿失。
升级时的兼容性纪律
API 升级最常见的破坏是「参数被删」。给团队立三条规矩:新增参数用默认值保证向后兼容;删除参数先废弃一个版本再移除;每个版本在变更说明里标注破坏性变更。边缘端设备升级成本高,一次不兼容的 API 改动可能让大量存量设备无法升级,破坏性变更必须慎重。
调用方不该知道的事
API 的边界在于「藏什么」。调用方不该知道索引是 HNSW 还是 IVF、不该知道候选池取了 top_k 的几倍、不该知道重排头的网络结构——这些是实现的自由,今天换掉都不该影响调用方。如果发现业务代码开始 import 内部模块直接调 embed 或 index,说明边界被突破了,把那个调用挪回 API 内部,而不是让它扩散。
从 API 到生产:三个红线
- 索引目录用版本号命名,避免 load 到半新不旧的索引。
- retrieve 的返回对象带上来源元数据(doc_id、更新时间),排障时能定位问题文档。
- 所有调用记日志但别记原文全文,边缘端存储容量和合规要求都不允许。
本节可考核点:能描述 retrieve 与 augment 的职责划分,并解释为何边缘端要显式管理索引资源释放。