- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
LEANN 轻量级神经网络架构教程
本册讲的是一件具体的事:怎样把一个「检索增强」的智能能力,塞进算力只有手机、树莓派量级的设备里。它不是又一本罗列 API 的文档,而是沿着「轻量神经架构」这条主线,把概念、架构、动手、检索、优化、社区六段路一次走完。
我们为什么坚持用「轻量」这个词?因为边缘端的约束是硬性的:内存按兆算、电池按毫安时算、延迟按毫秒算。把云端那套动辄几十亿参数的做法直接搬过来,工程上不成立。LEANN 的思路是让一个小神经网络只负责「重排与融合」,把「记忆与检索」交给外部向量库——分工之后,模型本体可以压得很小。
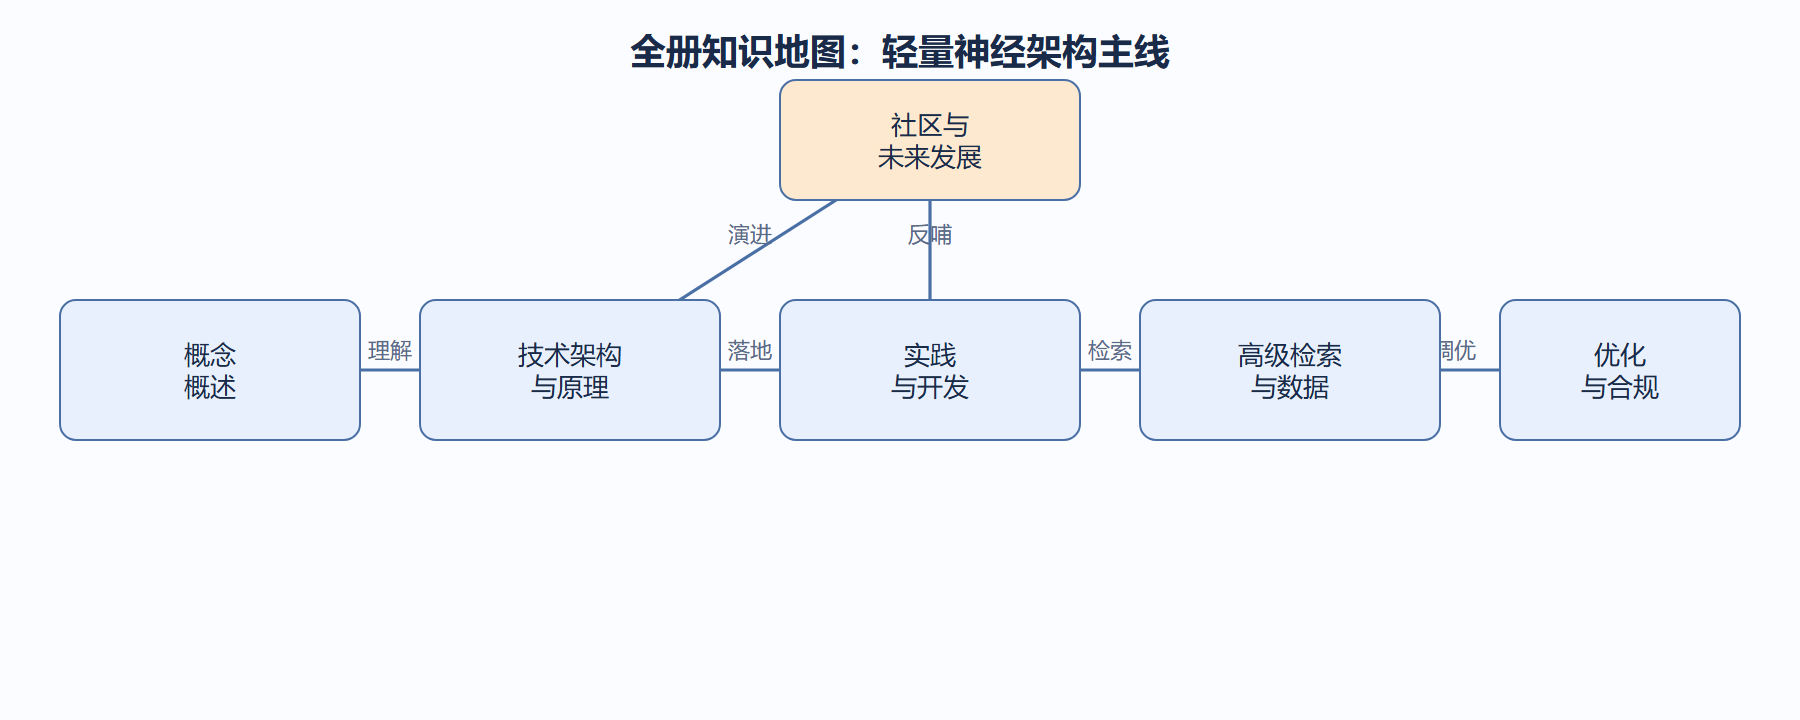
这张图是全册的骨架。第一章把「轻量神经架构」是什么、为什么存在讲清楚;第二章拆解它的内部构造;第三章带你把环境跑起来、把代码写出来;第四章进入检索核心,这是它和纯神经网络最大的不同;第五章谈性能、监控与合规;第六章回到社区,看它往哪里走。
我们建议两种读法。第一种是顺序通读,适合第一次接触轻量神经架构的人,按图上的箭头走不会迷路。第二种是带着问题跳读:如果你只关心「怎么在设备上做检索」,直接进第四章;如果你已经被延迟和显存卡住,直接看第五章。「详见第4章」这类引用会帮你随时回到上下文。
本册默认你写过 Python、知道什么是向量和矩阵乘法,但不要求你做过嵌入式部署。凡是涉及部署的细节,我们会标注清楚是「云端验证」还是「边缘端实测」,因为两者的坑完全不一样。
最后说一句我们的取向:本册不堆砌术语,遇到一个概念先讲它解决什么工程问题,再给能跑的代码片段,最后用案例把坑点摊开。你读完合上电脑,应该能独立搭出一个能在边缘端回答问题的检索增强原型。
六章怎么串成一条线
我们按「为什么 → 是什么 → 怎么建 → 怎么查 → 怎么快 → 往哪走」组织内容,这条线不是拍脑袋定的,而是复刻了你从立项到上线的真实路径。
- 第一章先解决「要不要用」:什么场景值得上 LEANN,什么场景用它反而是负担,给你一把两轴判定尺。
- 第二章解决「它内部长什么样」:嵌入、索引、检索、重排四块各管什么,数据怎么流、在哪里拐弯。
- 第三章解决「怎么跑起来」:环境、命令行、Python API、配置,四步从零到可用,代码可以直接抄。
- 第四章解决「怎么用得深」:近似最近邻、过滤聚合、混合检索、增量更新,让检索从「能跑」变「跑得对、跑得久」。
- 第五章解决「怎么扛得住」:性能调优、监控排查、安全合规、真实行业案例,让你敢上生产。
- 第六章解决「怎么走下去」:社区贡献、生态扩展、路线图,看完你知道下一步往哪深化。
三条阅读路线
按你的背景,我们推荐不同路径,不必从头到尾硬啃。
- 从零开始的初学者:按第一到第六章顺序通读。每章先看章支柱页的思维导图建立全局,再逐节推进;看完一节就回答节末的可考核点,答不上来就回头重读。
- 后端或算法工程师,目标是把检索能力接进现有系统:可直接从第二章起步,第三章的 API 编程是落地核心,第四、五章是上生产前必须补的课。
- 运维或技术决策者,关心「值不值、稳不稳」:重点读第一、五章,把章支柱页的评估问题过一遍,再跳读 5.4 的行业案例看真实收益。
动手前的准备
学习本册只需一台能跑 Python 的机器;树莓派或开发板用于验证边缘端效果,但不是必须。建议先装好 Python 3.9 以上环境,并准备一个几十篇文档的小语料集,用来随堂练习建索引和检索。全册代码都以 numpy 自包含实现为主,不依赖重型框架,拿到即跑。凡是涉及部署的细节,我们都会标注「云端验证」还是「边缘端实测」——两条路上的表现差异很大,读的时候留意这个标记。
全册共六章、二十三节。我们把每章的可考核知识点列在章支柱页,方便你自检是否真的掌握,而不是「好像看懂了」。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...