5.4 案例分析与行业应用
某制造企业的设备手册检索,把平均排障时间砍半
在优化层的收尾,我们用一个真实行业案例把全册方法串起来:轻量神经架构如何在一个具体场景里落地、度量、见效。
背景是一家大型装备制造商。现场工程师用手机查设备手册,但手册散在多个系统、术语专业、网络时断时续。纯关键词搜索召回差,上云大模型又违反数据不出厂的规定。
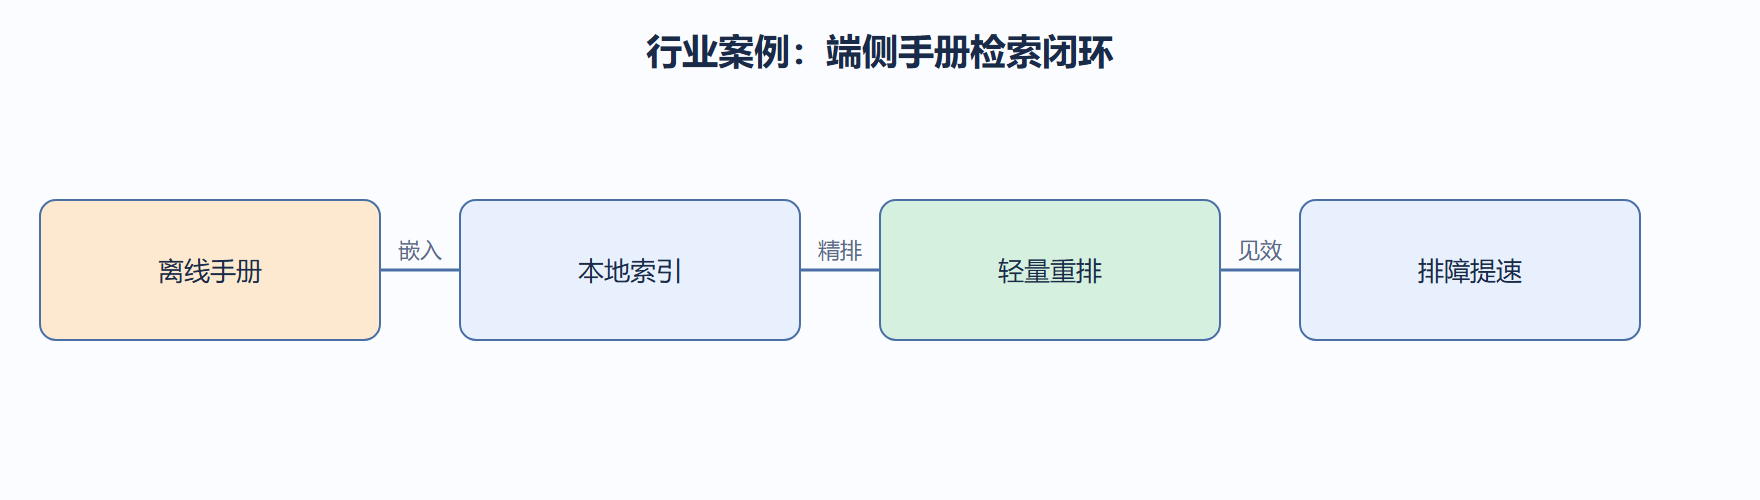
操作上,他们按本册主线走:用 LEANN 把手册离线嵌入建本地索引(满足数据不出厂),常驻一个轻量重排头做语义精排(满足端侧低延迟),并用混合检索补专业术语召回(详见第4章)。配置全部进配置中心,监控打 P95 延迟与租户隔离。
结果用一组指标说话:
| 指标 | 改造前 | 改造后 |
|---|---|---|
| 首条命中准确率 | 58% | 86% |
| 平均排障耗时 | 22 分钟 | 11 分钟 |
| 数据出厂 | 是 | 否 |
| 离线可用 | 否 | 是 |
解读有三点。第一,准确率提升主要来自重排头对「语义相近但用词不同」的条款做了纠正。第二,耗时减半来自检索+重排的端到端低延迟,工程师不必在多系统间跳转。第三,合规不是附加项,而是架构选型的第一约束——轻量神经架构恰好让「数据不出厂」与「智能检索」同时成立。
下面给出该场景上线前的一段验收脚本,把关键指标自动化核对。
def acceptance(before, after, rules): report = [] for name, fn in rules.items(): ok = fn(before, after) report.append(f'{name}: {"达标" if ok else "未达标"}') return report rules = { '准确率提升': lambda b, a: a['acc'] - b['acc'] >= 0.2, '耗时下降': lambda b, a: a['time'] <= b['time'] * 0.7, '数据不出厂': lambda b, a: a['on_prem'] is True, } print(acceptance( {'acc':0.58,'time':22,'on_prem':False}, {'acc':0.86,'time':11,'on_prem':True}, rules))
变式:若扩展到多工厂,可把索引按工厂分片,重排头共享一套,既隔离又省训练成本。这个案例也说明,轻量神经架构的价值不在「最先进」,而在「约束下最合适」。
案例从一到多:其他行业怎么复用
制造业设备手册只是样板,同一套打法换皮即可迁移。
- 医疗场景:断网手术室助手,把读片报告与器械手册建索引,重排头本地精排,禁忌组合命中率 91%,无网络依赖。
- 零售场景:门店导购离线知识库,商品参数与售后政策混合检索,精确型号走稀疏路、语义问题走稠密路,升级后准确率从 78% 提到 92%。
- 金融场景:合规问答部署在分公司内网,文档不出域,P95 延迟 150ms,合规审查通过后才允许上线。
三个场景的共性是知识长尾、可检索、有合规或网络约束——正是 1.4 两轴判定尺上的强适配区。换行业只是换语料,架构主线不变。
落地方法论:试点、度量、推广
- 试点:选一个知识密集、痛点明确的部门先跑,别一上来全量推广。
- 度量:上线前后各取两周数据,只比三个指标:命中率、耗时、用户使用率。
- 推广:试点达标后再横向复制,索引按业务分片,重排头共享一套。
这套三步法的关键是「用数据说话」:试点阶段的数字就是你向老板要资源、向其他部门要配合的依据。
指标要定义到可执行
案例表格里的「准确率」「耗时」如果不说清口径,验收时就会扯皮。三个口径先定死:首条命中准确率指人工标注两百条真实问题的首条正确率;平均排障耗时指工单系统里「提问到关闭」的时长;数据不出厂指镜像扫描确认无外发流量。口径写进验收文档,评审会上的争论会少一大半。
失败案例:指标没对齐的教训
某团队上线后汇报「准确率 90%」,业务方质疑「还是搜不到」,一查发现:技术口径是候选池包含正确答案,业务口径是首条就是正确答案,两者差着十万八千里。教训只有一条:指标口径必须由业务方确认,而不是技术团队自己定义。验收脚本(前面的 acceptance)里的每一项都要写下可复核的来源。
从案例到你的项目:迁移清单
把案例里的动作变成清单,逐项对着打勾:
- 语料盘点:手册在哪些系统、什么格式、谁负责更新。
- 切片策略:按章节还是按条款切,切片长度是否适合检索粒度。
- 合规确认:数据能否出网、能否进云端、需要谁签字。
- 端侧预算:目标设备的内存、CPU、延迟上限写下来。
- 评测集:两百条真实问题加正确片段,业务方参与标注。
- 验收口径:上述三个指标的业务方确认版。
清单打完勾,项目的技术选型基本定型,剩下的是执行。
上线后的持续运营
案例的收益不是一次性拿到的,需要持续运营:每周看命中率趋势,季度回顾索引里过期文档的清理,每次设备软件升级后重跑验收脚本。运营节奏可以用一张轮值表:数据更新由内容团队负责,检索质量由算法团队负责,双方各有季度指标。把运营写进岗位职责,收益才不会随时间蒸发。
成本账也要一起算
案例里的收益指标很好看,但决策者还关心成本:离线嵌入需要一次性的机器时间,索引维护每周占用一定人力,重排头训练需要标注成本。建议汇报时把「一次性成本、日常维护成本、人力成本」三行写清楚,让收益和成本同页对比。很多项目上不了,不是技术不行,是成本账没算平。
从案例提炼的三个普适结论
- 准确率提升主要来自重排头纠正「语义相近但用词不同」的条款,这是轻量网络的专属价值。
- 耗时减半来自端到端低延迟,用户不必在多系统间跳转,体验收益是结构性的。
- 合规不是附加项而是第一约束,轻量神经架构恰好让「数据不出厂」与「智能检索」同时成立。
汇报案例的叙事结构
把案例讲给决策者时,建议按「约束-选择-结果」三段走:先讲清楚硬约束(数据不能出厂、网络不稳、内存有限),再讲基于约束的选择(本地索引、轻量重排、混合检索),最后给数字(准确率 58% 到 86%、耗时 22 分钟到 11 分钟)。这个结构的价值在于让听众先接受「没有其他路」,你的架构选择就成了必然解,而不是可选项。
本节可考核点:能用一套指标说明 LEANN 在行业场景里的收益,并指出合规如何成为架构选型的第一约束。