1.1 核酸结构与功能
1.1 核酸结构与功能
本节摘要:核酸是储存与传递遗传信息的一类大分子,分为 DNA(脱氧核糖核酸)与 RNA(核糖核酸)两种。两者的基本单元都是核苷酸——由含氮碱基、五碳糖和磷酸基团三部分拼成;区别只在糖的 2 号位那一个氧原子。碱基遵循互补配对(A 与 T 或 U、G 与 C),让 DNA 能一边稳定存储、一边精确复制。DNA 的经典形态是反向平行的双螺旋,RNA 则多为单链、可折叠成各种构象去执行任务。读懂这些结构,是理解复制、转录、翻译乃至基因编辑的共同起点。
学习目标
阅读完本节,你应当能够:
- 说出核苷酸的三个组成部分,以及 DNA 与 RNA 在五碳糖和碱基上的两点差异。
- 解释脱氧核糖缺少 2 号位羟基,为什么让 DNA 比 RNA 更稳定。
- 用互补配对规则说明 A-T 两对氢键、G-C 三对氢键各自意味着什么。
- 描述 DNA 双螺旋的反向平行与方向性(5 端到 3 端),并指出大沟小沟的用途。
- 举例说明 RNA 单链折叠出的结构如何反过来承担催化与调控功能。
一、从"核素"到双螺旋:为什么偏偏是核酸
1869 年,瑞士人米歇尔从外科绷带的脓细胞里分离出一种含磷的黏稠物质,他叫它"核素"。当时没人觉得这东西了不起——大家的目光都盯着蛋白质,因为蛋白质种类多、花样足,看起来才像是能装下遗传秘密的分子。这个偏见一直拖到 1944 年,艾弗里用肺炎球菌做的转化实验才把证据摆到桌面上:真正能改变细菌遗传性状的,是 DNA。
再往后就是教科书里那一段了。1953 年,沃森和克里克在剑桥搭出了双螺旋模型。这个模型的厉害之处,不在于它多漂亮,而在于它一眼就说清了复制是怎么回事——两条链互补,拆开各自做模板,就能得到两条一模一样的。换句话说,双螺旋不是被"设计"成那样的,而是"存储加复制"这个需求唯一能落地的化学答案。
我们今天回头看,会觉得核酸天生就该是遗传物质。可站在 1940 年代,DNA 不过是一串看起来单调乏味的磷酸糖骨架加上四种碱基。科学史在这里给我们的教训很实在:信息的载体,往往不是那个花样最多的分子,而是那个最稳定、最不容易写错的分子。
二、三种零件与一根骨架:核苷酸的构造
核酸虽然长得像一条很长很长的链,拆到最小,其实只由一种"积木"反复连接而成,这种积木叫核苷酸。每个核苷酸由三部分组成:一个含氮碱基、一个五碳糖、一个到三个磷酸基团。碱基负责携带信息,糖和磷酸负责搭骨架,三者的分工清清楚楚。
DNA 和 RNA 的第一个区别在糖上。DNA 用的是脱氧核糖,2 号位碳上挂的是一个氢原子;RNA 用的是核糖,2 号位挂的是一个羟基。就差这一个氧原子,两种分子的脾气完全不同。脱氧核糖没有那个多余的羟基,磷酸二酯键在碱性条件下不容易被攻破,所以 DNA 能安安静静地存在很多年,适合当档案。RNA 多出来的那个羟基,让它动不动就自我水解、断成几截,因此 RNA 在细胞里是个"临时工"——需要的时候合成,用完就降解。这种脆弱不是缺陷,反而正好是 RNA 要干动态活儿的化学前提。
第二个区别在碱基。DNA 用腺嘌呤 A、胸腺嘧啶 T、鸟嘌呤 G、胞嘧啶 C 这四种;RNA 把 T 换成了尿嘧啶 U。四种字母,两两配对,就够写下一整本生命的书。骨架本身不携带信息,信息全写在碱基的排列顺序上——这种"骨架与信息分离"的设计,是后面讲复制、转录、修复都绕不开的一条线索。
核苷酸之间靠磷酸二酯键首尾相连:一个核苷酸的 3 号位羟基,接下一个核苷酸的 5 号位磷酸。这样连出来的链就有了方向——一头叫 5 端,一头叫 3 端。这个方向不是随便标注的记号,它直接决定了 DNA 聚合酶、RNA 聚合酶往哪个方向走,也决定了后面讲转录、翻译时很多规则为什么是"单向"的。
还有一点值得单独拎出来:磷酸基团带负电。整条核酸因此是一根带负电的链子,这个性质在实验室里天天被用到——凝胶电泳就是让核酸在电场里跑,靠负电驱动,按长短分开。在细胞里,这条负电链子也不能光着身子待着,得靠带正电的组蛋白把它缠绕、打包,才能塞进小小的细胞核。骨架不携带信息,却决定了核酸的物理脾气,这正是"骨架与信息分离"设计最直观的体现。
三、碱基互补配对:两张氢键与三张氢键的账本
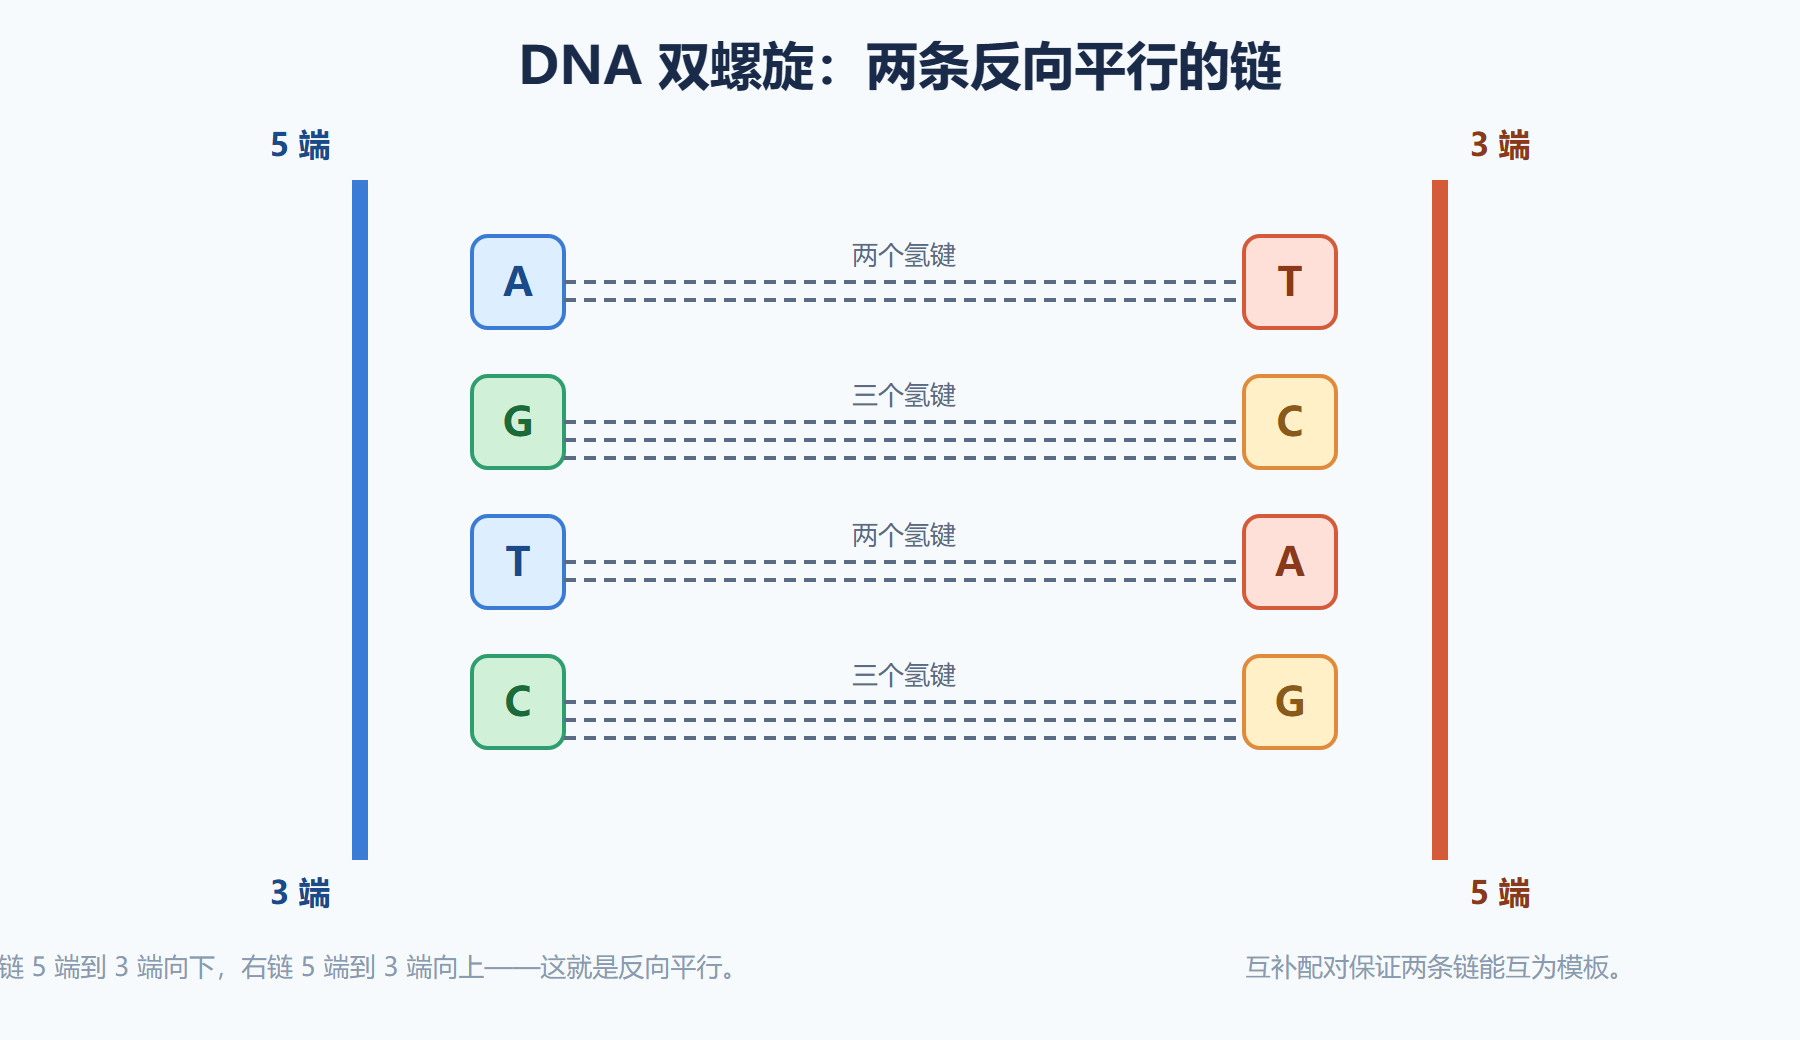
互补配对是分子遗传学里最值钱的一条规则。A 与 T(在 RNA 里是 U)之间形成两个氢键,G 与 C 之间形成三个氢键。两个和三个,看起来只差一个,实际影响很大:G-C 含量高的 DNA,解链温度更高,双链更"结实"。
但互补配对并不是双螺旋稳定性的全部来源。碱基都是扁平的芳香环,它们在双螺旋内部一层层"堆叠"起来,靠的是疏水作用——这种堆叠对稳定性的贡献,甚至超过氢键。可以这么想:氢键负责"配得对",堆叠负责"抱得紧",两者一起,才让双链既准确又稳固。
这条规则的价值不止于稳定。复制的时候,模板链上的 A 只会引来 T,G 只会引来 C,于是新链必然是旧链的精确互补;转录的时候,同样的规则把 DNA 的信息抄成 RNA。可以说,互补配对就是分子世界里一台"纠错复印机"的工作原理。它也是实验室技术的根:PCR 靠引物与模板的互补来特异性扩增,杂交探针靠互补来锁定目标序列,一代代的分子诊断都站在这一条规则上。
不过生命从来不把规则用死。RNA 世界里还有摆动配对,允许 tRNA 的反密码子与 mRNA 密码子的第三位"睁一只眼闭一只眼",用少数几种 tRNA 就能覆盖全部密码子;DNA 在特殊条件下还能形成 Hoogsteen 配对、三链结构。这些例外不是捣乱,而是告诉我们:配对规则是主干,但主干之外留着不少灵活的旁路,供不同场景使用。
| 对比项 | DNA | RNA |
|---|---|---|
| 五碳糖 | 脱氧核糖(2 号位无羟基) | 核糖(2 号位有羟基) |
| 碱基 | A、T、G、C | A、U、G、C |
| 常见形态 | 双链双螺旋为主 | 单链,可折叠成茎环等 |
| 化学稳定性 | 高,适合长期存储 | 较低,适合瞬时调控 |
| 主要分工 | 遗传信息的档案库 | 信使、转运、催化、调控 |
💡 记不住 DNA 和 RNA 谁稳定?就记"少一个氧,多一份稳"。脱氧核糖比核糖少一个氧原子,代价就是 DNA 更耐放、RNA 更灵活。
这条规则还有个很实际的用途:算 GC 含量。因为 G-C 对有三个氢键、更结实,一段序列里 G 和 C 的比例越高,双链就越难拆开,解链温度也就越高。做 PCR 时,引物设计要拿捏 GC 含量——太低结合不稳、太高又容易非特异结合;设计杂交探针、做荧光原位杂交,同样要在这个平衡上做文章。一个看似课本上的化学事实,落到实验台上就是一把每天都在用的尺子。
四、双螺旋与单链折叠:结构如何决定功能
DNA 的经典形态是 B 型双螺旋:右手螺旋,每圈大约 10.5 个碱基对,表面有宽窄不同的两条沟——大沟和小沟。两条链反向平行,一条走 5 到 3,另一条走 3 到 5。大沟足够宽,转录因子等调控蛋白会把识别用的结构伸进去,沿着碱基边缘的氢键供体和受体"摸"出序列来。所以大沟不只是个物理凹槽,它是蛋白读取序列的窗口,相当于书页上留给批注的空白边。
DNA 也不是永远这副样子。高盐或脱水条件下,它可能翻转成左手的 Z 型;富含 A-T 的区域容易弯曲;端粒上那串重复序列则喜欢叠成四链的 G-四链体。这些非常规结构常常出现在调控区和染色体的关键部位,有的已经成了抗癌药的靶点。结构多样,功能才会多样。
RNA 这边更热闹。因为通常是单链,RNA 会自己回折,配对出茎环、发夹、假结这些二级结构,再进一步折叠出复杂的三维形状。最典型的例子是核糖体 RNA:催化肽键形成的活性中心,居然几乎全由 RNA 构成,蛋白质只是在旁边帮忙稳定。这个发现直接推翻了"酶一定是蛋白质"的旧观念,也给了"RNA 世界"假说一块实验基石——在生命早期,可能是一群 RNA 既当信息载体又当催化剂,撑起了最初的生命。
图 DNA 双螺旋结构
五、结构之外:把核酸读成信息
把上面这些结构串起来,会得出一个很实用的结论:核酸的价值,不在它本身是什么材料,而在它"能同时做到"两件看似矛盾的事——稳定到能跨代保存,又可变到能承载近乎无限的组合。
稳定靠骨架,可变靠碱基。四种碱基在一条链上的排列顺序,理论上可以写出天文数字的序列;而糖-磷酸骨架无论内容怎么变,长度和化学性质都差不多。这个设计让细胞不必为每一种新信息重新发明一种分子,只要换一换碱基顺序就行。实验室也吃到了这套设计的红利:我们读序列、扩增序列、编辑序列,全都建立在一个统一的可操作框架上。
也正因为看清了结构,人们才敢动手改它。CRISPR-Cas9 里的向导 RNA,靠的就是一段与目标 DNA 互补的序列来指路,再用它自身折叠出的茎环去和 Cas9 蛋白握手——如果没有对碱基配对和 RNA 二级结构的理解,这套基因编辑系统根本搭不起来。同样的道理,DNA 折纸用几百条短链把一条长链折叠成预设的形状,靠的也是精确控制配对的热力学。结构之学,说到底是一门"拿来用"的学问。
把视野再放大一点,核酸这套"稳定骨架加可变字母"的设计,还催生了一个新方向——DNA 数据存储。既然四种碱基就能编码信息,为什么不把数字文件写进 DNA?理论上极少量的 DNA 就能存下惊人的数据,常温干燥就能保存上千年。眼下成本还高、读写也慢,但方向已经打开。这是结构研究反哺工程的又一个例子:先把分子读懂,才能把它当成可以编程的材料。
⚠️ 一个常见的误读:以为碱基配对只发生在复制和转录里。其实 DNA 修复、RNA 干扰、杂交检测、引物设计,几乎处处都在用这条规则,它是一张贯穿全书的地图。
要点速记
- 核苷酸三件套:含氮碱基、五碳糖、磷酸基团;碱基管信息,糖和磷酸管骨架。
- 一个氧原子的分野:脱氧核糖少了 2 号位羟基,DNA 因此稳定、适合存储;RNA 因此灵活、适合执行。
- 互补配对是纠错复印机:A 配 T 或 U 两个氢键,G 配 C 三个氢键,复制与转录都靠它保真。
- 碱基堆叠也出力:双螺旋的稳定性来自氢键与疏水堆叠的共同作用,后者贡献常常更大。
- 反向平行与方向性:两条链一条 5 到 3、一条 3 到 5,方向决定了聚合酶只能单向合成。
- 大沟是读取窗口:调控蛋白伸进大沟识别序列,实现精准定位。
- RNA 是功能分子:单链折叠出茎环、假结,rRNA 的催化中心说明 RNA 可以既存信息又干活。
下一节我们要把镜头从"字母"拉远一点,看这些字母在长链上怎样排成有意义的"句子"——也就是基因的结构与组织,看看编码区和调控区各自的分工。