1.3 基因表达的中心法则
1.3 基因表达的中心法则
本节摘要:中心法则描述遗传信息在分子层面的流动方向:DNA 通过复制保证信息延续,通过转录把信息抄成 RNA,再通过翻译把 RNA 读成蛋白质,主干是 DNA 到 RNA 到蛋白质。这条由克里克 1958 年提出的法则,后来被逆转录(RNA 到 DNA)、RNA 干扰、非编码 RNA 等现象不断修正——信息可以有支流,但源头始终在基因组,且不能从蛋白质反向生成新的核酸序列。它是复制、转录、翻译三道工序的总纲,也是 PCR、基因编辑、mRNA 疫苗等技术的共同理论底座。
你能学到什么
阅读完本节,你应当能够:
- 完整复述中心法则的主干信息流,并说明"信息不能从蛋白质反向流向核酸"这条底线。
- 解释 DNA 复制为何能同时做到高速与高保真,前导链与滞后链的合成有何不同。
- 描述真核生物转录起始的核心步骤,以及可变剪接怎样扩大蛋白质组。
- 说出翻译延伸循环的三个动作(进位、成肽、移位),并定位核糖体的作用。
- 用逆转录、RNA 干扰等例子说明中心法则如何被修正而非推翻。
一、一条法则的诞生与几次修补
1958 年,克里克提出"中心法则"时,用的是一种相当谨慎的口吻。他想表达的核心其实只有一条:遗传信息一旦进入蛋白质,就不能再反向流回核酸。至于 DNA、RNA、蛋白质之间其他方向的箭头,他一开始就没把话说死。
后来的发现不断给这条法则打补丁。逆转录酶的发现证明信息可以从 RNA 回到 DNA;RNA 干扰和非编码 RNA 的兴起说明 RNA 不只是个跑腿的信使,本身就能干活;朊病毒则展示蛋白质构象可以在不改动核酸序列的情况下"传播"。每一次修补,都没有推翻那句底线——信息不会从蛋白质的氨基酸序列,反向改写核酸的碱基序列。
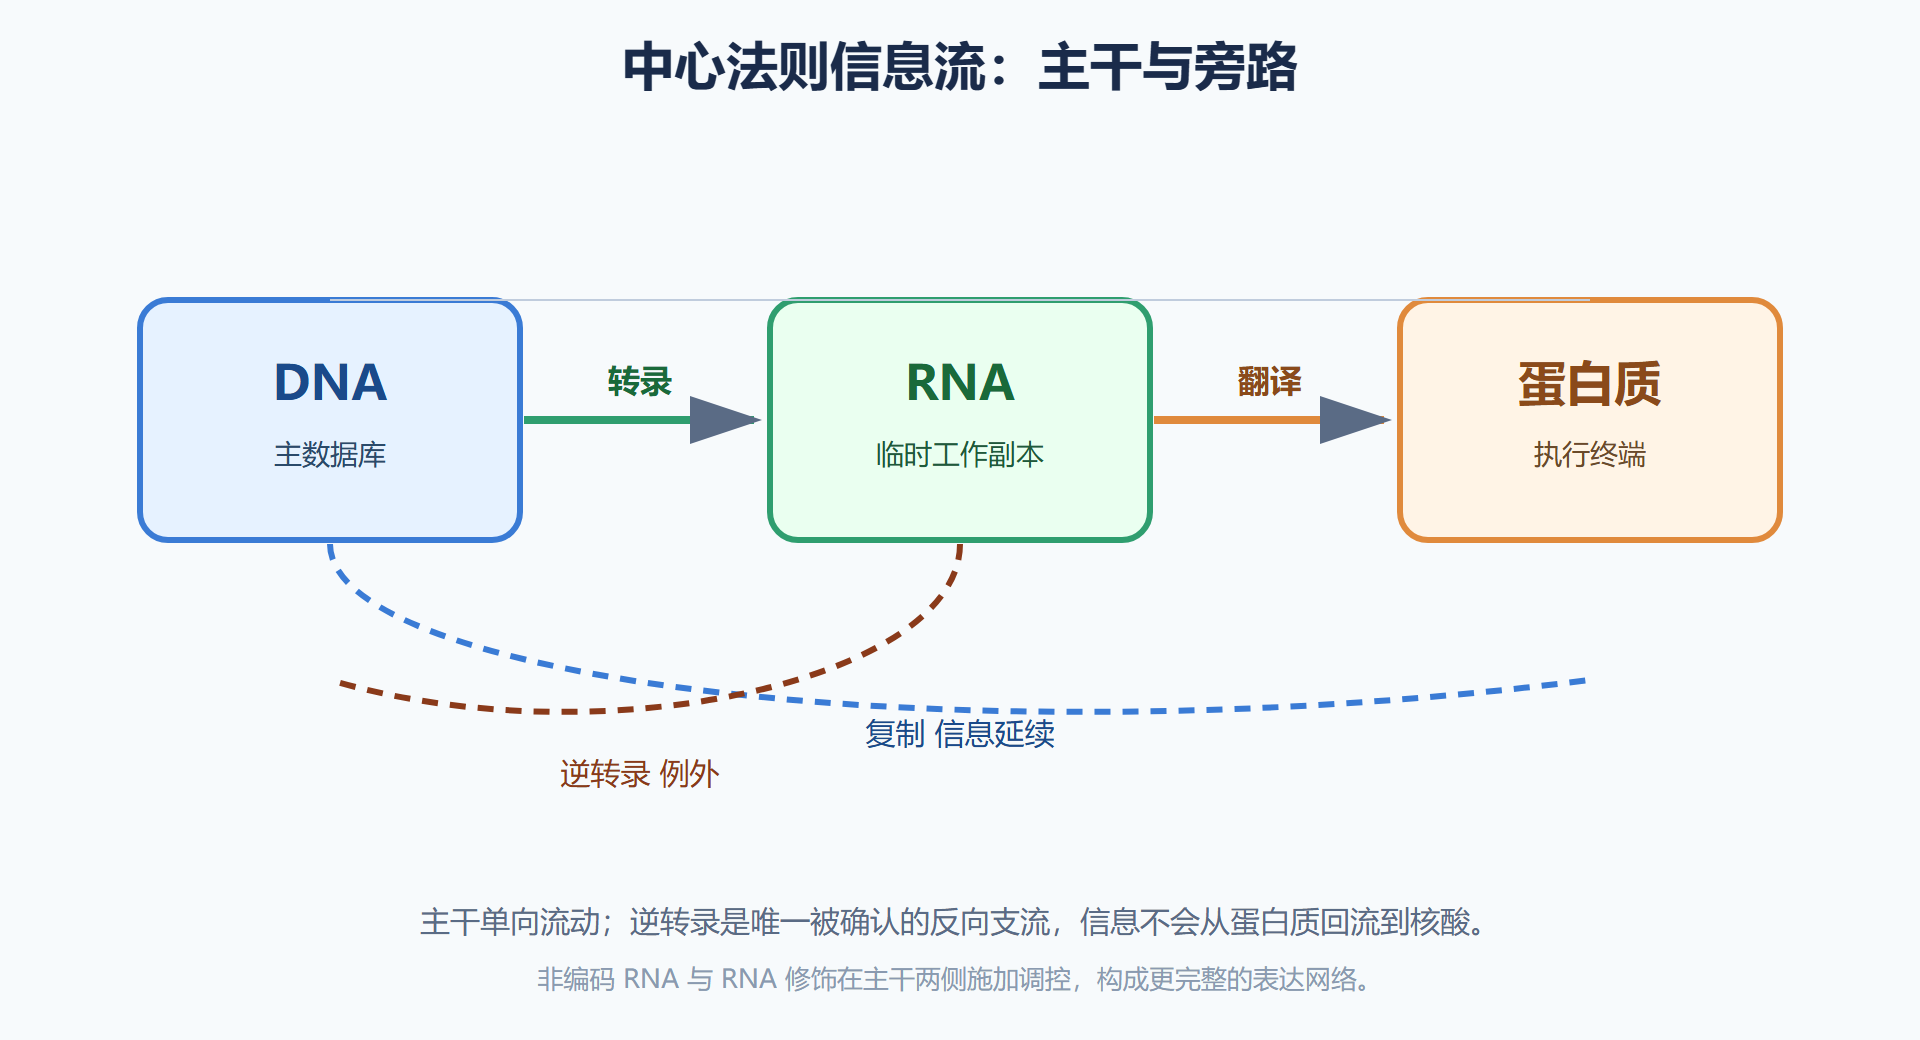
于是现代版中心法则更像一张网,而不是一根线。DNA 是主数据库,RNA 是临时工作副本,蛋白质是执行终端。主干单向,支流丰富,反馈众多,但源头始终在基因组。这个视角,比"一条直线"更接近细胞里真实发生的事。
二、复制:先把信息一个字母不差地抄一遍
中心法则的第一道工序,其实不是表达,而是延续。细胞分裂前,必须先复制整套基因组,把信息原样传下去。
复制从特定的复制起点开始。起始蛋白识别起点、解开双链,形成复制叉;解旋酶持续拆开双链,单链结合蛋白护住裸露的模板。真正合成新链的是 DNA 聚合酶。这里有个绕不开的规矩:聚合酶只能沿 5 端到 3 端方向加核苷酸。于是两条模板链的命运不同——一条被连续合成,叫前导链;另一条只能倒退着、一小段一小段地合成,这些片段叫冈崎片段,最后再由连接酶缝起来,这条叫滞后链。
高保真来自三层把关。第一层是聚合酶的 3 端到 5 端校对活性:一旦掺错碱基,它就会停下来、把错的切掉再重试,把错误率从约万分之一压到百万分之一。第二层是错配修复系统,复制完再扫描一遍,挑出漏网的错误。两层叠加,最终错误率能压到十亿分之一量级——相当于抄一部百万字的书只错一个字符。
三、转录:有选择地读出来
复制是整本照抄,转录则是挑章节读。细胞不会在所有时间、所有地方表达所有基因——哪些基因此刻被唤醒,正是转录调控说了算。这也是多细胞生物能分化出神经、肌肉、肝脏不同细胞类型的根本原因。
转录由 RNA 聚合酶催化,以 DNA 一条链为模板,按互补原则(A 对 U、T 对 A、G 对 C)合成 RNA。原核只用一种聚合酶包办全部 RNA;真核分了三种——聚合酶一合成核糖体 RNA,聚合酶二合成信使 RNA 和部分小 RNA,聚合酶三合成转运 RNA 等。其中聚合酶二主导的信使 RNA 转录,是调控的主战场。
真核的转录起始格外讲究。聚合酶二自己找不到启动子,必须有一群通用转录因子在启动子区组装出前起始复合物,它才能开工。更上游,增强子、沉默子这些远端元件通过中介体或染色质折叠远程施加影响;再往上一层,DNA 甲基化、组蛋白修饰这些表观标记,又决定染色质是敞开还是锁死。启动之后还有一道检查点:聚合酶二常在启动子附近"暂停",等磷酸化信号一到才进入高速延伸——这让细胞能在收到信号后快速启动基因,不必每次从头组装。
转录之后还有可变剪接这道精修工序。人类约九成五的多外显子基因存在可变剪接,于是两万个基因能造出数十万种蛋白质。转录,从来不是"照抄一遍"那么简单,而是信息在流动中被层层选择和加工。
四、翻译:把核苷酸语言译成氨基酸语言
信使 RNA 出了细胞核(真核如此),就到了核糖体——翻译发生的地方。翻译是中心法则里信息形态发生质变的一步:从核苷酸的"四字母语言",换成蛋白质的"二十字母语言"。
翻译的密码本叫三联体密码:每三个核苷酸对应一个氨基酸,一共 64 个密码子,其中 61 个编码氨基酸,3 个是终止信号。这套密码几乎在所有生物里通用,是生命同源的直接证据。
核糖体由核糖体 RNA 和蛋白质拼成,分大小两个亚基。起始时,小亚基结合信使 RNA 和起始转运 RNA(带着甲硫氨酸),原核靠一段 Shine-Dalgarno 序列定位起始密码子 AUG,真核则靠 5 端帽子从前往后扫描。起始完成,大亚基合上,延伸循环开始,三步一轮:
- 进位:带着对应氨基酸的氨酰转运 RNA,凭反密码子与密码子配对,进入 A 位。
- 成肽:大亚基的肽基转移酶中心催化肽键形成,把 P 位的肽链挂到 A 位氨基酸上。
- 移位:核糖体沿信使 RNA 前进一个密码子,空出 A 位迎接下一个。
这个循环不是单打独斗的。多个核糖体可以同时爬在同一条信使 RNA 上,前后接力,像一列火车的车厢,这叫多核糖体。一条信使 RNA 上同时挂着多个核糖体,翻译的效率就成倍提高。细胞还会根据信使 RNA 的稳定性和核糖体的装载效率,动态调节一种蛋白质最终产出多少——翻译不是匀速跑完的,它本身就是调控的一环。
循环每秒钟走几个氨基酸,直到撞见终止密码子,释放因子结合、水解肽链、释放新生多肽。翻译不只是合成,还是质检:无义介导的降解会清掉过早出现终止密码子的坏 RNA,分子伴侣协助新生肽折叠,信号识别颗粒则把分泌蛋白的半成品引导到内质网去共翻译转运。
这套密码还有两个特点值得记。第一是简并性:64 个密码子编码 20 种氨基酸,好几种氨基酸有好几个密码子,第三位常常"同义",这让许多点突变不改变蛋白质——是生命给自己上的保险。第二是近乎通用性:从细菌到人,密码表几乎一致,说明所有生命共享同一套古老的手册。一个解释了遗传的稳健,一个证明了生命的同源。
| 工序 | 模板 | 产物 | 关键酶或机器 | 信息流向 |
|---|---|---|---|---|
| 复制 | DNA 双链各作模板 | 两条子代 DNA | DNA 聚合酶、连接酶 | DNA 到 DNA |
| 转录 | DNA 模板链 | RNA | RNA 聚合酶 | DNA 到 RNA |
| 翻译 | 信使 RNA | 多肽链 | 核糖体、转运 RNA | RNA 到蛋白质 |
| 逆转录 | RNA | 互补 DNA | 逆转录酶 | RNA 到 DNA |
💡 想快速判断一门技术属于哪道工序,就对照上面这张表:凡是要扩增 DNA 的,本质是复制;要读 RNA 表达量的,本质是转录;要生产蛋白质的,本质是翻译。把新技术挂到这张表上,比单独记一堆缩写要省力得多。
五、例外与旁路:中心法则的现代版
主干之外,旁路同样精彩。最著名的例外是逆转录:HIV 这类病毒带着逆转录酶,能把自己的 RNA 模板反写成 DNA,再插进宿主基因组。这一发现逼着克里克本人修正了最初的模型,也催生了互补 DNA 文库和 RT-PCR 这些关键技术。
更微妙的挑战来自非编码 RNA。人类基因组只有约 1.5% 编码蛋白,却有八成以上区域能被转录成各种 RNA,其中大量并不翻译,而是在剪接、稳定、翻译抑制等环节发挥调控作用。microRNA 通过与靶信使 RNA 的部分互补,引导其降解或抑制翻译,织成一张庞大的转录后调控网。这提醒我们,RNA 不只是信息流动的中间商,它本身就是功能分子。
还有表观转录组,RNA 的碱基上也能加化学修饰(如 m6A 甲基化),这些标记影响剪接、出核、稳定性和翻译效率,等于在中心法则之上又叠了一层可调的"批注"。朊病毒则展示蛋白质构象信息能在不改核酸序列的情况下传播——它不违反底线,却提示信息存储的形式比想象中更多样。
把主干、旁路、修饰拼在一起,中心法则其实给出了一张"谁的信息、流向哪里、还能不能再改"的全景图。做研究时,我们常常先问一个问题:这个现象改的是复制、转录、翻译,还是它们之外的新层次?先定位到这张图上的哪一段,再往下挖机制,往往会少走很多弯路。
图 中心法则信息流
六、从法则到技术:一条主线串起的工具箱
中心法则不只是理论,它更像一张技术路线图,很多改变医学的工具都能在上面找到自己的位置。
PCR 模拟的是复制——在试管里把一段 DNA 指数级放大,成了分子诊断和法医学的基石。CRISPR-Cas9 借的是细菌的 RNA 引导切割机制,在转录或复制之外另开一条精准编辑的路。RNA 测序把转录这一步读成数据,单细胞 RNA 测序更是把组织的细胞异质性摊开来。翻译机制的解析,则让人能大规模生产重组蛋白药物(胰岛素、单克隆抗体都靠这套机器)。
最直观的例子是 mRNA 疫苗。它不引入病原体,而是把编码抗原的信使 RNA 送进人体细胞,借我们自己的核糖体翻译出抗原,激发免疫。这条路线跳过了传统的病原体培养,研发速度因此快得惊人。当然,挑战也不小:CRISPR 有脱靶,mRNA 有稳定性和递送难题,非编码 RNA 的成药之路才刚刚起步。但方向已经清楚——谁吃透了信息流动的每一步,谁就能在这一步上做文章。
⚠️ 一个需要澄清的表述:中心法则从来不等于"基因表达的固定流程",它只划定信息能否在分子间反向流动的底线。把"有例外"当成"法则错了",是常见的误读。
核心回顾
- 底线清晰:信息不能从蛋白质反向生成新的核酸序列,这是中心法则不可动摇的部分。
- 复制是照抄:前导链连续、滞后链靠冈崎片段,校对加修复把错误率压到十亿分之一量级。
- 转录是选择性读取:启动子、转录因子、增强子、表观标记层层把关,决定基因何时被唤醒。
- 剪接扩大产出:可变剪接让两万个基因能造出数十万种蛋白质。
- 翻译是换语言:核糖体按三联体密码,把核苷酸语言译成氨基酸语言,进位、成肽、移位三步循环。
- 逆转录是反向支流:它修正而非推翻法则,也催生了互补 DNA 文库与 RT-PCR。
- 技术都长在法则上:PCR 对应复制,RNA 测序对应转录,mRNA 疫苗对应翻译。
至此,第 1 章的三块地基已经铺完:信息用什么存、怎样排、如何流。下一章我们会把镜头对准"变异"——当这套信息在代际之间复制与传递时,那些出错、重排与重组的瞬间,正是遗传与进化的原料。