3.1 基因组结构与测序技术
3.1 基因组结构与测序技术
本节摘要:测序是基因组学的第一道工序,任务是把 DNA 分子里的 A、T、C、G 顺序翻译成电脑能读的文本。这一节先交代基因组的"地形"——染色体、基因、重复序列与非编码区是怎么组织的;再沿着历史主线讲三代测序——Sanger 的链终止、二代的大规模并行、三代的长读长——各自读多长、错多少、贵不贵;最后讲组装和注释如何把碎片还原成蓝图。读完你能判断一个测序项目该选哪代技术,也能看懂"覆盖度、N50、读长"这些报告里的常见指标。
本节导读
阅读完本节,你应当能够:
- 描述基因组从染色体到重复序列、非编码区的分层结构。
- 说清 Sanger 链终止法的原理,以及它为什么至今仍是"金标准"。
- 解释二代测序"边合成边测序"与大规模并行如何把成本打下来。
- 对比三代测序的长读长优势与高原始错误率带来的代价。
- 理解组装与注释在"从读段到蓝图"中的角色,会看 N50、覆盖度等指标。
- 能根据研究目标在短读长与长读长之间做出取舍。
一、先看基因组的"地形图"
在谈测序之前,先得回答一个问题:我们要读的对象长什么样?很多人对基因组的想象是一根均匀的长绳,上面每隔一段挂一个基因。这个想象是错的,而且错得挺厉害。
真核生物的 DNA 并不是光秃秃的一条线。它先绕着组蛋白盘成核小体,再一级一级折叠、压缩,最终装进染色体。人的 23 对染色体加起来约有三十亿个碱基对,此外线粒体还揣着一套自己的小基因组,只走母系这条路。把"基因组"三个字落到物理层面,就是这套分了层、打了包的染色体结构。
真正让人意外的是序列的内容。基因并不是均匀撒在染色体上的,有的区域基因挤成一团,有的区域则绵延几十万碱基几乎一个基因都没有,是名副其实的"基因沙漠"。更反直觉的是,编码蛋白质的外显子只占人类基因组的百分之一到百分之二,剩下的绝大部分是内含子、调控元件、非编码 RNA 基因,以及铺天盖地的重复序列。光是转座子这类"会跳跃的序列"及其残骸,就占了基因组差不多一半。
这些数字背后是一段认知的转折。在只有单个基因可研究的年代,我们天然以为基因组就是"基因的集合";等真的把全基因组序列摆到桌面上,才发现基因只是这座城里零星亮着的几盏灯,大片区域是当时读不懂的"暗物质"。后来才慢慢明白,那些不编码蛋白质的区域里,藏着开关、脚手架和历史的残迹——它们不造零件,却决定零件什么时候用、用多少。所以测序要解决的,从来不只是一个"读字母"的问题,而是怎么把这张既稀疏又拥挤、既保守又多变的地图完整拓下来。
二、测序的三次浪潮:读长、通量与成本的三角
测序的本质,是把分子的化学顺序变成数字文本。这个目标看着简单,历史上却走过了三条完全不同的路。
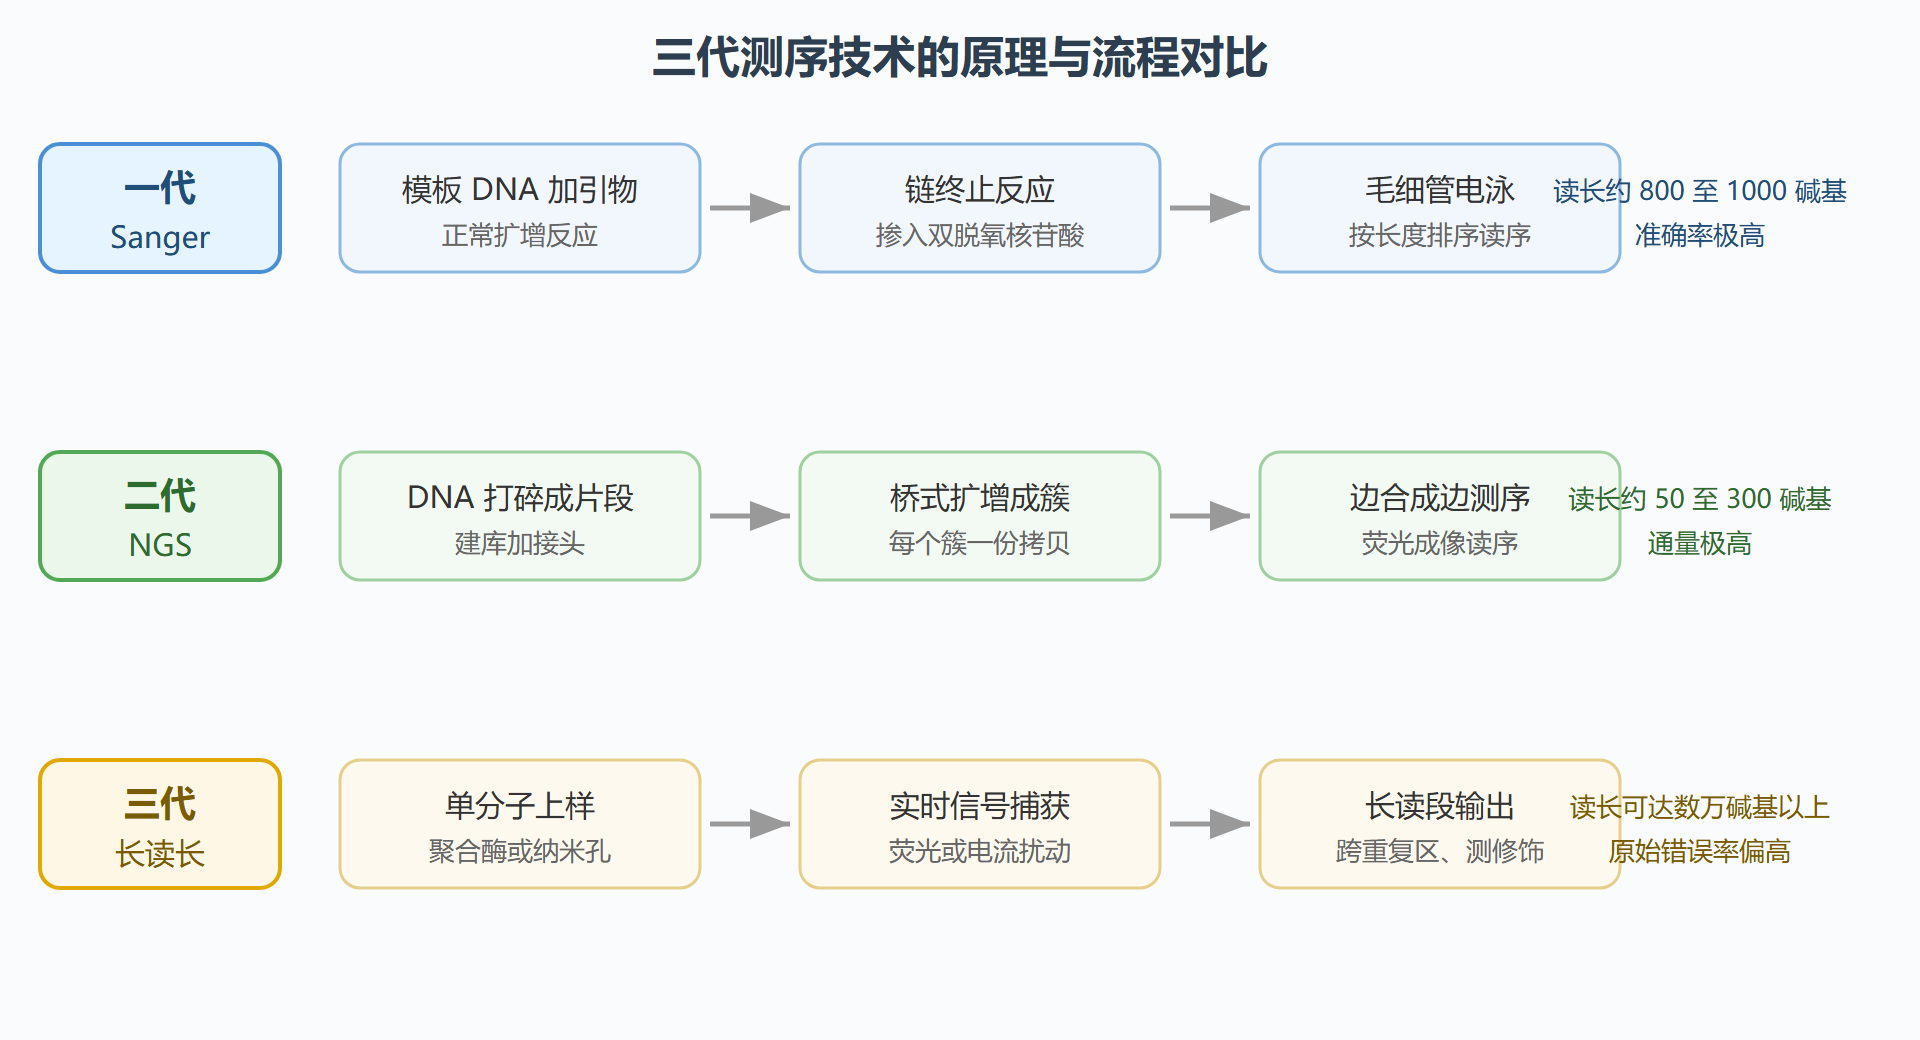
第一代是 Sanger 的链终止法,1977 年问世。它的巧思在于双脱氧核苷酸——这种核苷酸少了三号碳上的羟基,一旦掺进正在延伸的 DNA 链,后面就没法再接了。于是,在一锅正常的合成反应里混入少量带标记的双脱氧核苷酸,就会在每个可能的位置随机截断,得到一组长短正好相差一个碱基的片段。把这些片段按长度排开,末端的标记就一个接一个把序列念了出来。后来毛细管电泳加荧光标记让它实现自动化,读长做到八百到一千碱基,准确率超过百分之九十九点九九。这套方法至今是验证突变、补测小片段的"金标准",缺点是通量太低、成本太高,撑不起全基因组的活。
第二代测序是 21 世纪初的那场"民主化革命"。以边合成边测序加大规模并行为核心,DNA 先被打碎,再在流动槽表面桥式扩增成一个个"簇",每个簇里都是同一条片段的几千个拷贝。接着一轮只掺一个带荧光的碱基,用相机拍下每个簇此刻的荧光,就知道它这个位置是什么碱基,洗掉荧光再来下一轮。这样几亿个簇同时读、同时拍,单次运行的产出一下冲到几百 Gb,单位碱基成本暴跌了上百万倍。代价是读长变短了,通常五十到三百碱基。读长一短,遇到比读长还长的重复区域就没了抓手,结构变异和复杂单倍型也容易读丢。
第三代测序干脆放弃扩增,直接读单个分子,换取超长读长。PacBio 的 SMRT 技术把单个聚合酶固定在一个叫零模波导孔的小坑底部,实时盯着它掺入带荧光标记核苷酸时的那一下闪光;Oxford Nanopore 则让一条 DNA 单链穿过蛋白纳米孔,靠不同碱基通过时引起的离子电流扰动来反推序列。两条路都把读长推到了几万甚至上百万碱基,能一口气跨过整个重复区,还能顺带读出甲基化这类化学修饰。它们的短板是原始错误率偏高,主要错在插入缺失上,需要靠提高覆盖度或"环形一致性"这类技巧去校正。
要记住的是,这三代不是"一代淘汰一代",而是各守一块阵地。Sanger 守准确率,二代守通量与成本,三代守读长与完整性——它们更像是工具箱里三把不同型号的刀。
图:三代测序技术的原理与流程对比
三、从读段到蓝图:组装与注释
测序仪吐出来的,是一堆比目标短得多的读段,以及每个碱基的质量分数。接下来的难题像拼图:把几亿个碎片拼回一条接近完整的染色体。
短读长数据的组装走的是图论的思路。以 de Bruijn 图为例,先把每条读段切成固定长度的 k-mer,让相邻 k-mer 之间靠重叠关系连成一张图,再在图上找一条遍历所有边的路径来还原序列。这套算法又快又省,可一旦遇到比读长还长的重复序列,图就会在重复处"打结",组装随之断成一截一截的 contig。所以早期短读长组装出来的基因组,往往是几千甚至上万个碎片,连续性用 N50 这个指标来衡量——N50 越大,说明越多的基因组被少数几条长 contig 覆盖。
长读长正好补上这块短板。一条读段能跨过整个重复区,重复就不再是拼图的死结。PacBio 的高准确率 HiFi 模式加上 Oxford Nanopore 的超长读段,已经能拼出"端粒到端粒"级别的完整基因组——2022 年发布的 T2T 人类基因组就靠这套组合,把旧参考里百分之八的空白区域补了回来,其中不少是着丝粒、端粒这些难啃的硬骨头。现在更常见的做法是混合策略:用短读长的高准确率去校正长读长的系统性错误,再用长读长的跨度去定骨架。
拼好之后是注释,也就是在裸序列上标出有意义的东西。基因预测是第一步,传统上靠开放阅读框、剪接位点信号、CpG 岛这些特征,再结合同源比对来猜;现在的流程则把 RNA-seq 转录证据、蛋白同源序列和从头预测结果加权整合,生成置信度更高的基因模型。此外还要标两类容易被忽略的东西:一是重复序列,不把它们先屏蔽掉,基因预测会被假基因带偏;二是非编码的调控元件,比如启动子、增强子,它们不编码蛋白质,却决定基因在何时何处开火。
四、怎么选:一份测序项目的取舍清单
落到实际操作,选技术的第一步不是看谁的参数漂亮,而是回到问题本身。
只做单点突变验证、或给一段已知序列补个缺口,Sanger 就够了,准且便宜。做大规模的人群变异筛查、找单核苷酸多态,短读长的二代测序是主力,通量高、单位成本低,前提是覆盖度要给足——全基因组常用的覆盖度是三十倍,意思是每个碱基平均被读到三十次,这样随机错误才能被多数票压下去。要解析结构变异、复杂重复区、或者给一个没参考的物种做从头组装,就该上长读长,它贵一点,但能给出短读长给不了的连续性。
这里有个容易踩的坑:覆盖度不够时,别急着下结论。一个位置只被读到三五次,看到的"变异"很可能只是测序错误。反过来,覆盖度过高也未必划算,成本上去了,信息增量却递减。读长、准确率、成本这三者之间是互相拉扯的,没有通吃的方案,只有匹配问题的方案。
| 维度 | 一代 Sanger | 二代 NGS | 三代长读长 |
|---|---|---|---|
| 代表平台 | 毛细管测序仪 | Illumina、华大等 | PacBio、Oxford Nanopore |
| 读长 | 约 800 至 1000 碱基 | 约 50 至 300 碱基 | 数千至数百万碱基 |
| 单次数据量 | 低 | 极高 | 中高 |
| 原始准确率 | 高于百分之九十九点九九 | 高于百分之九十九点九 | 约百分之八十五到九十九 |
| 主要错误类型 | 极少 | 碱基替换 | 插入缺失 |
| 适用场景 | 验证、小规模补测 | 变异检测、重测序 | 复杂结构、完整组装 |
⚠️ 常见坑:短读长遇到比读长还长的重复区域会"短路",组装在那里断开;只盯着读长数字,却忽略覆盖度和碱基质量,很容易把测序错误当成真变异。
💡 关键直觉:读长、准确率、成本是一个不可能三角。长读长解决"看得全",短读长解决"看得准",高覆盖解决"看得可靠",三者各管一件事,别指望一个参数通吃。
要点速记
- 基因组是分层组织的:染色体是物理骨架,编码区只占百分之一到二,重复序列和非编码区占了绝大头。
- 测序是把分子顺序翻译成数字文本,三代技术分别靠链终止、边合成边测序、单分子实时读取来实现。
- Sanger 胜在准确,是验证突变的金标准,但通量低、成本高,撑不起全基因组。
- 二代测序胜在通量与成本,把全基因组测序从国家级工程变成常规操作,代价是读长短。
- 三代测序胜在读长,能跨过重复区、直读修饰,但原始错误率高,需要校正。
- 组装靠图论把碎片拼成蓝图,重复序列是最大的拦路虎,长读长和混合策略是对策。
- 注释给裸序列标上意义,基因预测之外,重复序列和非编码调控元件的注释同样不能省。
- 选技术先问问题,读长、准确率、成本三者不可兼得,覆盖度是保障可靠性的底线。
读出了基因组,还只是一份孤本。下一节我们把不同物种的基因组并排放在一起比一比,看看"哪些序列在进化里被死死守住"这件事,怎么反过来帮我们认出一段序列到底重不重要。