3.3 生物信息学基础
3.3 生物信息学基础
本节摘要:生物信息学是基因组学里那套"算"的手艺,它把几十亿个碱基变成能检索、能比对、能推理的知识。这一节从三个关键词切入:序列比对,讲它怎么从纸笔推导的动态规划走到 BLAST 的秒级检索;注释,讲怎么给裸序列标上功能;数据库,讲 GenBank、RefSeq 这些基础设施怎么把离散数据连成网络。最后把整条分析流水线串起来——比对、变异检测、注释、关联分析——并提醒你:算法会算,不代表算出来的一定是真的。读完你能走通一条从原始读段到生物学结论的路。
读前必看
阅读完本节,你应当能够:
- 说清序列比对在"相似性到同源性"推断里的作用。
- 区分全局比对、局部比对与启发式搜索,理解各自为什么被需要。
- 说明注释与数据库如何把裸序列变成可检索、可关联的知识。
- 描述"比对到关联分析"这条流水线每一步在做什么。
- 指出自动注释导致的错误传播与算法偏倚这两类常见问题。
- 用"算出来不等于是真的"的审慎态度看待生物信息学结论。
一、生物信息学解决什么问题:数据洪流里的导航
一份人类全基因组有几十亿个碱基。这个量级意味着,任何靠肉眼、靠手工表格来读序列的念头,都在第一页就破产了。生物信息学干的活,本质上是用计算机、统计学和数学,替人把海量的生物学数据整理成能看、能查、能推理的形式。
我喜欢把它比作给一座巨型图书馆做编目。基因组这座"图书馆"有几十亿个字符,却没有现成的目录、没有页码、没有检索框。生物信息学的任务,就是先发明一种把字符对齐的方法(序列比对),再给每一段标上"这是一本书的哪一章"(注释),最后建一个搜索引擎,让人能从一个词反查到相关的书、作者和借阅记录(数据库)。这套手艺从 1970 年 Needleman 与 Wunsch 在纸上推导出第一个比对算法起,一路走到今天 BLAST 的秒级检索、再到深度学习模型,早已从"辅助工具"长成了整个生命科学的核心引擎。
二、序列比对:从纸笔推导到启发式
序列比对,就是把两段或多段序列并排对齐,在合适的地方插入空位、标出错配,让相似的部分彼此对应起来。这件事看着只是字符游戏,背后却压着一个生物学假设:序列相似,往往意味着同源;而同源,是推断共同功能、共同结构、共同祖先的可靠入口。
最早的算法是全局比对。Needleman 与 Wunsch 在 1970 年提出用动态规划,把一个看似要穷举的问题拆成可递推的得分矩阵,从左上角一路算到右下角,反推出一条最优的对齐路径。后来 Smith 与 Waterman 改出一版局部比对,不再强求两条序列从头到尾对齐,只找最相似的那一小段——这对识别蛋白质里的功能结构域、比对远缘序列更有用。
但动态规划的代价是平方级的。序列一长、数据库一膨胀,精确算法就扛不住了。于是有了 BLAST 这样的启发式工具:它不求全局最优,而是先用"种子-扩展"的策略,在查询序列里挑几个短而高分的片段,快速在数据库里定位,再向两侧扩展、直到得分掉到阈值以下。速度上去了,代价是可能漏掉一些弱同源信号。到了长读长时代,Minimap2 这类工具又用上模糊哈希的思路,在速度和鲁棒性之间再找一次平衡。
三、注释与数据库:给序列安上索引
比对的输出,还只是"这段和那段像"。要让它变成知识,得走两步:注释,和入库。
注释是把裸序列标出意义——这里是一个蛋白质编码基因,那里是一段非编码 RNA,再往上是启动子、增强子,往下是重复序列。早期的注释靠人工一点一点审校,慢但准;现在更多是自动流水线先跑一遍,再由人抽查。这里埋着一个隐患:自动注释会"错误传播",一个初始被标错的基因功能,可能被后面几百个同源序列原样继承,越传越广。
数据库则把注释后的知识组织成能检索、能关联的网络。GenBank 是全球核苷酸序列的原始仓库,与欧洲的 ENA、日本的 DDBJ 实时同步;RefSeq 则在这一堆原始提交之上,提供经过审校、去冗余的参考序列,给人一个统一的坐标系。再往上,UniProt 管蛋白质,dbSNP 管单核苷酸多态这类小变异,ClinVar 管变异与疾病之间的证据。这些库之间互相链接:你从一个未知序列查到它的同源基因,点进去看到功能注释,再顺藤摸到它上面的变异、变异的人群频率、以及这个变异是否与某种疾病相关——几分钟里完成的,是过去要翻几个月文献的活。
| 数据库 | 定位 | 主要内容 | 典型用途 |
|---|---|---|---|
| GenBank | 原始序列仓库 | 全球提交的核苷酸序列 | 存原始数据、做同源检索 |
| RefSeq | 参考序列库 | 审校后的非冗余参考序列 | 提供统一坐标系 |
| UniProt | 蛋白质库 | 蛋白序列与功能注释 | 蛋白功能研究 |
| dbSNP | 变异库 | 单核苷酸多态等小变异 | 查变异的人群频率 |
| ClinVar | 临床变异库 | 变异与疾病的关联证据 | 遗传病解读 |
比单个数据库更进一步的,是把离散注释组织成有结构的知识网络。基因本体论给每个基因挂上一套标准化的功能标签,从分子功能、生物学过程到细胞定位三个维度描述它;KEGG 这类通路数据库则把基因串进代谢和信号通路的图里,让人能问"这个基因在一整条通路的哪个环节"。有了这种结构化注释,才能做功能富集分析——把一组差异表达的基因扔进去,看它们是不是不成比例地集中在某条通路,从而从"一堆基因"里拎出"一个故事"。
四、从数据到结论:比对、变异检测、注释、关联分析
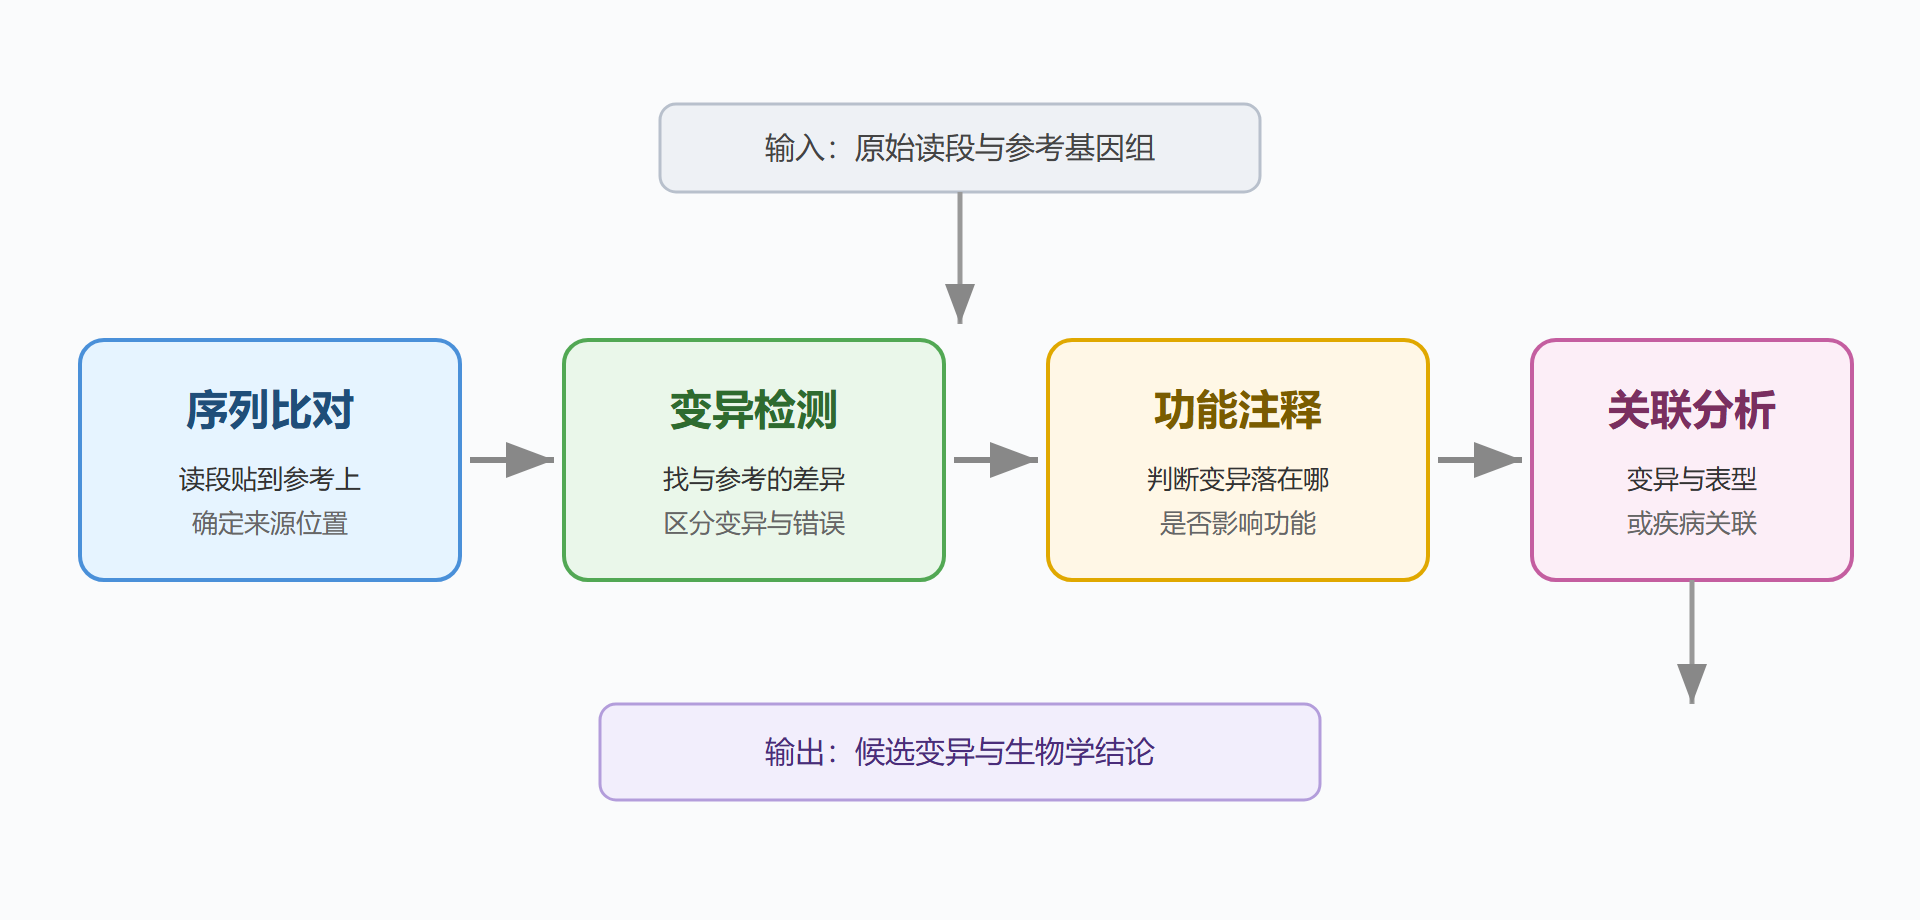
把前面几样东西串起来,就是一条标准的分析流水线。第一步比对,把原始读段贴到参考基因组上,确定每个读段来自哪里。第二步变异检测,在比对结果里找读段与参考之间的差异,再用统计学方法把真正的变异和测序错误分开。第三步注释,判断找到的变异落在哪里、有没有改变氨基酸、落在调控区还是编码区、是不是已知的致病位点。第四步关联分析,把变异与表型或疾病关联起来,比如在全基因组关联分析里,看某个位点在病例组和对照组之间是否出现显著的频率差异。
这四步环环相扣:比对错了,变异就找错;注释缺了,找到的变异也只是个无意义的坐标;关联分析没做好,再漂亮的统计数字也说明不了任何生物学问题。
值得多说一句的是变异检测这一步。读段和参考之间的差异,并不都是真变异——测序错误、比对到重复区的错位,都会制造假信号。所以成熟的流程会把"这个位置有差异"和"这个差异可信"分开处理,用碱基质量、覆盖度、正负链是否一致这些证据综合打分,输出一个带置信度的变异集合。关联分析再往前走一步:全基因组关联分析在成千上万人里,逐个位点检验它在病例组和对照组之间的频率差异,找出与疾病挂钩的候选位点。它找到的是相关性,离因果还有一段距离。下面这张图就是这条流水线的骨架。
图:生物信息学分析流程
五、别把"算出来"当"是真的"
流水线跑通不等于结论可信。生物信息学里,真正的功夫往往不在点"运行"那一下,而在问"这个结果能不能信"。
第一个问题是批次效应。不同平台、不同实验室、不同时间产生的数据,带着各自的系统性偏差,混在一起分析时,这些偏差可能被误读成真实的生物学信号。第二个问题是算法偏倚。很多预测模型的训练数据以欧洲人群为主,换到别的群体上表现就掉一截;训练数据缺多样性,结论自然就带着偏见。第三个问题是黑箱。深度学习模型能给出很准的预测,却常常说不清为什么,这在临床场景里尤其让人不放心——医生需要的不是"大概率致病",而是"为什么致病"。
正因如此,开放科学才不是一句口号。共享代码、共享数据、用可复现的工作流把每一步固定下来,是让"算出来的结论"经得起别人重算的前提。落到操作层面,容器化技术把软件连同它依赖的运行环境一起打包,让同一套流程在不同机器上跑出一致的结果;工作流管理系统则把几十个步骤串成可重跑、可追踪的管线,每一步的参数和输入都留痕。这些工程手段看起来和"科学"无关,却恰恰是结论可信度的地基。
⚠️ 常见坑:把自动注释的标签当成铁律。错误会在数据库里层层传播,一个误注的功能可能被几百个同源序列继承,越查越"对"、其实越错。
💡 关键直觉:算法负责"算得出来",人负责"算得对吗"。生物信息学的核心能力,是分清信号与噪声,而不是会敲命令。
核心回顾
- 生物信息学是给基因组这座图书馆做编目、建搜索引擎的手艺,解决的是数据洪流里的可读性问题。
- 序列比对的根基假设是"相似暗示同源",同源再通向共同功能、结构与祖先。
- 全局比对与局部比对各有用处,动态规划精确但贵,BLAST 用启发式换速度,Minimap2 服务长读长。
- 注释给序列标意义,数据库把意义连成网络,从基因查到变异、再查到疾病,几步就能完成。
- 自动注释会错误传播,一个误注可能被大量同源序列继承,需要审校与纠错。
- 标准流水线是比对、变异检测、注释、关联分析,四步环环相扣,前一步错后一步跟着错。
- 批次效应、算法偏倚、黑箱不可解释,是生物信息学结论可信度上的三大隐患。
- 开放科学与可重复性,是让"算出来的结论"经得起重算的底线。
到这里,本章"读、比、算"三个动作已经全部落地。下一章我们把镜头从全基因组拉回到细胞内部,去看基因调控与表观遗传——同样一份序列,为什么能在不同细胞里读出不同的意思。