4.4 立体声、环绕声与空间音频
4.4 立体声、环绕声与空间音频编码
空间听觉的两大线索是双耳时间差(ITD)与强度差(ILD),辅以耳廓与躯干滤波(头部传递函数 HRTF);立体声用两声道制造幻象声像;对象音频把"声音在哪"从混音端搬到还音端,是空间音频的现代形态。
旅程的最后一站:数字处理后的信号如何让听者"看见"声音的位置。人只有两只耳朵却能定位三维声场,靠的是一套精巧的双耳线索——所有空间音频技术,本质上都是在伪造这套线索。
双耳线索:ITD、ILD 与 HRTF
声源偏右,右耳先听到(时间差)、也更响(强度差)。低频段波长长于头径,绕射使两耳强度差微弱,定位靠时间差;高频被头颅遮挡,强度差成为主力——双工理论:低频 ITD、高频 ILD 分工。耳廓的褶皱对高频形成方向相关的滤波(谱形线索),垂直定位几乎全靠它;头部转动改变 ITD/ILD 图样,是消解"前后混淆"的动态线索。把这些线性滤波完整记录下来,就是头部传递函数——每个人的 HRTF 都像指纹一样个性化,用他人 HRTF 做耳机渲染,声像常会"缩进头里"或前后翻转。
import numpy as np def itd_ild(theta_deg, r_head=0.0875, f=None, c=343.0): """球头近似:theta 为相对正前方的方位角 返回 ITD(ms);f 给定时同时返回 ILD(dB)(简化遮蔽模型)""" th = np.radians(theta_deg) d = r_head*(np.sin(abs(th)) + abs(th)) # Woodworth 球头近似路径差 itd = d/c*1000 if f is None: return itd ild = min(20*np.log10(1 + 0.5*abs(np.sin(th))*(f/700)), 15) # 粗量级 return itd, ild for a in (0, 30, 60, 90): itd = itd_ild(a) _, ild_low = itd_ild(a, f=200) _, ild_high = itd_ild(a, f=4000) print(f"方位 {a:2d}°: ITD={itd:5.2f} ms | ILD: 200Hz≈{ild_low:4.1f} dB, 4kHz≈{ild_high:4.1f} dB") # 方位 0°: ITD= 0.00 ms | ILD: 200Hz≈ 0.0 dB, 4kHz≈ 0.0 dB # 方位 30°: ITD=0.20 ms | ILD: 200Hz≈ 0.7 dB, 4kHz≈ 4.9 dB # 方位 60°: ITD=0.38 ms | ILD: 200Hz≈ 1.4 dB, 4kHz≈ 8.6 dB # 方位 90°: ITD=0.52 ms | ILD: 200Hz≈ 1.9 dB, 4kHz≈11.5 dB # 低频靠时间差(人耳对 ~10 μs 级差敏感),高频靠强度差 —— 双工理论的数值肖像。
从声像到对象:空间编码三代目
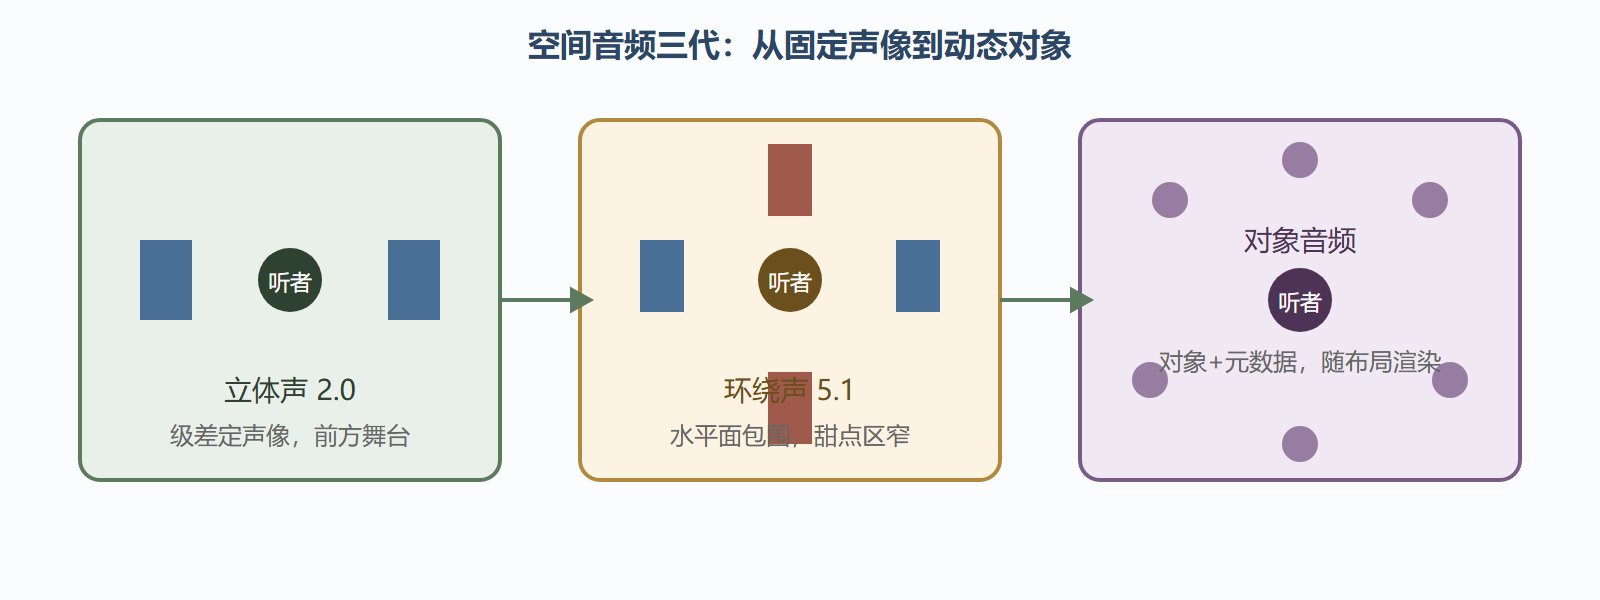
立体声(1930 年代起):两音箱等强时,听者正前方产生幻象声像;左右声级差调 azimuth,正弦定律给出近似映射。便宜、稳健、至今统治音乐分发。环绕声(5.1/7.1):加后方与低频效应声道,把水平面围起来;代价是"甜点区"狭窄,离轴即糊。对象音频(如影院全景声、双耳渲染标准):混音不再烙死声道,而是把对白、飞机、雨声存为带位置元数据的对象,还音端按实际扬声器布局或耳机 HRTF 实时渲染——一次制作,处处适配。虚拟现实进一步要求六自由度:听者一转头,声场必须反向补偿,HRTF 个性化与低延迟成为主战场。
图:空间音频三代技术演进
⚠️ 常见坑:耳机双耳渲染沿用通用 HRTF,前后混淆与"头中效应"是常态而非缺陷;个人化 HRTF 测量与适配是目前空间音频最活跃的工程方向,别指望一版参数通吃所有耳朵。
本节要点回顾
- 双工理论:低频靠 ITD(微秒级敏感)、高频靠 ILD,垂直定位靠耳廓谱线索
- HRTF 个性化如指纹,通用 HRTF 的头中效应是原理性问题不是调试问题
- 立体声用级差造幻象声像;环绕声围起水平面但甜点区窄
- 对象音频把空间信息做成元数据,还音端适配布局渲染——一次制作处处还音
- 六自由度 VR 要求头部转动实时补偿,低延迟与个性化是主战场
第4章走完信号全程。第5章换介质:水与钢里的声学。
常见问题
两个音箱的"甜点"多窄? 与两只音箱构成等边三角形的位置附近,偏离半米声像即开始漂移。这就是"皇帝位"的物理来源,也是对象音频与头部追踪想解决的问题。
耳机听立体声为什么"在头里"? 标准立体声混音假设扬声器交叉馈入双耳;耳机直连单耳,交叉通路(含 ITD/ILD 的自然混合)消失,声像坍缩进头内。交叉馈电(crossfeed)电路用滤波重建部分交叉通路,是老烧友的模拟解法。
import numpy as np fs = 48000 f = np.geomspace(20, 20000, 400) def crossfeed(depth_db=-4, shelf_hz=700): # 简化交叉馈电:对侧声道注入低通后的小量信号 g_low = 10**(depth_db/20) g = g_low + (1-g_low)/(1 + (shelf_hz/f)**2) # 低频多馈、高频少馈 return g print(f"100 Hz 交叉馈电量:{20*np.log10(crossfeed()[np.argmin(abs(f-100))]):+.1f} dB") print(f"8 kHz 交叉馈电量:{20*np.log10(crossfeed()[np.argmin(abs(f-8000))]):+.1f} dB") # -3.5 dB / -0.1 dB 量级:低频被适度"推过头中",高频保持分离 —— # 模拟音箱交叉听音的第一近似。
空间音频的"对象"会不会文件更大? 通常更小。声道制式要为不发声的声道存静默数据,对象制式只存发声对象的音频与元数据,复杂场景反而节省码率——这是广播与流媒体接纳它的商业动因之一。
关于"空间感"与"清晰度"的取舍也值得一提:早期反射声太强会损害语言清晰度(会议扩声大忌),却是音乐厅"包围感"的养料。同一段反射声,在讲台是毒药、在舞台是蜜糖——空间音频设计的核心判断,从来不是"多与少",而是"对谁、在何时"。