4.1 4.1 随机过程与蒙特卡洛:随机数作为计算引擎
4.1 随机过程与蒙特卡洛:随机数作为计算引擎
本节摘要:蒙特卡洛方法用随机样本逼近确定量,是应用数学中"用不确定性计算确定性"的代表技术。本节从圆周率估计讲清收敛机理,用风险价值计算演示工业用法,再介绍重要性抽样如何针对稀有事件提速,最后给出随机过程(马尔可夫链、泊松过程)在模拟中的角色。
能力目标
阅读完本节,你应当能够:
- 实现基础蒙特卡洛估计并量化其误差收敛阶;
- 用模拟方法计算金融工单中的风险价值分位数;
- 解释重要性抽样对稀有事件模拟的加速原理。
扔随机点,算确定数
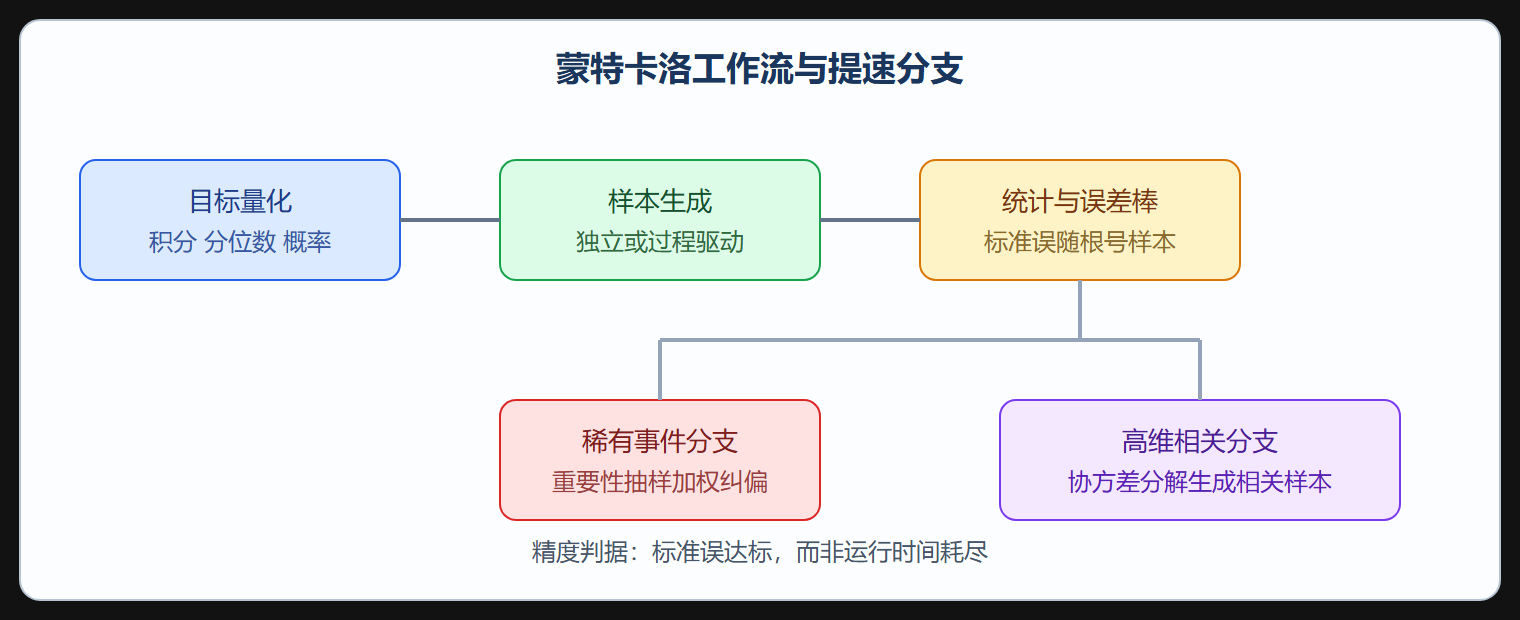
往单位正方形里撒随机点,落在四分之一圆内的比例乘以四就是圆周率的估计。这个小学演示藏着蒙特卡洛的全部机理:用随机样本的频率逼近概率,用概率反推我们想要的量。关键性质是误差与样本数的平方根成反比——样本乘一百,精度只多一位有效数字。这既是它"简单粗暴"的代价,也是它"维度免疫"的底气:不管问题几维,收敛速度都是同一个平方根倒数的阶,而确定性数值积分的代价随维度指数爆炸。高维积分用蒙特卡洛,低维平滑问题用确定性方法,这条分界线要划清。
import numpy as np rng = np.random.default_rng(2024) def mc_pi(n): """撒点估计圆周率,返回估计值与理论误差水平""" pts = rng.random((n, 2)) inside = (pts**2).sum(axis=1) <= 1.0 est = 4 * inside.mean() se = 4 * np.std(inside) / np.sqrt(n) # 标准误 return est, se for n in [1_000, 100_000, 10_000_000]: est, se = mc_pi(n) print(f"n={n:>10}: 估计 {est:.5f} ± {se:.5f}")
输出中估计值随 n 增大逼近 3.14159,标准误按根号倒数缩小——每次交付蒙特卡洛结果都要带这个"±",它是方法自带的诚实声明。
工业用法:风险价值的模拟
风控工单的典型问题:组合明天亏损超过多少的概率是 5%?那个分位数就是 95% 置信下的风险价值。解析法只在组合是线性、分布是正态时可行;真实组合带期权这类非线性工具,模拟是标准做法。用几何布朗运动生成一千条明日价格路径,逐条算组合损益,取经验分位数:
import numpy as np rng = np.random.default_rng(7) def simulate_portfolio(S0=100.0, sigma=0.02, n_paths=200_000, holding=10_000): """持有一万股股票的一天损益分布(对数正态模型)""" z = rng.standard_normal(n_paths) S1 = S0 * np.exp(-0.5*sigma**2 + sigma*z) pnl = (S1 - S0) * holding return pnl pnl = simulate_portfolio() var95 = np.quantile(pnl, 0.05) # 5% 分位数(负数代表亏损) cvar95 = pnl[pnl <= var95].mean() # 超越 VaR 的尾部平均 print(f"95% VaR: 亏损不超过 {-var95:,.0f} 元") print(f"95% CVaR: 尾部平均亏损 {-cvar95:,.0f} 元") print(f"最差 1% 路径平均亏损 {-np.quantile(pnl, 0.01):,.0f} 元")
VaR 回答"亏到哪条线",CVaR 回答"越线之后平均多惨"。风控报告两者都要——只报 VaR 会让人以为那条线就是最坏情形,而尾部均值往往比线深得多。这正是第 7 章金融工单的核心话术,此处先把工具备好。
标准误同样不可省略:二十万路径下分位数估计的标准误可以用自举或解析近似得到,样本再翻十倍精度才多一位。"模拟跑够了"的判据是精度指标达标,不是运行时间到了。
稀有事件与重要性抽样
设备可靠性工单常问"年故障概率百万分之几"这类稀有事件。直接模拟一百万次才见到一次,估计的相对误差大到不可用。重要性抽样的思路是故意让稀有事件多发生,再按概率比把权重纠正回来:把失效阈值附近的样本分布加密,每条样本除以其发生概率的放大倍数,期望值不变、方差骤降。
import numpy as np rng = np.random.default_rng(11) # 工单:载荷服从标准正态,强度 5.0,求失效概率(真值约 2.9e-7) threshold = 5.0 # 直接模拟:两百万样本,命中数为个位数 n = 2_000_000 loads = rng.standard_normal(n) hits_direct = (loads > threshold).sum() # 重要性抽样:样本取自均值平移到阈值处的正态,权重纠偏 n_is = 20_000 mu_shift = threshold z = rng.normal(mu_shift, 1.0, n_is) w = np.exp(-0.5*(z**2 - (z - mu_shift)**2)) # 概率比 p_is = np.mean(w * (z > threshold)) from scipy.stats import norm print(f"直接模拟: {hits_direct}/{n} = {hits_direct/n:.2e}") print(f"重要性抽样: {p_is:.3e}") print(f"解析真值 : {norm.sf(threshold):.3e}")
两万条样本的重要性抽样精度就能匹敌数百万条直接模拟——对年故障率、保险巨灾、通信误码率这类工单,这就是"能算"与"算不动"的区别。代价是偏移分布选得不好反而方差更大(权重两极分化),所以偏移量的选择本身要做小规模试验。
随机过程在此扮演"样本生成器"的角色:独立性场景用独立同分布抽样;有记忆的场景(库存需求、到达流)用马尔可夫链或泊松过程驱动。泊松过程模拟有个优雅技巧——到达间隔是独立指数分布,直接生成间隔序列相加即得全部到达时刻。下一节我们把方向反过来:数据已经在了,要猜的是背后的分布。
一个高频错误是拿同一批随机数反复跑"独立实验"做误差估计。随机种子固定时两次运行结果完全相同,所谓误差为零是假象;误差估计要用不同种子或自举重采样。
💡 关键直觉:蒙特卡洛的误差只跟"被估计量的方差与样本数"有关,跟维度无关。这让它成为高维问题几乎唯一的通用武器,也让它永远快不过利用了平滑性的低维专用方法——选型时先数维度。
蒙特卡洛工作流
本节要点回顾
- 平方根收敛是蒙特卡洛的宿命:精度每加一位有效数字,样本乘百倍;
- 维度免疫是它的护城河,高维积分几乎只有它能打;
- VaR 与 CVaR用经验分位数与尾部均值交付,两者必须成对出现;
- 重要性抽样用偏移分布加概率权重驯服稀有事件,偏移量要试选;
- 误差棒随结果交付,同种子重复运行不构成独立实验。