4.2 4.2 参数估计与假设检验
4.2 参数估计与假设检验
本节摘要:统计推断回答"从样本反推总体"的问题。本节用一条产线质量工单串起两大工具:参数估计(矩估计、极大似然)给出未知参数的点位估计与置信区间;假设检验控制"把合格判成不合格"与"把不合格放走"两类错误。p 值的正确读法与样本量的反推计算是本节的两个落点。
学习目标
阅读完本节,你应当能够:
- 手工实现矩估计与极大似然估计并比较性质;
- 用正态近似构造置信区间并解释其频率学派含义;
- 设计检验并控制两类错误,反推所需样本量。
工单:新产线的关键尺寸合格吗
一条新产线加工轴套,图纸要求内径 25.000 毫米,公差正负 0.015。质检抽了四百件,样本均值 25.003、标准差 0.006。两个问题接踵而来:第一,产线真实均值到底是多少(估计);第二,有没有证据说它偏离了目标值 25.000(检验)。
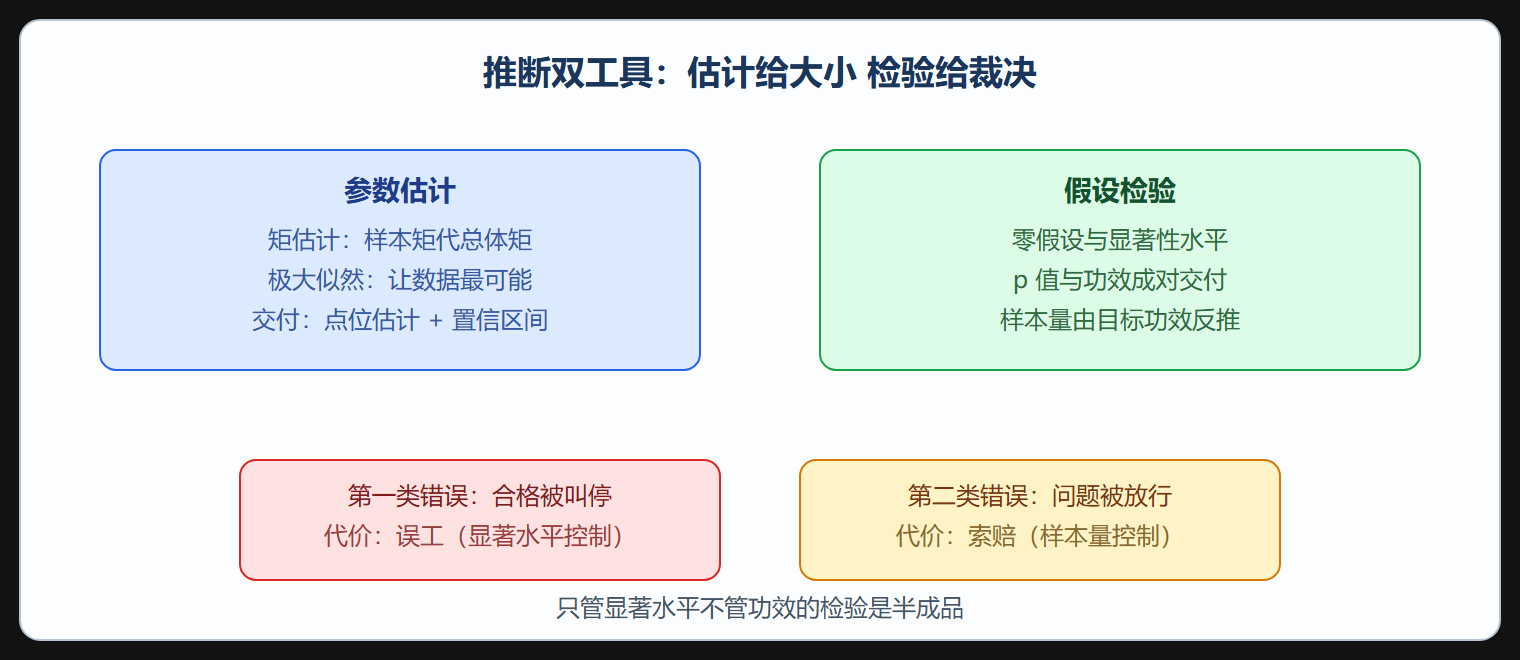
矩估计最直白:用样本矩代替总体矩,正态场合下均值就是样本均值、方差就是样本方差。极大似然换个哲学:问"什么样的参数值让手头这批数据看起来最可能",把似然函数最大化。正态场合两者给出的均值估计相同,方差估计略有出入(除以 n 还是 n 减 1 的区别)。极大似然的普适性更强——分布一换,矩方程可能无解而似然函数照算不误。
import numpy as np from scipy import stats from scipy.optimize import minimize_scalar rng = np.random.default_rng(20) sample = rng.normal(25.003, 0.006, 400) # 矩估计:直接用样本矩 mu_mom, sd_mom = sample.mean(), sample.std(ddof=0) # 极大似然:对数似然最大化(正态有闭式解,此处演示通用数值做法) def neg_log_lik(sigma, data, mu): n = len(data) return n*np.log(sigma) + np.sum((data - mu)**2) / (2*sigma**2) mu_mle = sample.mean() # 均值的 MLE 闭式解 res = minimize_scalar(neg_log_lik, bounds=(1e-4, 1.0), args=(sample, mu_mle), method='bounded') print(f"矩估计: 均值 {mu_mom:.5f}, 标准差 {sd_mom:.5f}") print(f"极大似然: 均值 {mu_mle:.5f}, 标准差 {res.x:.5f}") # 均值的 95% 置信区间(正态近似) se = sample.std(ddof=1) / np.sqrt(len(sample)) ci = stats.norm.interval(0.95, loc=mu_mom, scale=se) print(f"均值 95% 置信区间: [{ci[0]:.5f}, {ci[1]:.5f}]")
置信区间的读法要严谨:不是"真实均值有 95% 的概率落在这个区间",而是"这套构造区间的方法长期来看有 95% 的区间会盖住真值"。频率学派把概率定义在方法上,不是定义在参数上。这个区别在向业务方汇报时不是咬文嚼字——参数在他们的世界观里要么在要么不在,会随抽样变的是区间。
检验:把"感觉有偏"变成可复核的裁决
零假设设为"产线均值等于 25.000"。检验统计量取样本均值标准化后的 z 值,绝对值超过 1.96(5% 显著水平的双临界值)就拒绝零假设。
import numpy as np from scipy import stats n = 400 xbar, s, mu0 = 25.003, 0.006, 25.000 z = (xbar - mu0) / (s / np.sqrt(n)) p_value = 2 * stats.norm.sf(abs(z)) print(f"z 统计量 = {z:.2f}, 双侧 p 值 = {p_value:.4f}") z = abs(z) power_at = lambda delta: stats.norm.cdf(-1.96 - delta*np.sqrt(n)/s) \ + stats.norm.sf(1.96 - delta*np.sqrt(n)/s) print(f"若真实偏移 0.004, 检出功效约 {power_at(0.004):.2f}") print(f"若真实偏移 0.002, 检出功效约 {power_at(0.002):.2f}")
四百件样本、3 西格玛偏移下 p 值远小于千分之一,拒绝是明确的。但注意功效那两行:若真实偏移只有 0.002(工艺上无所谓的那种),检出功效只有约百分之五十——一半的机会宣告"显著"一半的机会宣告"不显著",结论像抛硬币。样本量必须跟要分辨的效应大小挂钩,反推公式是让 1.96 加上功效对应分位点乘以标准误小于目标偏移。上面的代码稍作变形就能解出 n。
两类错误的账本要摆正:第一类错误(合格产线被叫停)的代价是误工;第二类错误(问题产线被放行)的代价是售后索赔。显著水平管前者,样本量与功效管后者。只设显著水平不管功效的检验是半成品。
p 值的三个高频误读必须点破:其一,p 值不是"零假设为真的概率";其二,p 等于 0.03 不代表效应很大,它只说数据与零假设的不合拍程度,效应大小要看估计值与置信区间;其三,跑二十个指标总有一个显著,是抽签抽出来的——多重检验要做校正(比如邦费罗尼法把显著水平除以检验数),这在 A/B 测试平台上是实打实的坑。
⚠️ 常见坑:样本量巨大时一切都"显著"。百万级样本下 0.0001 的偏移也会被检出,业务上却毫无意义。报告显著性时必须同时报告效应大小与置信区间,让读者判断量级。
💡 关键直觉:估计回答"多大",检验回答"可不可信"。工程决策两问都要答——先看置信区间是否窄到业务可容忍,再看 p 值是否过线。顺序反了会被大样本显著性牵着走。
推断流程与错误账本
本节要点回顾
- 极大似然比矩估计普适,分布复杂时是默认选择;
- 置信区间的概率陈述作用在方法上,长期覆盖率才是其含义;
- 检验三件套:显著水平、p 值、功效缺一不可,样本量由功效反推;
- p 值三误读:不是零假设概率、不代表效应大小、多重检验要校正;
- 大样本显著性须配效应大小一起读,先问多大再问可不可信。