4.3 4.3 回归、正则化与模型选择
4.3 回归、正则化与模型选择
本节摘要:回归是统计推断在工业现场使用率最高的形态。本节先复现过拟合的现场——多项式阶数往上怼时训练误差与测试误差分道扬镳;再用偏差-方差分解解释机理;岭回归与套索两种正则化的几何差异、交叉验证的工程细节(时间序列不能随机折)依次落地,最后给出模型选择的完整检查单。
你将获得的能力
阅读完本节,你应当能够:
- 复现并诊断过拟合:训练误差与测试误差的剪刀差;
- 说出岭回归(L2)与套索(L1)在稀疏性上的差异及选型依据;
- 正确实现 K 折与滚动起点的交叉验证,避免时间序列泄漏。
过拟合现场:把噪声当规律
传感器老化预测工单:三十个标定点的电压-漂移数据,要求拟合"漂移曲线"。新手的第一反应是拉高多项式阶数,九阶多项式把训练点穿得一丝不苟,换一批新测点预测却离谱——模型把测量噪声背了下来,当成物理规律去外推。
import numpy as np rng = np.random.default_rng(30) x = np.sort(rng.uniform(0, 1, 30)) y = np.sin(2*np.pi*x*0.6) + 0.25 * rng.standard_normal(30) x_test = np.sort(rng.uniform(0, 1, 200)) y_test = np.sin(2*np.pi*x_test*0.6) def fit_poly(deg, lam=0.0): """最小二乘(可选岭正则)拟合 deg 阶多项式""" A = np.vander(x, deg + 1, increasing=True) AtA = A.T @ A + lam * np.eye(deg + 1) return np.linalg.solve(AtA, A.T @ y) def predict(beta, xs): return np.vander(xs, len(beta), increasing=True) @ beta for deg in [1, 3, 5, 9, 15]: beta = fit_poly(deg) e_tr = np.mean((predict(beta, x) - y)**2) e_te = np.mean((predict(beta, x_test) - y_test)**2) print(f"阶数 {deg:>2}: 训练误差 {e_tr:.4f} 测试误差 {e_te:.4f}")
输出是教科书级的剪刀差:阶数升到十五,训练误差压到接近零,测试误差爆炸式增长。训练误差不是模型质量指标,是模型记忆能力的展示。
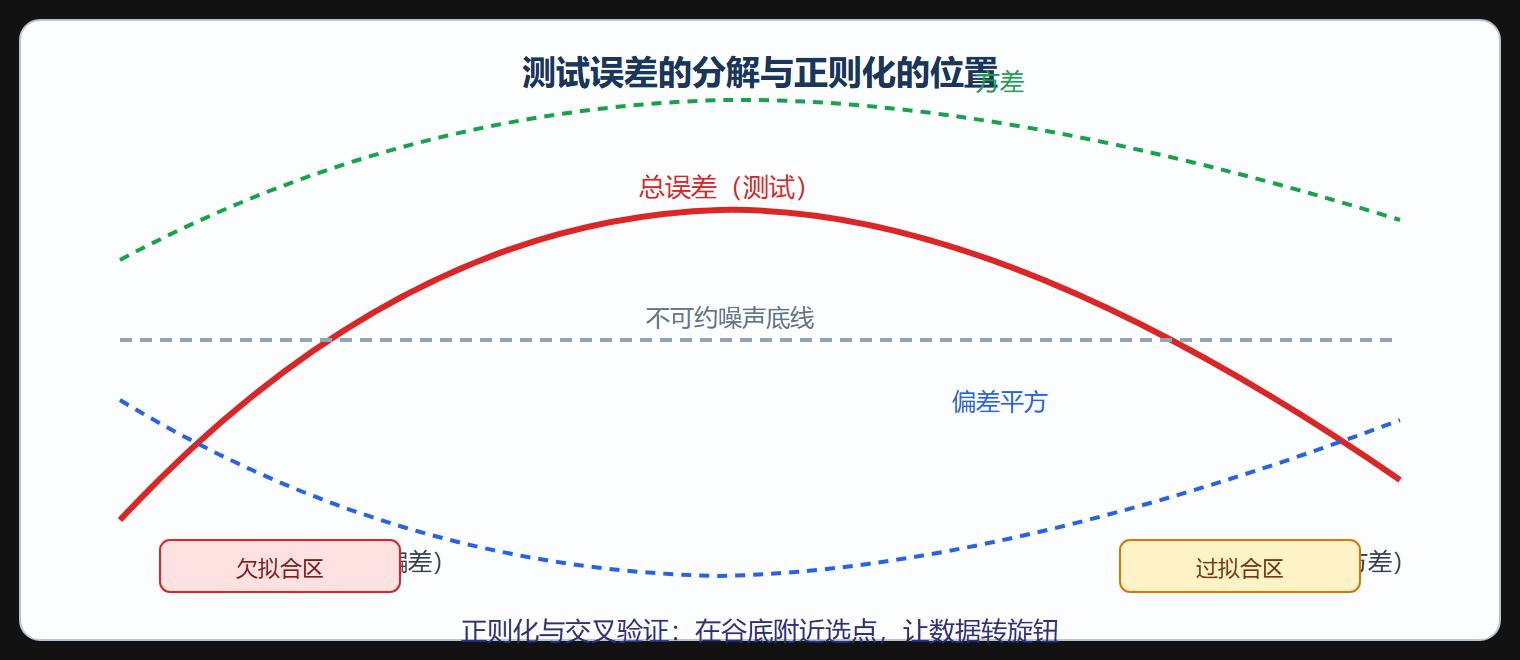
机理用偏差-方差分解看最清楚:测试误差等于偏差平方加方差加不可约噪声。高阶模型偏差小(曲线够弯),方差大(换个训练集系数就大变);低阶模型反过来。正则化的作用是主动放弃一点偏差,换取方差的大幅下降,总误差因此下降。
两种正则化:压小与选零
岭回归在损失函数里加系数平方和的惩罚(L2),把所有系数整体压小;套索加绝对值和的惩罚(L1),会把一部分系数精确压到零——做变量筛选。几何图像:L1 的约束区域是菱形,最优解容易撞在尖角上,尖角意味着某些系数恰为零;L2 的约束区域是圆盘,最优解一般落在光滑处,系数小而不为零。
import numpy as np rng = np.random.default_rng(1) n, p = 80, 12 X = rng.standard_normal((n, p)) true_beta = np.array([1.5, -2.0, 0.8] + [0.0]*(p-3)) # 只有 3 个真信号 y = X @ true_beta + 0.5 * rng.standard_normal(n) def lasso_coordinate(X, y, lam, n_iter=300): """坐标下降实现的简易套索:逐坐标软阈值更新""" n, p = X.shape beta = np.zeros(p) col_sq = (X**2).sum(axis=0) for _ in range(n_iter): for j in range(p): r = y - X @ beta + X[:, j] * beta[j] rho = X[:, j] @ r beta[j] = np.sign(rho) * max(abs(rho) - lam/2, 0) / col_sq[j] return beta for lam in [0.0, 5.0, 20.0, 60.0]: b = lasso_coordinate(X, y, lam) nz = int((b != 0).sum()) err = np.mean((X @ b - y)**2) print(f"lam={lam:>4}: 非零系数 {nz:>2} 个, 训练误差 {err:.3f}")
lambda 从零加到六十,非零系数从十二个收缩到两三个——套索把真信号留到最后。lambda 怎么定不是人拍的,是数据选的。
交叉验证:让数据选参数
K 折交叉验证:把数据切 K 份,轮流留一份当验证集,其余训练,K 个验证误差的平均作为该参数的泛化估计。扫一遍 lambda 网格,取平均误差最小者。
import numpy as np def kfold_cv_ridge(X, y, lam, k=5, seed=0): """岭回归的 K 折交叉验证,返回平均验证误差""" rng = np.random.default_rng(seed) idx = rng.permutation(len(y)) folds = np.array_split(idx, k) errs = [] for f in folds: mask = np.ones(len(y), bool); mask[f] = False A, b = X[mask], y[mask] beta = np.linalg.solve(A.T@A + lam*np.eye(X.shape[1]), A.T@b) errs.append(np.mean((X[f]@beta - y[f])**2)) return np.mean(errs) rng = np.random.default_rng(1) X = rng.standard_normal((80, 12)) y = X @ np.array([1.5, -2, .8]+[0]*9) + .5*rng.standard_normal(80) for lam in [0.01, 0.1, 1, 10, 100]: print(f"lam={lam:>6}: 交叉验证误差 {kfold_cv_ridge(X, y, lam):.3f}")
工程上有两个必须点破的坑。时间序列不能随机折:用未来数据训练再去"预测"过去,验证误差虚低,正确做法是滚动起点——每次用截止到 t 的数据训练、预测 t 到 t 加一段。数据预处理要折内完成:标准化、特征筛选都必须在训练折内做完再应用到验证折,否则验证集信息从预处理管道泄漏进模型。第二类泄漏更隐蔽也更常见,值得写进团队规范。
模型选择的完整检查单:交叉验证曲线是否平滑(锯齿状说明折数不够或数据太少)、选中的参数是否落在网格中间(落在边界要扩网格)、最终模型要在全量数据上重训(验证集的信息不再浪费)、留出一份从不参与任何调参的最终测试集做收官评估。
⚠️ 常见坑:用交叉验证误差直接向业务方报告模型性能。交叉验证参与了参数选择,数字偏乐观;对外承诺的性能指标必须来自从未沾过调参过程的独立测试集。
💡 关键直觉:正则化强度是"信数据多少"的旋钮。旋到零是全信训练数据(方差爆炸),旋到无穷是完全不信(常数预测,偏差爆炸)。交叉验证就是让数据自己转这个旋钮。
偏差方差与模型选择
本节要点回顾
- 训练误差展示记忆能力,模型质量必须看独立数据上的误差;
- 偏差-方差分解解释剪刀差:复杂度抬升方差,正则化用偏差换方差;
- 岭压小、套索选零:要稀疏选 L1,要稳定共线性场景选 L2;
- 交叉验证选参,时间序列用滚动起点,预处理折内完成防泄漏;
- 对外性能指标只能来自从未参与调参的独立测试集。