5.4 优化理论:寻找最优解
5.4 优化理论:寻找最优解
本节摘要:优化研究在约束下寻找最优决策,从线性规划的单纯形法与对偶理论,到凸优化"局部即全局"的黄金性质,再到梯度下降的收敛性与步长选择。本节求解一个完整的运输线性规划并解读对偶价格,实现带投影的梯度下降,讨论机器学习训练中的优化实践(学习率、随机化、条件数),收官整章的工程闭环。
资源分配的普适数学
生产线怎么排产、快递怎么分仓、投资怎么配比、模型参数怎么调——骨子里都是同一个数学问题:在一组约束下最小化(或最大化)一个目标函数。优化理论按目标与约束的形态分诊:线性规划(目标与约束都线性)有多项式算法、有成熟求解器,是运筹学的看家本领;凸优化(目标凸、可行域凸)享有"局部最优即全局最优"的黄金性质;非凸优化(如深度学习)则只能指望找到够好的局部解。分诊清单决定求解策略与结论可信度。
线性规划:从一个运输问题说起
背景:三个仓库向四个城市供货,仓库库存与城市需求给定,运输单价不同,求总成本最低的运输方案。写成标准形式:决策变量是每条路线的运量,约束是库存上限与需求满足,目标是总运费最小。用 SymPy 的求解器完整跑一遍:
import scipy.optimize as opt import numpy as np cost = np.array([[4, 6, 9, 5], [5, 3, 8, 7], [7, 4, 6, 8]]) # 仓库 i 到城市 j 的单位运费 supply = [80, 70, 60] # 各仓库库存 demand = [50, 60, 70, 30] # 各城市需求(总需求 = 总库存 = 210) # scipy 标准形式:min c.x s.t. A_ub x <= b_ub n_var = cost.size c = cost.flatten() A_eq = np.zeros((7, n_var)) # 3 条库存约束 + 4 条需求约束 b_eq = supply + demand for i in range(3): A_eq[i, i*4:(i+1)*4] = 1 for j in range(4): for i in range(3): A_eq[3+j, i*4+j] = 1 res = opt.linprog(c, A_eq=A_eq, b_eq=b_eq, bounds=(0, None), method="highs") print(f"最低总运费 = {res.fun:.0f}") print(np.round(res.x.reshape(3, 4), 1)) # 输出最优运输矩阵 # 结构解读:每个仓库优先服务它相对便宜的城市;剩余量由次优路线兜底
对偶理论是线性规划的深度所在:每个规划都有对偶版本,最优值相等。对偶变量的经济学名字叫影子价格——某仓库库存增加一单位,总成本下降多少。线性规划只回答"最优方案",对偶回答"约束值多少钱",后者往往才是决策者真正想知道的:
# highs 求解器的对偶信息 print(np.round(res.ineqlin.marginals if hasattr(res, "ineqlin") else [], 4)) # 等式约束的对偶(影子价格)可直接从求解器读取:为负表示该约束放松可降成本 # 管理含义:影子价格大的仓库值得扩容——这是"数据驱动扩产决策"的数学内核
凸性:最值钱的数学性质
凸函数的定义是"割线在曲线上方",几何直观是碗形。碗形的算法学意义:任何局部极小都是全局极小,梯度信息永远不会骗你。判定靠二阶条件(第 3 章的泰勒展开在此服役):黑塞矩阵半正定则凸。线性规划、最小二乘、支持向量机、逻辑回归全是凸问题——机器学习中"能保证收敛到全局"的那部分,正是凸的那部分。
import math def projected_gradient_descent(grad_f, proj, x0, lr=0.1, iters=300): # 投影梯度下降:每步沿负梯度走,再投影回可行域 x = x0 trace = [x] for _ in range(iters): x = proj([x[0] - lr * grad_f(x)[0], x[1] - lr * grad_f(x)[1]]) trace.append(x) return x, trace # 例:min f = (x1-3)^2 + 2*(x2+1)^2,约束 x1 + x2 <= 1(半平面) grad = lambda x: [2*(x[0]-3), 4*(x[1]+1)] def proj_halfplane(p): # 投影到 x1+x2<=1:若违反,沿法向 (1,1) 拉回 if p[0] + p[1] <= 1: return p t = (p[0] + p[1] - 1) / 2 return [p[0] - t, p[1] - t] x_opt, trace = projected_gradient_descent(grad, proj_halfplane, [0.0, 0.0]) print(f"最优解 x = ({x_opt[0]:.3f}, {x_opt[1]:.3f}), 约束和 = {x_opt[0]+x_opt[1]:.3f}") # 输出:无约束解 (3, -1) 违反约束;投影后最优被压在边界 x1+x2=1 上 # 拉格朗日乘子视角:边界上的最优 = 目标梯度与约束法向平行——对偶变量的几何原型
优化问题分诊与算法选路
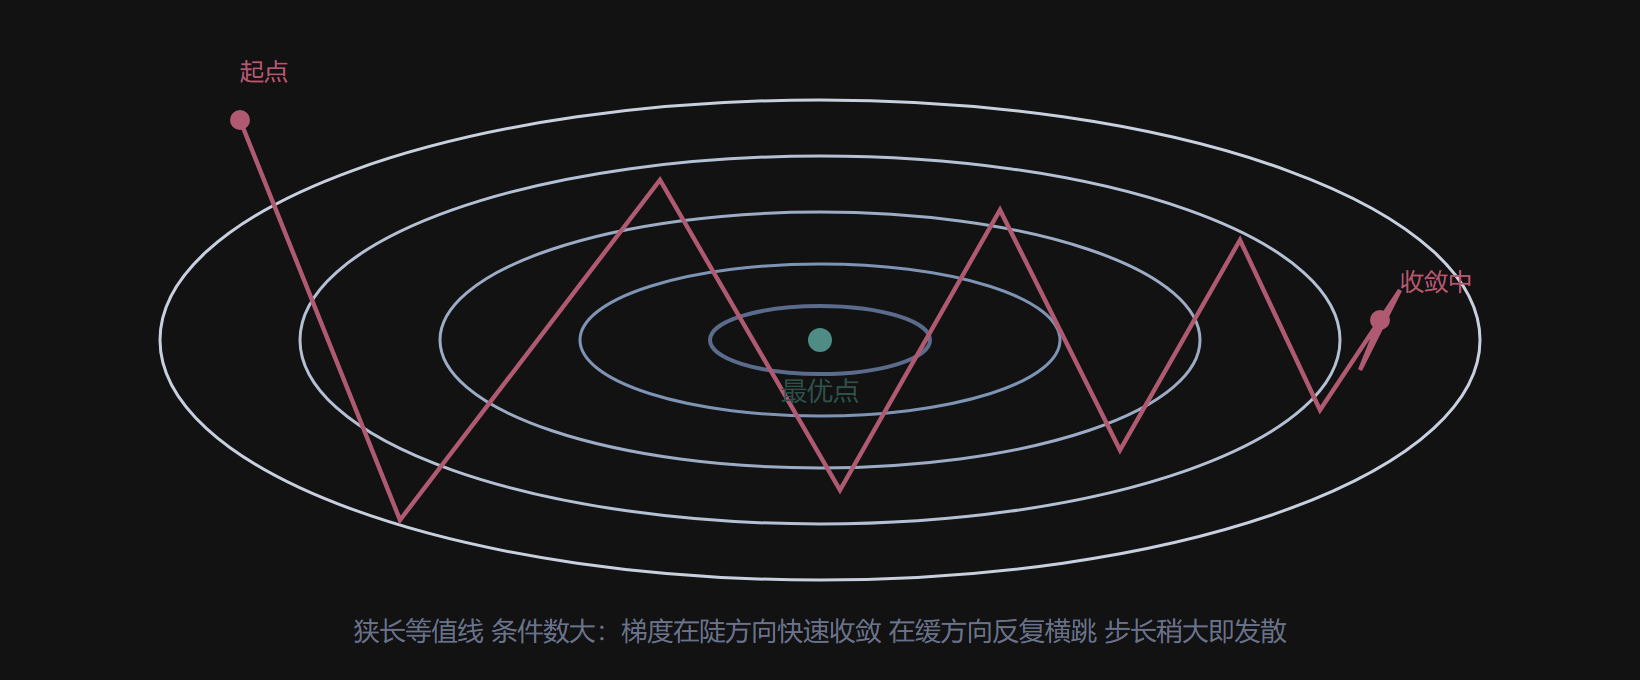
梯度下降在病态峡谷中的轨迹示意
梯度下降:机器学习的默认引擎
深度学习的损失面高度非凸,但随机梯度下降(每次只用一小批样本估计梯度)在实践中稳定产出够好的解。三个调参常识值得记住。学习率:太大发散、太慢爬行,衰减策略(先大后小)是标配。随机性:小批量噪声反而帮助跳出尖锐的局部极小,泛化更好的往往是平坦解。条件数(第 2 章):椭圆等值线拉得越长收敛越慢,这是归一化特征、残差连接等工程手段的深层动机。看一个病态示例的实测:
def gd_on_quadratic(Q, x0, lr, iters=50): # min 0.5 x^T Q x,梯度为 Q x;Q 的条件数决定收敛速度 x = x0[:] for _ in range(iters): x = [x[0] - lr*(Q[0][0]*x[0]+Q[0][1]*x[1]), x[1] - lr*(Q[1][0]*x[0]+Q[1][1]*x[1])] return x well = [[1.0, 0.0], [0.0, 1.0]] # 条件数 1:等值线正圆 ill = [[10.0, 0.0], [0.0, 1.0]] # 条件数 10:等值线狭长椭圆 print(gd_on_quadratic(well, [5.0, 5.0], 0.15)) # 收敛到 (0,0) 附近 print(gd_on_quadratic(ill, [5.0, 5.0], 0.15)) # 快方向收敛,慢方向残留——抖振 print(gd_on_quadratic(ill, [5.0, 5.0], 0.18)) # 步长稍大即发散:病态限制最大步长 # 结论:条件数既拖慢收敛又压缩稳定步长区间;预处理(把 Q 近似单位化)是根本解法
💡 一句压箱的话:优化问题的第一次分类不是"用什么算法",而是"它凸不凸"。凸性问题交给凸求解器拿全局解,非凸问题才谈初始化、随机化与早停这些"手艺"。
本节要点回顾
- 优化按形态分诊:线性规划有多项式算法、凸优化有全局保证、非凸靠手艺与运气;
- 对偶变量是影子价格:约束放松一单位值多少钱,是决策优化的关键信息;
- 凸性 = 局部即全局,二阶条件(黑塞半正定)是判定工具;
- 投影梯度下降把约束处理成"走一步拉回来",是约束优化的最小可行实现;
- 条件数同时拖慢收敛与压缩稳定步长,特征归一化与预处理的深层动机。
工程闭环走完。最后一章回到高处:前沿、交叉、历史与未来——数学这台引擎正开向哪里。