3.3 协方差与相关系数
3.3 协方差与相关系数
本节摘要:协方差 Cov(X,Y)=E[(X−EX)(Y−EY)] 度量两随机变量的同向联动,除以两个标准差得相关系数 ρ,锁定在 −1 与 1 之间。本节讲清联动度量的计算、ρ=±1 与线性关系的对应、不相关与独立的差别,并用"对冲组合"案例展示组合方差公式——相关系数决定 diversified 资产能否降险。
两个赌局一起记账,涨跌会同步吗
你同时持有两个赌局:黄金与股票。各自期望方差都可算,但组合的盈亏还取决于它们是否同涨同跌。度量联动的数字是协方差:
Cov(X,Y) = E[(X−EX)(Y−EY)] = E(XY) − EX·EY
直觉:X 高于均值时 Y 也倾向高于均值,乘积为正,协方差为正——同向联动;反向联动为负;无联动时正负抵消趋于 0。协方差的量纲是两个变量量纲的乘积,数值大小没法跨场景比较,于是除以 σₓσᵧ 标准化得相关系数:
ρ = Cov(X,Y)/(σₓσᵧ),恒有 −1 ≤ ρ ≤ 1。ρ=1 完全正相关(Y 是 X 的正斜率线性函数),ρ=−1 完全负相关,ρ=0 称不相关。经验读法:|ρ| 在 0.1 以下极弱、0.3 弱、0.5 中、0.7 以上算强——但跨领域没有统一门槛,样本相关系数还要做显著性检验(第 7 章工具)。
import numpy as np rng = np.random.default_rng(99) n = 500_000 z1, z2 = rng.normal(0, 1, (2, n)) # 构造不同相关强度的配对:Y = ρ*X + sqrt(1-ρ²)*Z for rho in [0.9, 0.5, 0.0, -0.7]: X = z1 Y = rho*z1 + np.sqrt(1 - rho**2)*z2 print(f"理论 ρ={rho:+.1f} 样本相关系数 {np.corrcoef(X, Y)[0,1]:+.4f}" f" 样本协方差 {np.cov(X, Y, bias=True)[0,1]:+.4f}")
样本相关系数逐行贴近构造值——构造公式本身(Cholesky 思想的二维版)也值得记住:它是第 4 章二维正态与模拟相关样本的标准手法。
不相关 ≠ 独立:一条高频红线
独立(联合可分解)推出不相关,反过来不成立:ρ=0 只排除线性关系,非线性依赖可以完全藏住。经典反例:X ~ N(0,1),Y=X²。Y 由 X 完全决定,但 Cov(X,Y)=E(X³)=0(奇函数对称积分为零),相关系数为 0。模拟验证这个反例,并对照一个真正独立的对照:
import numpy as np rng = np.random.default_rng(123) X = rng.normal(0, 1, 1_000_000) Y = X**2 # 完全依赖 但非线性 print("X 与 X平方 相关系数 = %+.4f" % np.corrcoef(X, Y)[0,1]) # 约 0 print("X 与 X平方 协方差 = %+.4f" % np.cov(X, Y, bias=True)[0,1]) Z = rng.normal(0, 1, 1_000_000) print("X 与 独立Z 相关系数 = %+.4f" % np.corrcoef(X, Z)[0,1]) # 约 0
两行输出数值都是 0 附近,但一个背后是完全依赖、一个是真独立——相关系数只能检测线性,看不见非线性结构。散点图不可跳过的原因就在这里。
对冲组合:相关系数进入方差公式
两资产组合 W = aX + bY 的方差不等于方差相加,联动项必须出场:
Var(aX + bY) = a²Var(X) + b²Var(Y) + 2ab·Cov(X,Y)
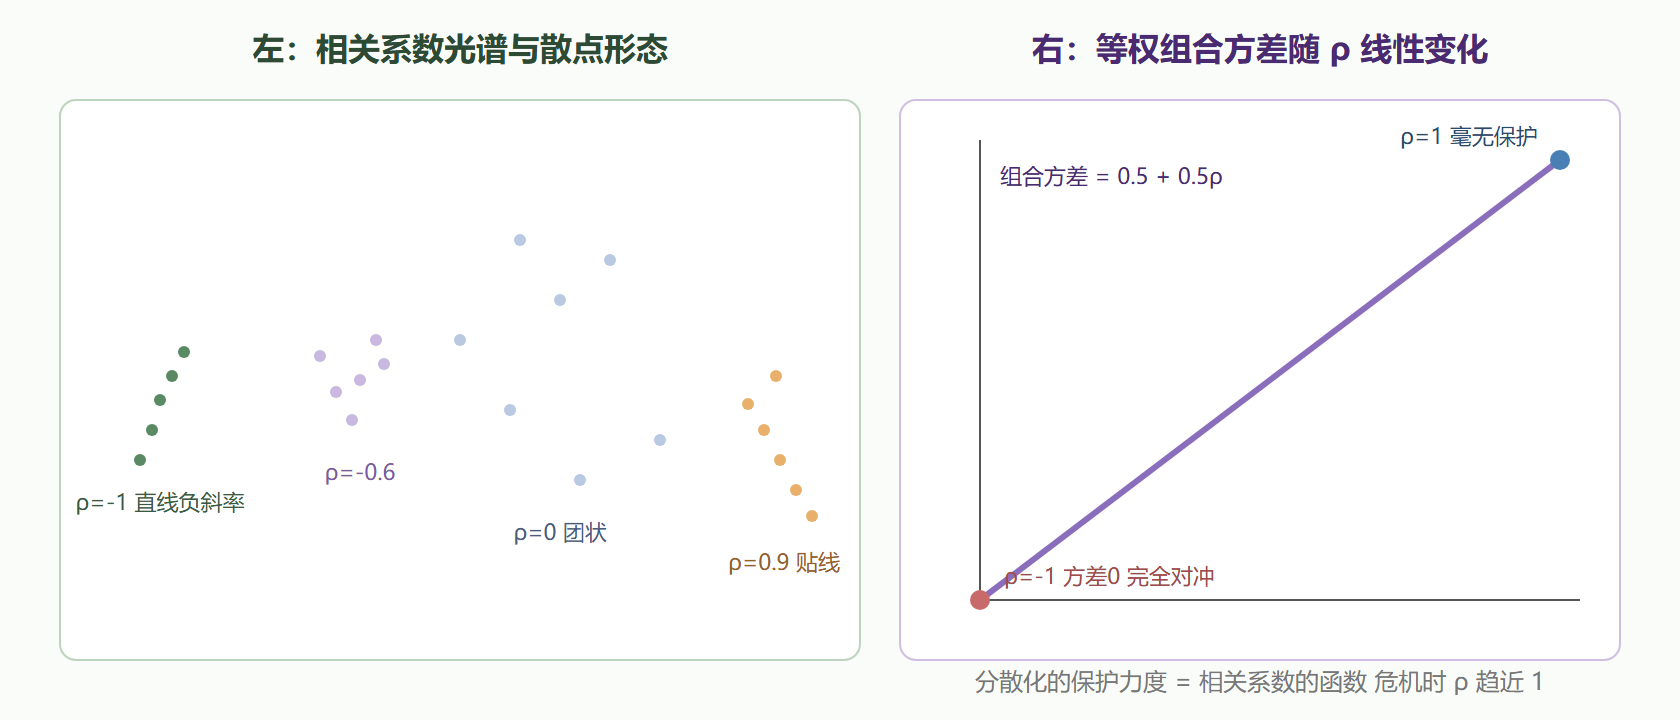
等权组合(a=b=0.5)在 ρ=1 时波动完全不抵消;ρ=−1 时可用权重完全对冲;ρ=0 时组合方差降到单资产一半。这是"不把鸡蛋放一个篮子"的数学本体,篮子之间的相关系数决定保护力度:
import numpy as np rng = np.random.default_rng(8) n = 1_000_000 z1, z2 = rng.normal(0, 1, (2, n)) for rho in [1.0, 0.5, 0.0, -0.5, -1.0]: Y = rho*z1 + np.sqrt(1-rho**2)*z2 port = 0.5*z1 + 0.5*Y # 等权组合 theory = 0.25 + 0.25 + 0.5*rho # 方差公式手算值(单资产方差=1) print(f"ρ={rho:+.1f} 组合方差 模拟 {port.var():.4f} 公式 {theory:.4f}")
模拟与公式逐点吻合。ρ=−1 时组合方差恰为 0(完美对冲),ρ 从 1 滑向 −1,组合方差从 1 均匀降到 0——分散化的收益完全由相关系数定价。实务中危机时刻资产相关性会趋近 1("危机里所有相关性变成 1"是风控行业的老话),分散保护恰在最需要时失效,这是协方差公式背后最重要的实践警告。
图 3-2 相关系数光谱与组合方差曲线
样本相关系数的波动:小样本能"看见"多强的相关
样本相关系数 r 本身是随机变量——样本量小的时候,即使总体 ρ=0,r 也常能跑到 ±0.3 之外。这正是"数据挖出假相关"的数学根源。量化一下这个噪声幅度:
import numpy as np rng = np.random.default_rng(909) for n in [10, 30, 100]: rs = [] for _ in range(20_000): x, y = rng.normal(0, 1, (2, n)) # 真实 rho = 0 rs.append(np.corrcoef(x, y)[0, 1]) rs = np.array(rs) print(f"n={n:3d}: 真实ρ=0 但样本r超±0.3的概率 {(abs(rs)>0.3).mean():.3f}")
n=10 时约有 12% 的"假相关"强度超过 0.3;n=100 才压到 1% 以下。**样本相关系数必须配显著性检验或置信区间报告**(第 7 章工具),裸报 r 值等于 invites 数据挖掘陷阱。同源的教训:对 20 个变量两两算相关,210 对里"显著"的对子几乎必然出现——又是 7.2 节多重比较的伏笔。
本节要点回顾
- 协方差度量同向联动,量纲纠缠使它只配做中间量,比较用相关系数
- ρ ∈ [−1,1]:±1 对应精确线性关系,0 只排除线性
- 不相关 ≠ 独立:X 与 X² 完全依赖却零相关,非线性结构要靠散点图
- 组合方差公式带联动项 2abCov:对冲的可能性由 ρ 定价
- 构造指定相关的样本:Y = ρX + √(1−ρ²)Z,模拟相关结构的标准手法
- 危机相关性趋 1:分散保护在最需要时变弱,工程上的第一警告