4.1 联合分布、边际分布与条件分布
4.1 联合分布、边际分布与条件分布
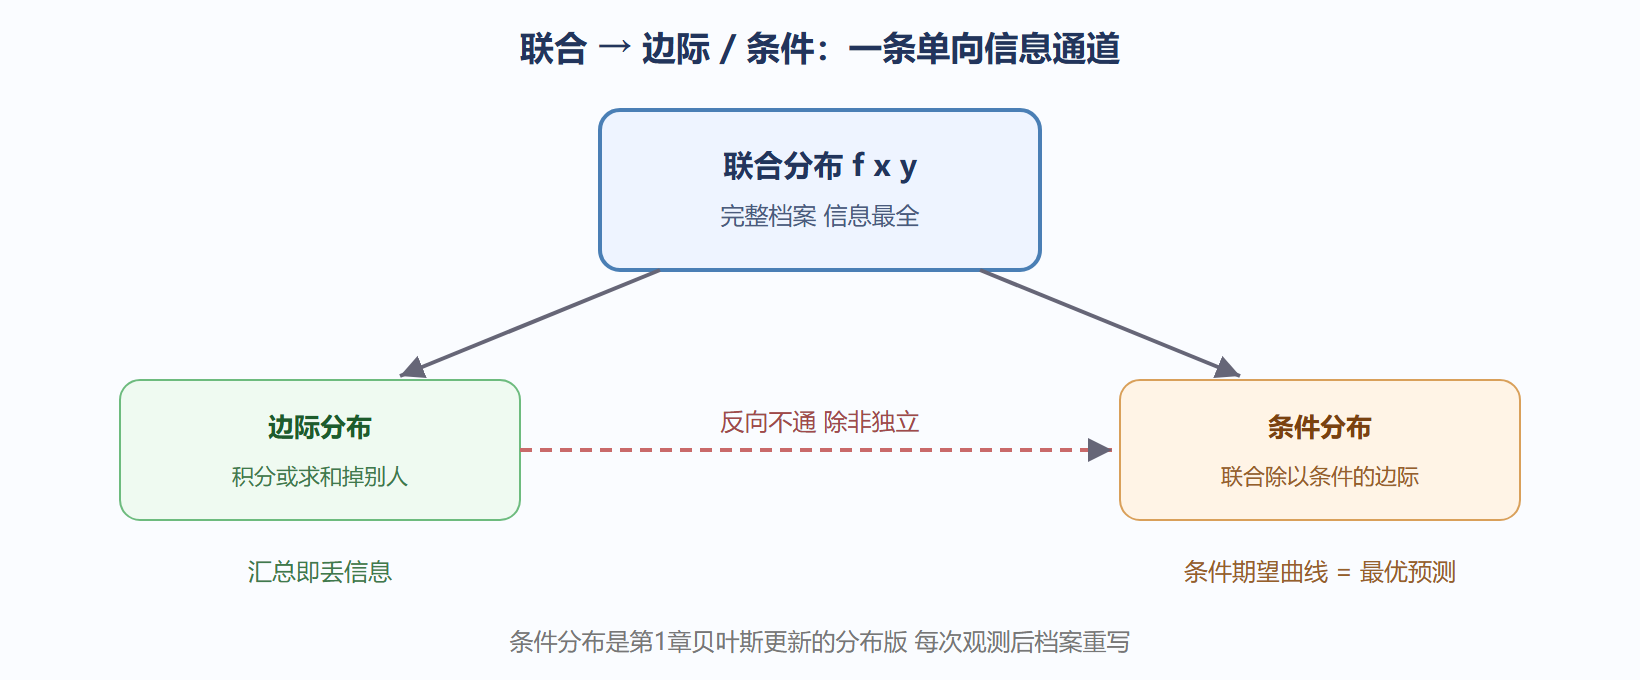
本节摘要:联合分布是多个随机变量的完整档案;边际分布由联合"求和/积分掉"其他变量得到,信息有损;条件分布由联合除以条件变量的边际得到,是第 1 章条件概率在分布层面的升级。三种分布之间"联合 → 边际/条件"单向可走、反向需要额外信息,本节用离散赌局与连续等待时间两个案例走完全部换算通道。
从一张二维价目表说起
赌局:掷两颗骰子,X 记第一颗点数,Y 记第二颗点数减 3 的值。关心的不是单骰,而是两骰的联合行为——比如"第一颗 6 且第二颗减 3 为 2"的概率。把 P(X=x, Y=y) 排成矩阵就是**联合分布律**;连续情形对应联合密度 f(x,y),概率是区域上的二重积分。联合分布是完整档案:从中可以读出一切问题的答案。三个操作定义了整个章法:
- 边际化:f_X(x) = ∫ f(x,y)dy(把 y 积掉),离散即按列求和——档案变薄,丢掉联动信息
- 条件化:f_{Y|X}(y|x) = f(x,y)/f_X(x)——已知 X=x 时 Y 的密度,第 1 章条件概率的连续版
- 独立性:f(x,y) = f_X(x)f_Y(y) 处处成立——联合档案等于两份单变量档案的乘积
信息含量的次序:联合 ⊇ 边际。知道联合能重建边际,反之不行——这正是"汇总统计会丢信息"的最根本版本。
离散案例:一张不独立的价目表
设 X 取 0/1,Y 取 0/1,联合分布律如下(单位 1/8):
| X\Y | 0 | 1 |
|---|---|---|
| 0 | 3 | 1 |
| 1 | 1 | 3 |
import numpy as np from fractions import Fraction J = np.array([[3, 1], [1, 3]], dtype=float) / 8 # 联合分布律 px = J.sum(axis=1) # X 的边际:按行内求和 py = J.sum(axis=0) # Y 的边际:按列求和 print("X 边际:", px, " Y 边际:", py) # 各 [0.5, 0.5] print("独立检验: 联合 vs 边际外积") print(J, "\n", np.outer(px, py)) # 不相等 → 不独立 cond_Y_given_X1 = J[1, :] / px[1] # X=1 时 Y 的条件分布 print("X=1 时 Y 的条件分布:", cond_Y_given_X1) # [0.25, 0.75] print("无条件时 Y 的分布: ", py) # [0.5, 0.5]
输出里最有信息量的一行对比:知道 X=1 之后,Y=1 的概率从 0.5 跳到 0.75——**条件分布就是信息更新后的新档案**。注意联合矩阵不是边际外积(左上 3/8 ≠ 1/4),所以两变量不独立:知道一个确实改变另一个的定价。这张 2×2 表就是所有"联合→边际→条件"操作的显微镜版本。
连续案例:等待时间的条件分布
呼叫台两类事件:技术支持来电间隔 X ~ Exp(2)、投诉来电间隔 Y ~ Exp(1),构造相关结构( Clayton 型耦合:Y = X·U,U 为独立扰动)后观察条件分布如何随观测值改变。更干净的标准例子是二维指数:先看纯手算可验证的版本——X, Y 独立且都服从 Exp(λ),条件化后仍是 Exp(λ),独立性使条件=边际;若令 Z = X+Y,则已知 Z=t 时 X 的条件分布是 U(0,t) 均匀——和的分解均匀落回区间,这个优雅结论来自卷积对称性:
import numpy as np rng = np.random.default_rng(31) n = 1_000_000 X = rng.exponential(1, n) Y = rng.exponential(1, n) mask = (X + Y > 2.0) & (X + Y < 2.04) # 近似条件 X+Y≈2 x_cond = X[mask] print("条件样本数:", mask.sum()) # 约几千个 print("已知和≈2 时 X 的分布: 均值 %.3f (理论 1.0)" % x_cond.mean()) print("落在 [0, 0.5) 的比例 %.3f (理论 0.25)" % ((x_cond < 0.5).mean())) print("落在 [1.5, 2) 的比例 %.3f (理论 0.25)" % ((x_cond > 1.5).mean()))
均值贴住 1.0、两端各占四分之一——和固定时分解均匀分布得到验证。条件采样用"事件筛选法"(模拟中只保留满足条件的那部分样本)实现,这是蒙特卡洛求条件分布的通用土办法,直观且够用。
条件期望:最优预测器
条件分布的均值 E(Y|X=x) 随 x 变化形成一条曲线,这条曲线有一个决策论身份:在均方误差意义下,它是用 X 预测 Y 的最优预测函数。不管你的预测器 g 多聪明,E[(Y−g(X))²] 在 g(X)=E(Y|X) 处取最小。回归分析的全部野心,就是从数据估计这条曲线——第 9 章的线性回归是把它近似成直线的特例。
import numpy as np rng = np.random.default_rng(55) X = rng.uniform(0, 4, 2_000_000) Y = 2*X + rng.normal(0, 1, 2_000_000) # 真实条件期望是直线 2x # 估计 E(Y|X≈x):取 X 落在窄带内的样本均值 for x0 in [1.0, 2.0, 3.0]: band = (X > x0 - 0.02) & (X < x0 + 0.02) print(f"X≈{x0:.0f} 时条件均值估计 {Y[band].mean():.3f} 理论 {2*x0:.1f}")
窄带均值逐点贴住理论直线 2x。这就是"条件期望曲线"的非参数估计原型——分箱平均,一切回归的祖先。
图 4-1 三种分布的信息通道
⚠️ 常见坑:把边际分布相同当成联合分布相同。两组完全不同的联动结构可以有一样的边际——X(0)=Y(0) 各 0.5 的独立情形与完全正相关情形边际完全相同。金融风控史上的若干惨案(把组合风险当单个资产风险之和)根源就在只看边际丢掉联合。
本节要点回顾
- 联合分布是唯一完整档案,边际是它的有损投影,信息不可逆
- 边际化 = 积掉别人;条件化 = 联合除以边际,离散连续一套章法
- 条件分布即信息更新后的新档案,与第 1 章贝叶斯公式同源
- 条件期望 E(Y|X) 是均方误差最优预测:回归的理论终点
- 模拟求条件分布的土办法:事件筛选 + 窄带均值,简单通用
- 边际相同不代表联合相同:只看边际的汇总天然丢联动信息