4.2 独立性、二维正态与随机变量的函数
4.2 独立性、二维正态与随机变量的函数
本节摘要:多维场景的三大常备工具——分布层面的独立性判别(联合可分解,比零相关强得多)、二维正态模型(相关系数 ρ 直接刻画椭圆等高线的扁长程度,且在此模型中零相关与独立等价)、随机变量函数的分布求法(和用卷积、最大最小值用分布函数法)。全程手算推导配蒙特卡洛验证。
独立性的严格判据:能拆开才算
第 3 章说过零相关不等于独立,这里给出完整判据:X 与 Y 独立,当且仅当联合分布处处等于边际之积——离散是矩阵可写成外积,连续是联合密度可分解为 f_X(x)f_Y(y)。等价的推论:独立变量们的任何函数 g(X) 与 h(Y) 也独立;独立时条件分布退化为边际(知道一个不改变另一个的档案)。判别流程建议:先看机制(试验是否物理独立)→ 再验证联合可分解 → 相关系数只能当弱线索。两个都掷各自的骰子当然独立;但"从一副牌里连抽两张"抽出不放回,前后两张就不独立——边际相同、联合不可分解,超几何分布的内核正是这个负相关。
和的分布:卷积的登场
已知 X、Y 独立且分布已知,求 Z=X+Y。离散情形把所有 x+zᵢ=y 的组合概率相加;连续情形得到卷积积分 f_Z(z) = ∫ f_X(x) f_Y(z−x)dx。手算经典例:X,Y 独立且同为 U(0,1),则 Z=X+Y 是三角分布,密度在 z=1 处达峰 1、两端为 0:
import numpy as np rng = np.random.default_rng(12) n = 2_000_000 X, Y = rng.random(n), rng.random(n) Z = X + Y # 分箱统计经验密度 对照三角密度手算值 z 与 2-z for z0 in [0.3, 0.7, 1.0, 1.4]: inbin = (Z > z0 - 0.005) & (Z < z0 + 0.005) emp = inbin.mean() / 0.01 theory = z0 if z0 <= 1 else 2 - z0 print(f"z={z0}: 经验密度 {emp:.3f} 三角分布理论 {theory:.3f}") # 卷积的可视化直觉:独立和的方差相加 print("Var X + Var Y = %.3f Var(X+Y) = %.3f" % (X.var() + Y.var(), Z.var())) # 两者都是 1/6
经验密度逐点贴住三角公式。独立和的方差相加(协方差为零时)是卷积最重要的数字后果——两个误差源叠加,标准差按 √2 增长而非翻倍,测量仪器的误差合成全靠这一条。
最大值的分布:分布函数法
求 M = max(X,Y):最大值不超过 m,等价于两个都不超过 m,独立时 F_M(m) = F_X(m)F_Y(m)——最大值的 CDF 是各 CDF 的乘积。反过来 min 的 CDF 是 1 − (1−F)乘积。这个"乘积法则"简单到容易低估其威力:可靠性工程里串联系统(任一元件失效即失效)的寿命 = min,并联冗余系统的寿命 = max,全靠它推导。2.1 节"两颗骰子取最大"的阶梯分布就是离散版同一条法则:
import numpy as np rng = np.random.default_rng(45) n = 1_000_000 X = rng.exponential(1, n) # 两元件独立寿命 Exp(1) Y = rng.exponential(1, n) M = np.maximum(X, Y) # 理论:F_M m = 1-e^-m 的平方 ⟹ 密度 2e^-m 1-e^-m for m in [0.5, 1.0, 2.0]: emp = (M < m).mean() theo = (1 - np.exp(-m))**2 print(f"m={m}: P(max<m) 模拟 {emp:.4f} 乘积法则 {theo:.4f}") print("max 期望 模拟 %.3f 理论 1.5" % M.mean()) # 1+1/2
模拟逐点对齐乘积法则,期望贴住理论值 1.5(一般地 n 个 Exp 取最大期望是调和和 1+1/2+…+1/n)。
二维正态:把相关系数画进椭圆
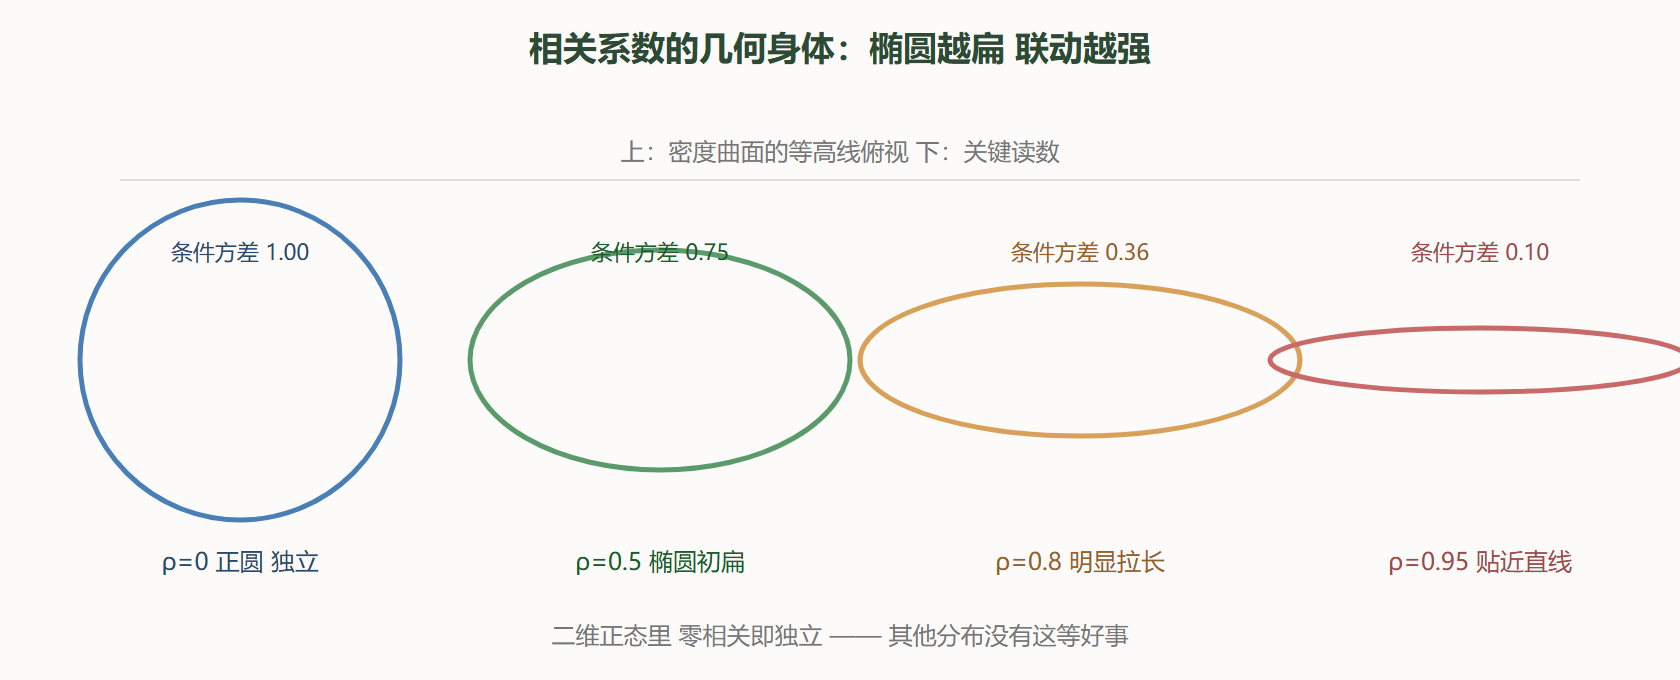
(X,Y) 服从二维正态时,联合密度的等高线是一族同心椭圆:ρ=0 时是正圆(独立!),|ρ| 趋近 1 时椭圆越来越扁、趋向一条对角线。二维正态是"零相关 ⟺ 独立"成立的稀有模型——因为正态的联合结构完全由均值与协方差决定,没有藏非线性依赖的余地。这就是为什么在正态假设下的分析(包括第 9 章回归的经典推断)可以放心用相关系数谈独立:
import numpy as np rng = np.random.default_rng(19) n = 500_000 rho = 0.8 z1, z2 = rng.normal(0, 1, (2, n)) Y = rho*z1 + np.sqrt(1-rho**2)*z2 # 标准二维正态采样 sample_corr = np.corrcoef(z1, Y)[0, 1] # 落在椭圆等高线内的概率验证:例如 |x|<1 且 |y|<1 的矩形近似 print("样本相关 %.4f (构造 %.1f)" % (sample_corr, rho)) # 条件分布:给定 X=x 时 Y 正态 均值 rho*x 方差 1-rho^2 band = np.abs(z1) < 0.02 print("X≈0 时 Y 均值 %.3f 方差 %.3f 理论 0 与 %.3f" % (Y[band].mean(), Y[band].var(), 1-rho**2))
条件方差 1−ρ²=0.36 被精确复现——知道 X 之后 Y 的不确定性缩小为原来的 36%,信息增益被参数 ρ 明码标价。回归的可决系数 R² 在二维正态里恰是 ρ²,这句话的完整展开留给第 9 章。
图 4-2 二维正态等高线:ρ 从 0 到 0.95 的椭圆蜕变
本节要点回顾
- 独立性判据是联合可分解,零相关只是弱线索;不放回抽样天然引入负相关
- 独立和的分布是卷积:U+U 得三角分布,方差相加、标准差按根号长
- 最大值的 CDF 是各 CDF 乘积,最小值对偶:可靠性串并联的直接数学
- 二维正态把 ρ 画成椭圆扁度,且零相关与独立等价(稀有特权)
- 条件方差 1−ρ² 量化信息增益:观测 X 让 Y 的不确定性明码缩水
- 手算公式 + 模拟逐点对照,是验证一切函数分布推导的标准流程