5.1 随机向量、协方差矩阵与独立同分布序列
5.1 随机向量、协方差矩阵与独立同分布序列
本节摘要:把 n 个随机变量排成向量 X = (X₁,…,Xₙ),其数字特征升级为均值向量 μ 与协方差矩阵 Σ(对角线是方差、 off 对角是协方差);独立同分布(i.i.d.)序列是极限定理的适用对象。本节讲协方差矩阵的读法、线性变换 AX+b 的传播公式,以及"样本是随机向量"这一统计学的根本视角。
从两个变量到一列变量
第 4 章把两个变量的联合档案建立起来,但一次抽样往往产生一列数:抛 n 次硬币、抽 n 件产品、测 n 个学生的身高。把这一列看成随机向量 X = (X₁,…,Xₙ)ᵀ,一揽子数字特征浓缩成两个对象:
- 均值向量 μ = (EX₁,…,EXₙ)ᵀ,每格是对应分量的期望
- 协方差矩阵 Σ,其 (i,j) 元 = Cov(Xᵢ, Xⱼ);对角线是各分量方差,off 对角线是两两协方差
Σ 是对称半正定矩阵——对称因为 Cov(X,Y)=Cov(Y,X),半正定因为对任何非零向量 a 有 Var(aᵀX) = aᵀΣa ≥ 0。这个矩阵就是第 3、4 章全部"两两联动"信息的仓库,PCA 降维、马氏距离、投资组合优化、卡尔曼滤波,全都直接吃这碗饭。
线性变换的传播公式
随机向量做线性变换 Y = AX + b 后,新向量的数字特征按矩阵传播:E(Y) = Aμ + b,Cov(Y) = AΣAᵀ。这条公式是"方差如何穿过系统传播"的总开关。组合投资一章用过它的二维特例(aᵀΣa);测量链路上误差逐级放大缩小的计算也是它。用模拟对照验证一个三维例子:
import numpy as np rng = np.random.default_rng(101) n = 1_000_000 # 构造 Σ:对角方差 4, 9,相关系数 0.5 sd = np.array([2.0, 3.0]) R = np.array([[1.0, 0.5], [0.5, 1.0]]) Sigma = np.outer(sd, sd) * R A = np.array([[1.0, 2.0], [3.0, -1.0]]) # 线性变换 # 用 Cholesky 分解生成服从 N(0,Sigma) 的样本 L = np.linalg.cholesky(Sigma) X = rng.normal(0, 1, (n, 2)) @ L.T Y = X @ A.T # Y = AX print("理论 Cov Y:\n", A @ Sigma @ A.T) print("模拟 Cov Y:\n", np.cov(Y.T, bias=True).round(3)) print("均值检查: 理论0 模拟", Y.mean(axis=0).round(4))
模拟协方差矩阵与 AΣAᵀ 在三位小数内一致。顺带演示的 Cholesky 采样(Lz 乘出指定协方差的样本)是 3.3 节二维构造法的一般化,蒙特卡洛圈的地基技术。
独立同分布:极限定理的入场券
称 X₁, X₂, … 为独立同分布(i.i.d.)序列:各变量来自同一分布(同分布)且互相独立(独立)。这是后两节极限定理的全部前提,值得逐项检查的现实对应:
- 重复掷同一颗骰子:标准 i.i.d.
- 有放回抽样:i.i.d.;无放回抽样:独立破坏(第 4 章看过负相关),当总体很大时"近似 i.i.d."
- 日收益率序列:同分布可疑(波动聚集、异方差),独立性可疑(自相关)——金融数据的 i.i.d. 假设是"方便"而非"事实",直接套中心极限定理要打折扣
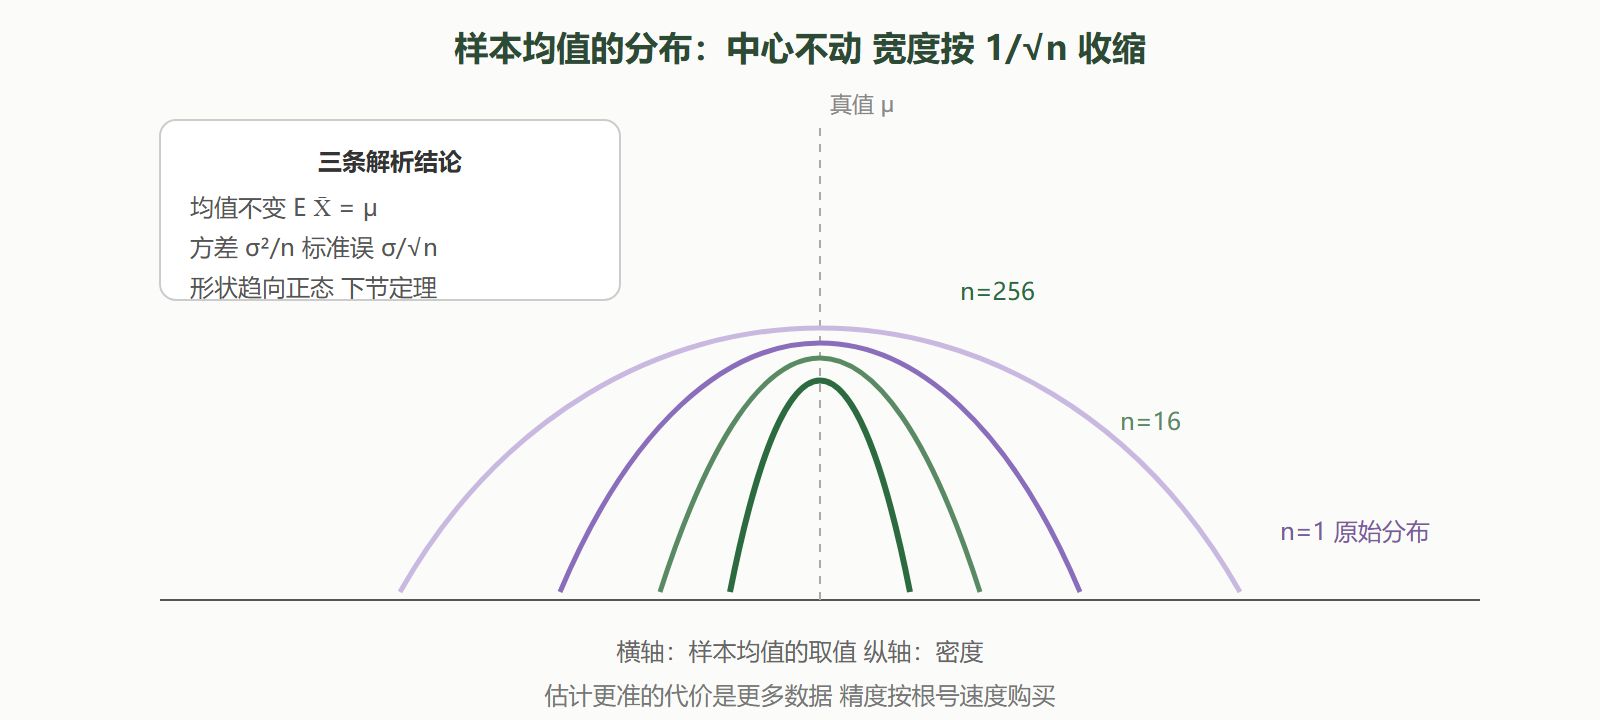
样本均值 X̄ₙ = (X₁+…+Xₙ)/n 是 i.i.d. 序列上最重要的统计量。用期望与方差的运算性质立刻得到两条小结论(大数定律的先声):E(X̄ₙ) = μ(无偏),Var(X̄ₙ) = σ²/n(波动随 n 衰减)。第二条展开写就是:
Var(X̄ₙ) = (1/n²)·ΣΣCov(Xᵢ,Xⱼ) = (1/n²)·nσ² = σ²/n
独立使 off 对角协方差全部归零,n² 项和坍缩成 n 项——协方差矩阵视角让这个推导一眼看穿。
import numpy as np rng = np.random.default_rng(7) n_sim = 100_000 for n in [1, 4, 16, 64]: xbar = rng.uniform(0, 1, (n_sim, n)).mean(axis=1) # U(0,1): μ=0.5 σ²=1/12 print(f"n={n:3d} X̄ 均值 {xbar.mean():.4f}(理论0.5)" f" X̄ 方差 {xbar.var():.5f}(理论 {1/12/n:.5f})")
X̄ 的方差精确按 1/n 衰减,均值始终钉在 μ。σ/√n 这个量在统计里有个专名——标准误,它度量"样本均值作为 μ 的估计量有多抖",第 6 章起它会出现在每一个置信区间和检验统计量里。
图 5-1 样本均值的分布随 n 收缩(同横轴尺度)
相关矩阵:协方差矩阵的标准化视图
实务分析里更常看相关矩阵 R —— Σ 的每个元素除以对应标准差。它把量纲问题一键清除,主对角线为 1、其余元素在 [−1,1]。投资组合分析、特征筛选、聚类前的预处理都在这一步完成。模拟对照两者关系:
import numpy as np rng = np.random.default_rng(808) n = 300_000 # 三个不同量纲的变量: 身高cm 体重kg 年龄岁 z = rng.normal(0, 1, (n, 3)) L = np.array([[1.0, 0.0, 0.0], [0.7, 0.7, 0.0], [0.3, 0.2, 0.9]]) data = z @ L.T * np.array([10.0, 15.0, 5.0]) # 不同尺度 Sigma = np.cov(data.T, bias=True) sd = np.sqrt(np.diag(Sigma)) R = Sigma / np.outer(sd, sd) print("相关矩阵: ", R.round(3)) print("对角线:", np.diag(R).round(3)) # 全为 1
无论各变量量纲差多大,相关矩阵对角线恒为 1、off 对角锁定在 [−1,1]——量纲无关的联动读数,这就是它成为数据分析标配第一站的原因。
本节要点回顾
- 协方差矩阵是联动信息的总仓库:对称、半正定,PCA 与组合优化的输入
- 传播公式 Cov(AX) = AΣAᵀ:方差穿越线性系统的总开关
- Cholesky 采样 Lz:生成指定协方差结构样本的标准技术
- i.i.d. 是极限定理的入场券:无放回抽样与金融收益率都在不同环节违反它
- 样本均值的两条先声结论:E(X̄)=μ、Var(X̄)=σ²/n,后者即标准误的平方
- 精度按 1/√n 购买:样本翻 4 倍精度才翻 2 倍,测量预算的现实约束