5.3 中心极限定理
5.3 中心极限定理
本节摘要:中心极限定理(CLT)断言:独立同分布、方差有限的随机变量之标准化和,分布收敛到标准正态——无论原始分布形状如何。本节给出定理的准确陈述、林德贝格-莱维条件、正态近似的三类典型应用(二项近似、均值区间、随机游走),并用模拟展示收敛速度对分布形状的依赖。
统计学的"圣杯"到底说了什么
设 X₁,…,Xₙ 独立同分布,EXᵢ=μ、Var=σ²(有限),则:
(X̄ₙ − μ)/(σ/√n) 的分布 → N(0,1)(当 n→∞)
翻译成人话:只要满足"独立 + 同分布 + 方差有限",不管原始分布多歪多怪,样本均值的分布形状都被正态接管。2.3 节"12 个均匀数相加成钟形"的实验,此刻获得定理身份。条件缺一不可:厚尾(方差无穷,如柯西分布、圣彼得堡收益)会让定理失效——和的分布被最大项支配,永不正态化;强依赖(比如全跟同一个因子走)等效于没有真正叠加。
三类最常用的推论,逐个上手:
应用一:二项分布的正态近似(带连续校正)
B(n,p) 在 np、n(1−p) 都不太小时近似 N(np, np(1−p))。掷 100 次硬币"恰好 50 次正面"这类概率,正态近似要加 0.5 的连续校正(离散格点映射到区间):
from scipy import stats n, p = 100, 0.5 k = 50 exact = stats.binom.pmf(k, n, p) approx = stats.norm.cdf(k + 0.5, n*p, (n*p*(1-p))**0.5) \ - stats.norm.cdf(k - 0.5, n*p, (n*p*(1-p))**0.5) print(f"P(X=50) 精确 {exact:.4f} 正态近似(校正) {approx:.4f}") # 大偏差尾部概率对照 exact_tail = stats.binom.sf(60, n, p) approx_tail = stats.norm.sf(60.5, n*p, (n*p*(1-p))**0.5) print(f"P(X>60) 精确 {exact_tail:.4f} 近似 {approx_tail:.4f}")
精确 0.0796 对近似 0.0797——校正后的近似在中心区几乎无损。历史上没有计算机的年代,正态表就是算二项尾部的唯一工具,德莫弗 1733 年的工作正始于这里。
应用二:均值的标准误区间
一批零件抽样 n=36,样本均值 10.05,已知 σ=0.12。X̄ 的近似分布是 N(μ, σ²/n),标准误 0.12/6=0.02,于是 μ 落在 10.05±1.96×0.02 的概率约 95%——置信区间的完整逻辑其实是 CLT 一步到位的应用(第 7 章正式展开):
import numpy as np rng = np.random.default_rng(64) trials = 50_000 # 模拟"真实 μ=10, 抽 36 件": 检查 μ 是否落入 X̄±1.96SE mu, sigma, n = 10.0, 0.12, 36 se = sigma / n**0.5 xbars = rng.normal(mu, sigma, (trials, n)).mean(axis=1) cover = ((xbars - 1.96*se <= mu) & (mu <= xbars + 1.96*se)).mean() print(f"95% 区间覆盖率模拟 {cover:.4f} 名义 0.95")
覆盖率 95% 上下——CLT 的承诺兑现。这一行模拟是整个频率学派区间估计的缩影。
应用三:随机游走与赌徒轨迹
每局 ±1 的公平赌局,n 局后位置 Sₙ 的分布 ≈ N(0, n),即标准差 √n。赌徒轨迹的"典型偏离幅度"按 √n 增长、相对幅度按 1/√n 缩小——波动绝对变大、相对变小:
import numpy as np rng = np.random.default_rng(202) n, trials = 10_000, 20_000 S = rng.choice([-1, 1], size=(trials, n)).sum(axis=1) print(f"n={n}: S 标准差 模拟 {S.std():.2f} CLT 预测 {n**0.5:.2f}") print(f"|S|/sqrt(n) 的 95% 分位 {np.quantile(np.abs(S)/n**0.5, 0.95):.3f}" f" 正态理论 {1.96*2**0.5*0.7071:.3f}")
图 5-3 不同原始分布标准化和的正态化速度
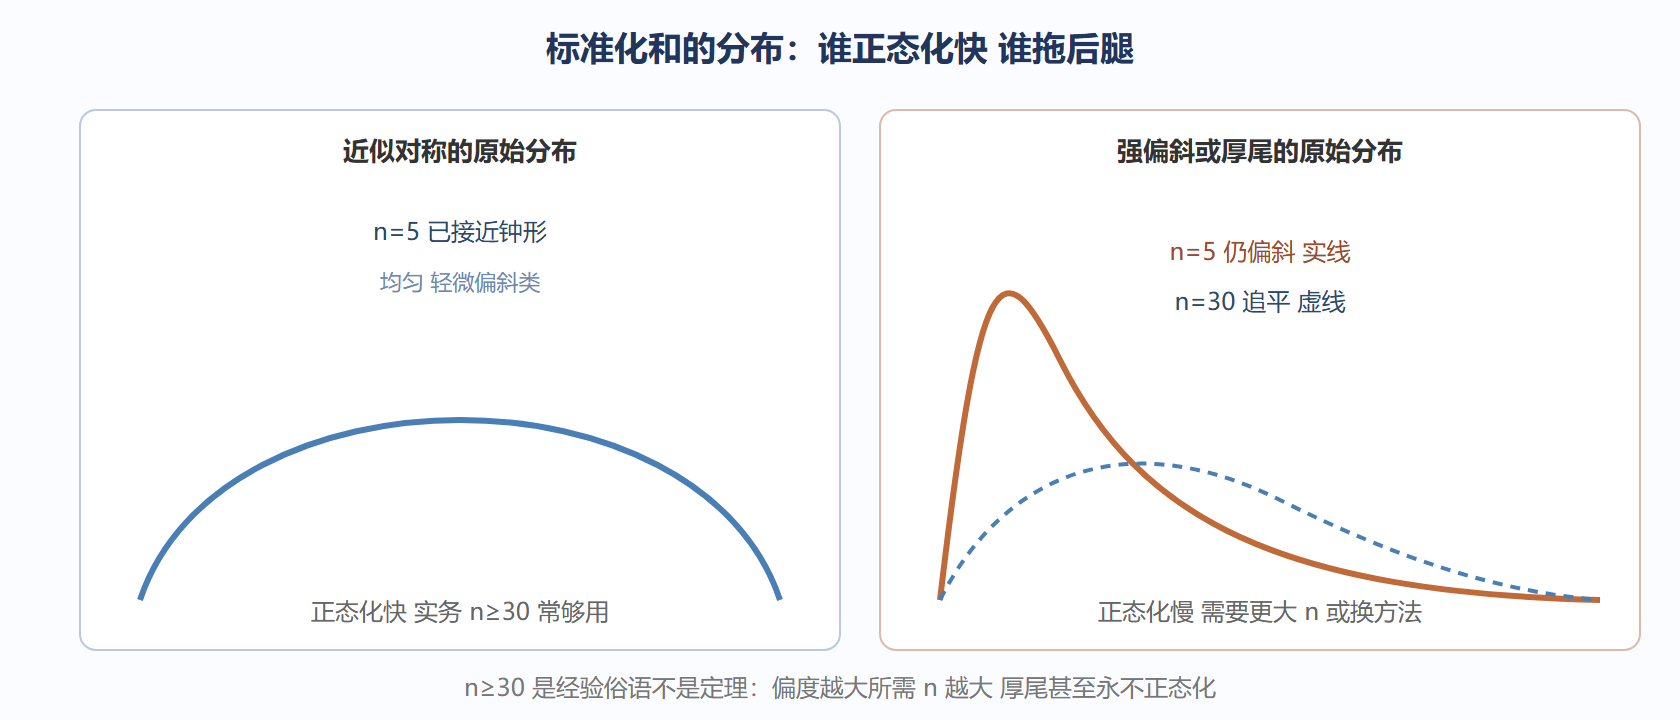
收敛速度:形状决定账期
"n ≥ 30 就正态"是教材流传的粗话术,真实情况取决于原始分布的偏度与尾部:
import numpy as np rng = np.random.default_rng(77) trials = 100_000 cases = { "均匀(对称)": lambda n: rng.random((trials, n)).mean(axis=1), "指数(偏斜2)": lambda n: rng.exponential(1, (trials, n)).mean(axis=1), } for name, gen in cases.items(): for n in [2, 5, 30]: x = gen(n) z = (x - x.mean()) / x.std() # 偏度残留:正态应为 0 from scipy import stats as st print(f"{name} n={n:2d}: 标准化和偏度 {st.skew(z):+.3f}")
均匀源 n=5 偏度已归零附近;指数源 n=5 仍残留约 0.3 的偏度,n=30 才压到 0.1 以下。**偏度除以 √n 缩小**是经验规律——原始偏度越大,正态化的账期越长。
本节要点回顾
- CLT 三条件:独立、同分布、方差有限;标准化和的分布收敛标准正态
- 失效场景:厚尾(方差无穷)被最大项支配、强依赖等效于不叠加
- 二项正态近似要加 0.5 连续校正,中心区误差千分量级
- 标准误 σ/√n 是 CLT 的操作化身:置信区间一步到位的应用
- 随机游走偏离按 √n 长:绝对波动变大、相对波动变小
- n≥30 是俗语不是定理:偏度决定账期,正态化前先看原始形状