6.1 总体、样本、统计量与三大抽样分布
6.1 总体、样本、统计量与三大抽样分布
本节摘要:总体是待推断的完整分布,样本是从中抽出的 i.i.d. 随机向量,统计量是不含未知参数的样本函数——它自身的分布叫抽样分布。样本均值与样本方差是两大基本统计量,其精确抽样分布由正态总体下的三大分布(卡方、t、F)给出。本节完成语言装配并逐一模拟验证三大分布的定义式。
样本的随机性从哪里来
质检员从流水线抽 5 件测长度。那 5 个数是"死数据"吗?在统计视角下不是——在抽之前,它们是 5 个 i.i.d. 随机变量,每个都服从总体分布 F;抽完之后才凝固成具体数字。统计推断的全部逻辑建立在这个双重身份上:对眼前的一次实现做推断,误差评估却要对"如果重抽会怎样"负责。三个术语严格化:
- 总体:研究对象的全体取值分布 F(x; θ),θ 是未知参数——要推断的目标
- 样本:X₁,…,Xₙ 独立同分布取自总体(简单随机样本)
- 统计量:样本的函数 T(X₁,…,Xₙ) 且不含未知参数——例如样本均值 X̄、样本方差 S²
统计量仍是随机变量:换一批样本它就换一个值。它的分布叫抽样分布,是评估"这个统计量当参数代表靠不靠谱"的依据。5.1 节已算过最重要的两条:E(X̄)=μ、Var(X̄)=σ²/n。样本方差注意分母是 n−1(无偏校正,下节讲为什么),S² = (1/(n−1))Σ(Xᵢ−X̄)²。
三大抽样分布:定义式与来历
正态总体 N(0,1) 假设下,三大分布各从一个自然组合中诞生:
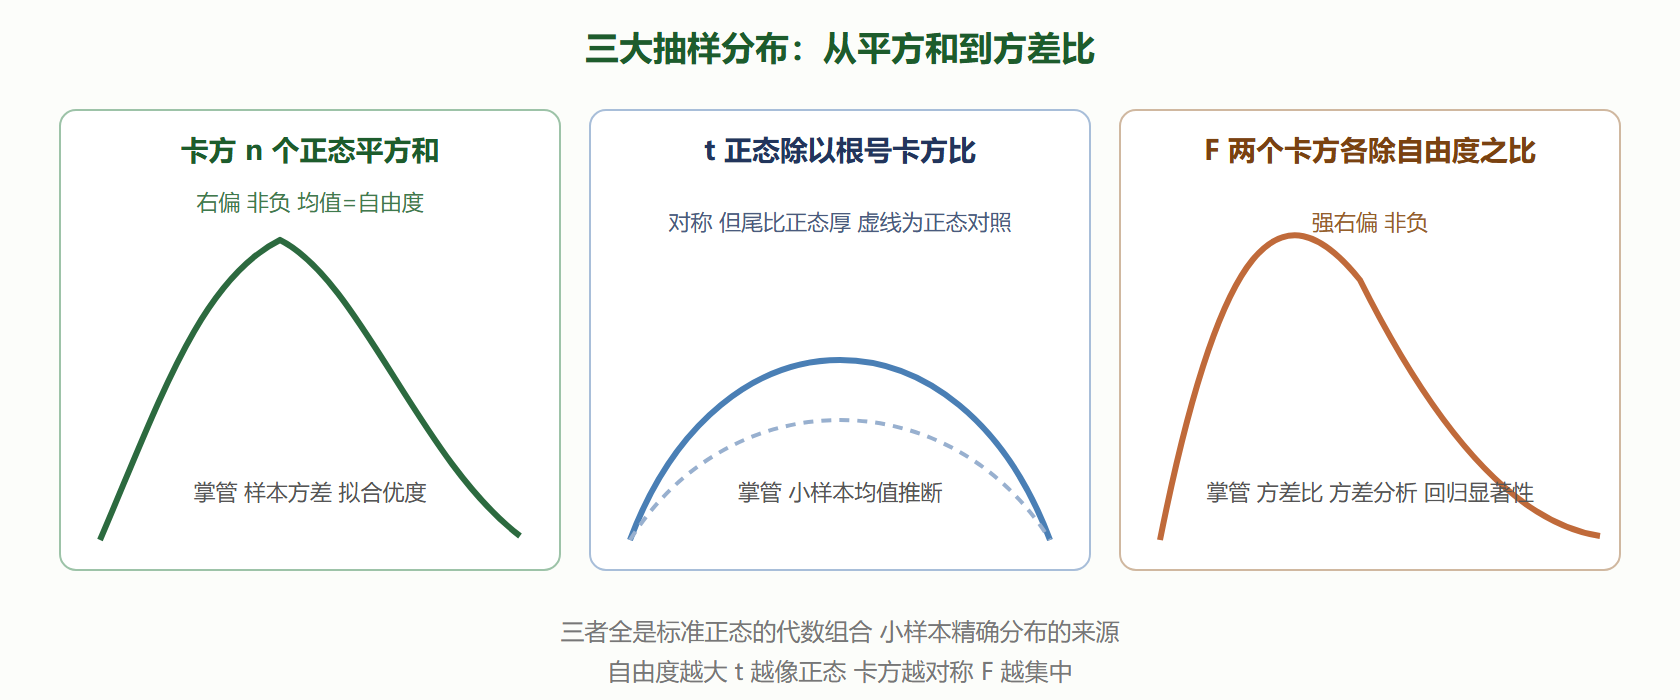
- 卡方 χ²(n):n 个独立标准正态的平方和。掌管"平方型波动"——样本方差、拟合优度
- t(n):Z 除以 √(V/n),Z 标准 正态、V 卡方 n 且独立。掌管"用 S 代替 σ 后的均值推断"——小样本区间与检验的主力
- F(m,n):两个独立卡方各除以自由度之比。掌管"两个方差之比"——方差分析、回归整体显著性
它们不是凭空规定,而是三个组合式的精确分布——CLT 只给近似,三大分布给的是小样本下分毫不差的答案,这是它们统治抽样理论一百年的资本:
import numpy as np rng = np.random.default_rng(10) n, trials = 5, 500_000 # 卡方:5 个标准正态平方和 chi2_sim = (rng.normal(0, 1, (trials, n))**2).sum(axis=1) # t:Z / sqrt(V/n) z = rng.normal(0, 1, trials) v = (rng.normal(0, 1, (trials, n))**2).sum(axis=1) t_sim = z / np.sqrt(v / n) # F:两个独立卡方各除自由度 v2 = (rng.normal(0, 1, (trials, 3))**2).sum(axis=1) f_sim = (v / n) / (v2 / 3) from scipy import stats for name, sim, dist in [ ("卡方5", chi2_sim, stats.chi2(5)), ("t5", t_sim, stats.t(5)), ("F5,3", f_sim, stats.f(5, 3))]: q_sim = [np.quantile(sim, q) for q in (0.05, 0.5, 0.95)] q_the = dist.ppf([0.05, 0.5, 0.95]) print(f"{name}: 模拟分位 {np.round(q_sim,3)} 理论 {np.round(q_the,3)}")
三组模拟分位数与理论分位数对齐到三位小数——定义式即模拟生成器,这是三大分布最亲切的入门方式。形状直觉:卡方右偏(非负、均值=自由度);t 比正态厚尾(尾部更沉,自由度越大越接近正态);F 强右偏非负。
关键定理:正态总体下 X̄ 与 S² 的精确分布
设总体 N(μ,σ²),两条结论支撑后面两章:
- (n−1)S²/σ² ~ χ²(n−1)——样本方差缩放后精确服从卡方
- (X̄−μ)/(S/√n) ~ t(n−1)——标准化时用 S 顶替 σ,代价是正态变 t(尾部加厚补偿了估计 σ 的不确定性)
import numpy as np from scipy import stats rng = np.random.default_rng(30) n, trials = 16, 100_000 mu, sigma = 5.0, 2.0 xs = rng.normal(mu, sigma, (trials, n)) xbar, s2 = xs.mean(axis=1), xs.var(axis=1, ddof=1) # 定理1:(n-1)S²/σ² 应服从卡方 n-1 w = (n-1)*s2/sigma**2 print("卡方检验量 均值 %.2f (理论 %d)" % (w.mean(), n-1)) print("0.95分位 模拟 %.2f 理论 %.2f" % (np.quantile(w, .95), stats.chi2.ppf(.95, n-1))) # 定理2:t 统计量应服从 t n-1 t = (xbar - mu)/(np.sqrt(s2)/n**0.5) print("t检验量 |值|>2 占比 %.4f 理论 %.4f" % ((abs(t) > 2).mean(), 2*stats.t.sf(2, n-1)))
两条定理的分布断言都被模拟精确复现。注意一个细节:X̄ 与 S² 在正态总体下相互独立(本赛非显然,是正态分布的特权),t 分布能成立依赖这一点。非正态总体时定理 1、2 都只是近似,CLT 兜底 n 大时的均值推断。
图 6-1 三大抽样分布形状速览
本节要点回顾
- 样本在抽取前是随机向量:推断对一次实现负责、误差对重复抽样负责
- 统计量不含未知参数,自身有抽样分布——推断的弹药库
- 样本方差分母 n−1 是无偏校正,下一节给出完整理由
- **卡方=正态平方和;t=正态除根号卡方比;F=两个卡方比**,定义式即生成器
- 正态总体特权:(n−1)S²/σ² 精确卡方、t 统计量精确 t 分布、X̄ 与 S² 独立
- 非正态只有近似,n 大时 CLT 兜底均值推断