6.2 点估计的评判标准与矩估计法
6.2 点估计的评判标准与矩估计法
本节摘要:同一个参数可以有无穷多个估计量,评比靠三把尺——无偏性(期望等于真值)、有效性(方差更小)、一致性(样本增大收敛到真值)。矩估计法"用样本矩对齐总体矩"解出参数,是最古老而通用的估计法。本节推导样本方差除以 n−1 的无偏校正式,并用模拟直观展示有偏 vs 无偏、有效 vs 低效。
三把尺:先定标准再谈方法
参数 θ 的估计量 θ̂ 是统计量,评比标准按"你更在乎什么"分层:
- 无偏性:E(θ̂) = θ。估计量长期平均不系统跑偏——但单次仍可能偏很远,无偏只是及格线
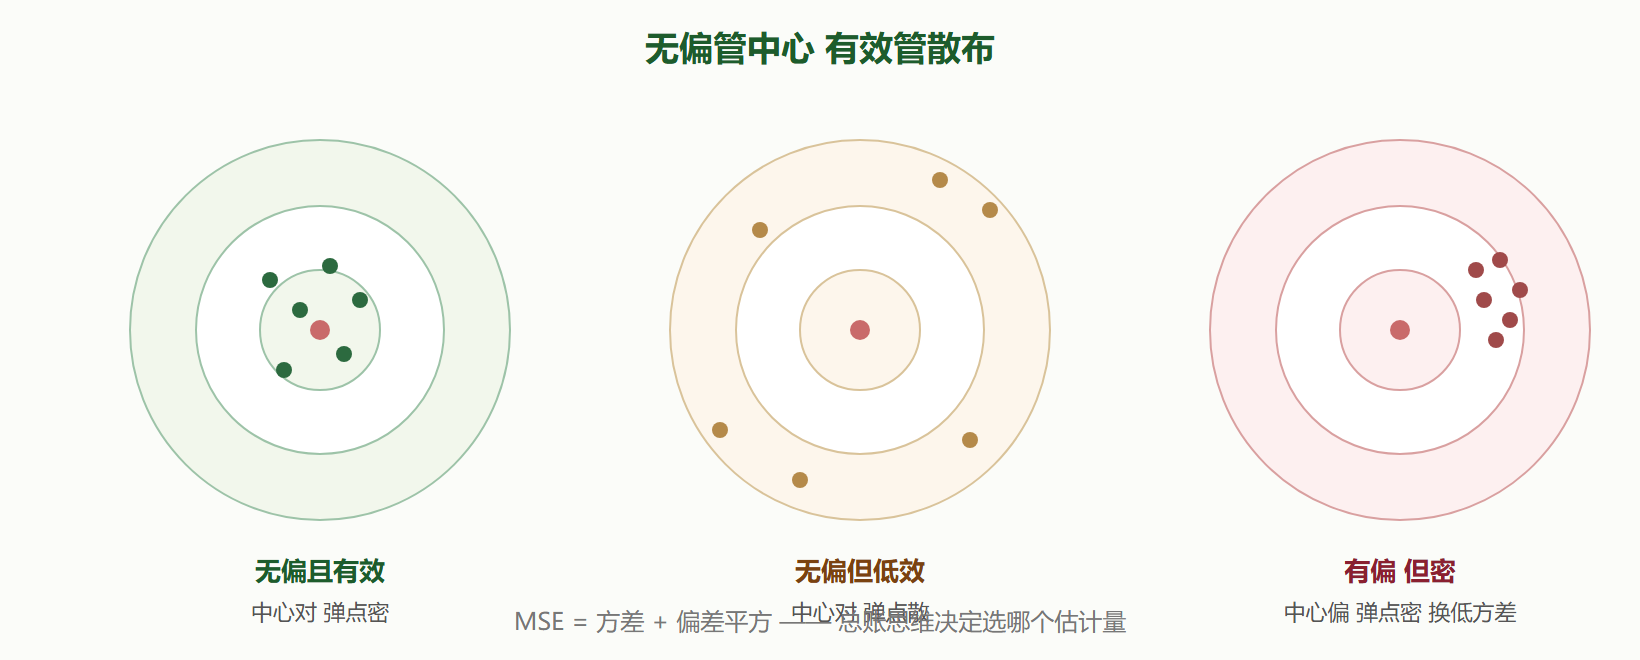
- 有效性:两个无偏估计里方差小者更有效。"射击靶心"意象:无偏是平均在靶心,有效是弹着点密集
- 一致性:n→∞ 时 θ̂ 依概率收敛 θ。样本越多越准——做不到一致的估计量原则上不该用
三尺不完全兼容:有时轻微有偏能换大幅降方差(岭回归、收缩估计的立足点),工程上常用均方误差 MSE = Var + 偏差² 做总账。把"无偏"当信仰、把"MSE 最小"当目标的分野,是统计方法论的一条主线。
样本方差为什么除以 n−1
用 X̄ 代替 μ 计算离差时,Σ(Xᵢ−X̄)² 比 Σ(Xᵢ−μ)² 系统性偏小——数据点天然围绕自己的均值更紧(X̄ 是让该平方和最小的数,一条极值论证:对 c 求导,最小值恰在 c=X̄)。精确关系:E[Σ(Xᵢ−X̄)²] = (n−1)σ²,除以 n−1 恰好把缺口补齐:
import numpy as np rng = np.random.default_rng(6) n, trials = 5, 200_000 sigma2 = 4.0 xs = rng.normal(0, np.sqrt(sigma2), (trials, n)) s2_n = xs.var(axis=1, ddof=0) # 除以 n s2_n1 = xs.var(axis=1, ddof=1) # 除以 n-1 print(f"除以 n 的均值 {s2_n.mean():.4f} 理论 {sigma2*(n-1)/n:.4f} 有偏") print(f"除以 n-1 的均值 {s2_n1.mean():.4f} 理论 {sigma2:.4f} 无偏")
模拟显示除 n 版本平均 3.2(系统性低估 20%),除 n−1 版本平均 4.0。n 大时两者趋同(这解释了为什么有的软件默认除 n——机器学习里常不在乎这一点偏差),但小样本必须校正。
矩估计:最古老的通用解法
卡尔·皮尔逊 1894 年提出的思想朴素到只有一句话:样本矩是总体矩的好估计(大数定律保证),于是让总体矩的表达式等于样本矩,解出参数。总体 k 阶矩 μₖ = E(Xᵏ),样本 k 阶矩 Aₖ = (1/n)ΣXᵢᵏ。有几个未知参数就列几个矩方程。
例一:均匀分布 U(0,θ) 的矩估计
EX = θ/2,令 X̄ = θ̂/2 得 θ̂ = 2X̄。直觉清楚:均值翻倍估上限。
例二:伽马分布 α、λ 双参数
EX = α/λ,Var = α/λ²。令样本均值、样本方差分别对齐,解得 λ̂ = X̄/S²,α̂ = X̄²/S²。两个矩方程解两个参数,代数即止。
import numpy as np rng = np.random.default_rng(21) alpha_true, lam_true = 3.0, 2.0 for n in [10, 100, 10_000]: x = rng.gamma(alpha_true, 1/lam_true, n) m, v = x.mean(), x.var(ddof=1) lam_hat, alpha_hat = m/v, m*m/v print(f"n={n:6d} alpha估计 {alpha_hat:6.3f} (真值3) " f"lambda估计 {lam_hat:.3f} (真值2)")
n 从 10 到 10 万,估计从粗糙波动收敛到贴住真值——一致性肉眼可见。矩估计的优点:几乎总能算(只需求矩)、不要求分布形式完全已知;缺点:可能低效(没有用全分布信息)、对高阶矩敏感(偏态大时样本三阶矩抖得厉害)、多参数时方程组可能难解。
有效性的模拟对比
两个无偏估计比方差。估计总体均值:候选一是样本均值 X̄;候选二是"最小值加最大值除二"(中点统计量,对均匀总体也无偏)。看谁弹着更密:
import numpy as np rng = np.random.default_rng(66) n, trials = 10, 100_000 xs = rng.uniform(0, 10, (trials, n)) est1 = xs.mean(axis=1) est2 = (xs.min(axis=1) + xs.max(axis=1)) / 2 for name, e in [("样本均值", est1), ("中点统计量", est2)]: print(f"{name}: 均值 {e.mean():.4f} 方差 {e.var():.4f}") print("均匀总体方差 100/12 = %.3f, X̄ 理论方差 %.4f" % (100/12, 100/12/n))
对均匀总体,中点的方差显著小于样本均值(理论上约为其 1/(2(n+2)) 倍量级)——同为无偏,效率可以差数倍,有效性这把尺不是摆设。这也提醒:X̄ 并非一切场景的最优,只是正态总体下的金牌(下章 MLE 视角再证)。
图 6-2 无偏与有效:靶面意象
⚠️ 常见坑:把"无偏"当成估计好的充分条件。单次实现仍可能离真值很远;比较两个无偏估计必须再看方差;明知有偏但 MSE 更小的收缩估计在预测问题里常常更实用。
矩估计的一个失败现场
矩估计不是永远可用。柯西分布(对称钟形但厚尾)的各阶矩都不存在,矩方程根本列不出来;更隐蔽的是"矩存在但样本高阶矩极不稳定"的情形——用三阶矩估计偏态参数时,一个极端离群值就能把估计拖到荒谬的位置。对照演示:
import numpy as np rng = np.random.default_rng(404) n = 200 # 帕累托尾部 alpha=2.5: 均值存在 但方差不存在 a = 2.5 x = (rng.pareto(a, n) + 1) * 10 m1, m2 = x.mean(), (x**2).mean() print("样本均值 %.2f (理论 %.2f)" % (m1, 10*a/(a-1))) print("样本二阶矩 %.0f —— 理论无穷 每次估计剧烈漂移") for seed in [1, 2, 3]: xr = (np.random.default_rng(seed).pareto(a, n) + 1) * 10 print(f" seed={seed} 二阶矩估计 {(xr**2).mean():.0f}")
三次"重复实验"的二阶矩估计相差数倍——用不稳定的统计量做估计,等于把地基打在流沙上。遇到厚尾数据,先查矩的存在性(7.3 节的偏度峰度、分位数都是诊断线索),再决定用矩法还是换 MLE/分位数方法。
本节要点回顾
- 三把尺:无偏管中心、有效管散布、一致管长期;总账是 MSE=方差+偏差²
- 样本方差除 n−1 源于"数据围绕自己均值天然更紧"的确定性缺口
- 矩估计:样本矩对齐总体矩解参数,皮尔逊 1894,万能但低效
- 一致性可被模拟直接观察:n 增大估计值收敛路径
- 同为无偏效率差数倍:均匀总体的中点估计完胜样本均值——最优估计依赖总体形状