6.3 极大似然估计与克拉美-罗下界
6.3 极大似然估计与克拉美-罗下界
本节摘要:极大似然估计(MLE)选取"让已见数据出现概率最大"的参数值,似然函数即联合概率视为参数的函数;对指数族求导即得闭式解,一般情形数值优化求解。MLE 具有一致性、渐近正态性与不变性三大性质,其渐近方差达到克拉美-罗下界(CRLB)——无偏估计方差的理论地板。本节完整推导两个经典案例并对照数值优化。
似然思想:反过来问"参数多像"
频率学派的转折点在问法反转:矩估计问"样本矩等于总体矩时参数是多少",MLE 问"什么样的参数最能解释眼前的数据"。似然函数 L(θ) = Πf(xᵢ;θ)(样本在候选参数 θ 下出现的联合概率),MLE 就是让 L 最大的 θ̂。直觉:掷硬币 10 次见 7 正面,p=0.7 让这份数据出现的可能性最大——不是"正面向上的概率一定是 0.7",而是"0.7 是对这份数据最尽力的解释"。惯例取对数化乘为加(数值稳定):ℓ(θ)=Σln f(xᵢ;θ),最大化 ℓ 等价于最大化 L。
案例一:指数分布的 MLE(闭式推导)
总体 Exp(λ),密度 λe^(−λx)。对数似然 ℓ(λ) = n·ln λ − λ·Σxᵢ。求导置零:n/λ − Σxᵢ = 0,解得 λ̂ = n/Σxᵢ = 1/X̄——样本均值的倒数。同样的"MLE=矩估计"巧合也出现在泊松(λ̂=X̄)与正态(μ̂=X̄、σ̂²=Σ(xᵢ−X̄)²/n,注意分母是 n,MLE 版方差有偏)。
案例二:均匀 U(0,θ)——MLE 与矩估计分道扬镳
似然 L(θ) = θ^(−n)(只要 θ ≥ max xᵢ),是 θ 的减函数,在最小允许值 θ̂ = max(xᵢ) 处最大。矩估计给 2X̄,MLE 给样本最大值——MLE 在这里给出了完全不同(且更合理)的答案:任何小于最大观测值的 θ 都使数据不可能出现,似然直接归零。边界参数的 MLE 不服从常规渐近理论,是教科书级特例:
import numpy as np rng = np.random.default_rng(14) theta_true = 10.0 for n in [5, 50, 5000]: x = rng.uniform(0, theta_true, n) mom = 2 * x.mean() # 矩估计 mle = x.max() # MLE print(f"n={n:5d} 矩估计 {mom:6.3f} MLE {mle:6.3f} 真值 10")
MLE 系统性偏低(最大值永远够不到 θ)但随 n 快速逼近;矩估计双侧波动更大。两个估计量性格迥异,恰是"方法背后有哲学差异"的活标本。
数值优化:一般情形的 MLE
不存在闭式时(如双参数伽马、混合模型),对数似然当目标函数交给优化器。凯利一个双参数例子走通全流程:
import numpy as np from scipy import stats, optimize rng = np.random.default_rng(8) alpha_true, lam_true = 3.0, 2.0 for n in [30, 3000]: x = rng.gamma(alpha_true, 1/lam_true, n) def negll(p): a, l = p return -np.sum(stats.gamma.logpdf(x, a, scale=1/l)) res = optimize.minimize(negll, x0=[2.0, 1.0], method="Nelder-Mead") print(f"n={n:5d} alpha数值MLE {res.x[0]:.3f} lambda数值MLE {res.x[1]:.3f}") print(f"闭式矩估计对照见上一节;真值 alpha=3 lambda=2")
数值 MLE 随 n 增大收敛到真值。注意两个工程要点:似然取负号交给最小化器;初值敏感的场合(混合分布)要多起点尝试。机器学习的交叉熵损失就是负对数似然的别名——最小化交叉熵就是做 MLE,这条线把统计学与深度学习焊在一起。
三大性质与克拉美-罗下界
MLE 的三大渐近性质(正则条件下):一致性(θ̂→θ)、渐近正态(√n(θ̂−θ) → N(0, 1/I(θ)))、不变性(g(θ̂) 是 g(θ) 的 MLE——估计了 λ 就免费得到 1/λ 的估计)。其中 I(θ) 是费希尔信息,n·I(θ) 度量数据对 θ 的信息总量。克拉美-罗下界(CRLB)断言:任何无偏估计的方差满足 Var(θ̂) ≥ 1/(nI(θ))——这是无偏估计方差的理论地板,谁也造不出比它更准的无偏估计。MLE 渐近达到地板,这是它称王的法理:
import numpy as np rng = np.random.default_rng(90) # 泊松总体:I(lambda)=1/lambda,CRLB = lambda/n;X̄ 方差恰为 lambda/n —— 达到下界 lam, n, trials = 4.0, 50, 100_000 est = rng.poisson(lam, (trials, n)).mean(axis=1) print(f"泊松 MLE=X̄ 的方差 模拟 {est.var():.5f} CRLB {lam/n:.5f} 达界") # 指数总体:I(lambda)=1/lambda²,CRLB = lambda²/n;MLE=1/X̄ 方差略高于下界(非线性) lam2, n2 = 2.0, 50 est2 = 1.0 / rng.exponential(lam2, (trials, n2)).mean(axis=1) print(f"指数 MLE=1/X̄ 的方差 模拟 {est2.var():.5f} CRLB {lam2**2/n2:.5f} 略高(有限n)") print(f"指数 MLE 偏差 模拟 {est2.mean()-lam2:+.4f} n增大趋零(一致性)")
泊松的 X̄ 精确达到 CRLB(它是稀有分布族的幸运特权);指数的 1/X̄ 在有限 n 时略高于下界且轻微有偏,n 增大渐近贴界——"渐近有效"四字的实验含义。
图 6-3 似然函数形状与 MLE 定位
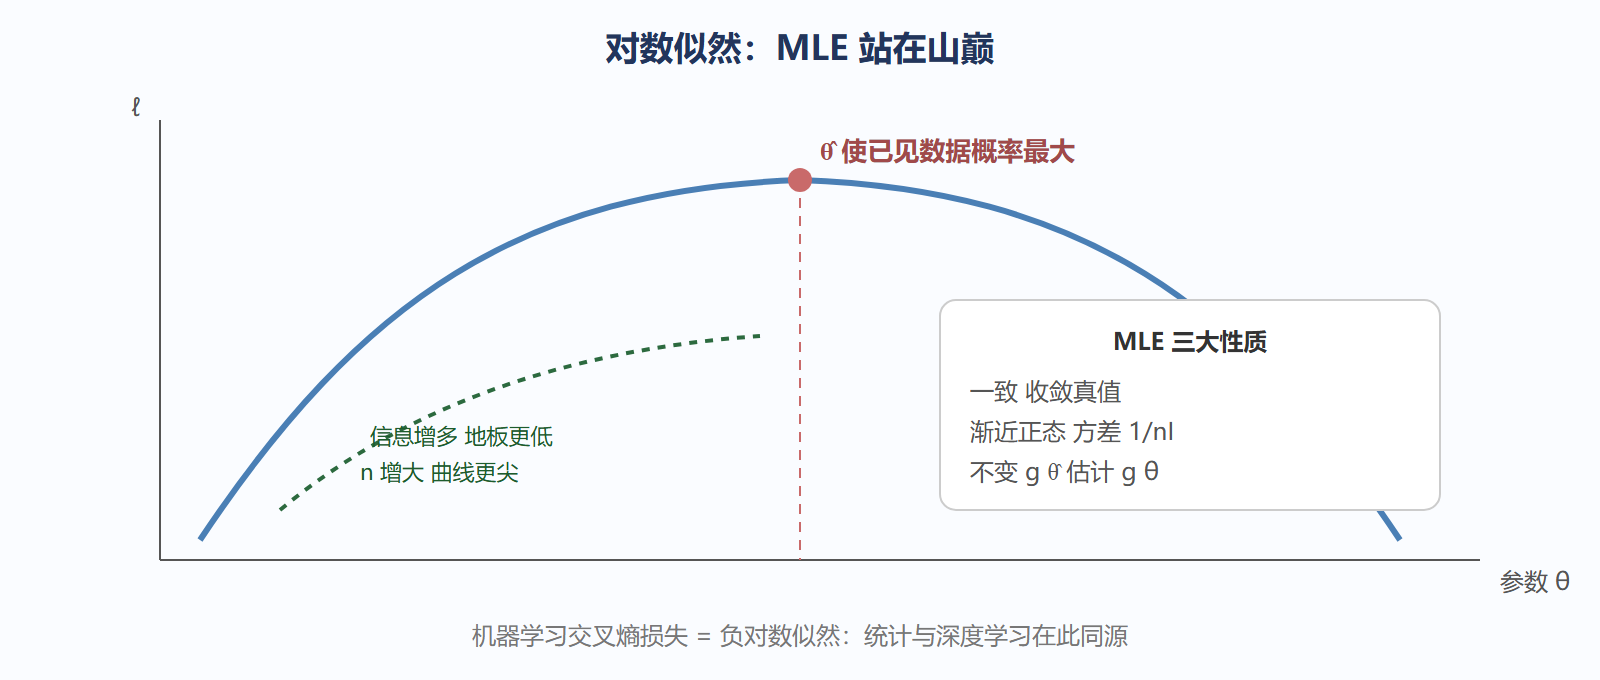
💡 关键直觉:似然不是概率——它不是 θ 的分布,只是"数据固定时参数的得分函数"。把似然曲线当 θ 的 posterior 是频率派/贝叶斯派最常打架的混淆点。
本节要点回顾
- MLE 最大化已见数据的出现概率:对数化乘为加,闭式或数值求解
- 指数/泊松/正态的 MLE 与矩估计重合;均匀 U(0,θ) 上两者分道,MLE 取样本最大值
- 三大性质:一致、渐近正态(方差 1/nI)、不变性——g(θ̂) 免费
- CRLB 是无偏方差的理论地板 1/(nI);泊松的 X̄ 精确达界,MLE 渐近达界
- 交叉熵=负对数似然:MLE 视角统一统计推断与机器学习训练
- 似然不是参数的概率:得分函数,不是 posterior