7.1 置信区间的构造:大样本与小样本
7.1 置信区间的构造:大样本与小样本
本节摘要:置信区间通过枢轴量法构造——找一个含未知参数但分布已知(或近似已知)的统计量,反解出参数的随机区间。95% 修饰的是方法的长期覆盖率而非参数的概率。本节走通三类模板:σ 已知的 z 区间、σ 未知的 t 区间、大样本比例的 Wald 区间,并用蒙特卡洛直接测覆盖率。
一个数不诚实,一条区间才诚实
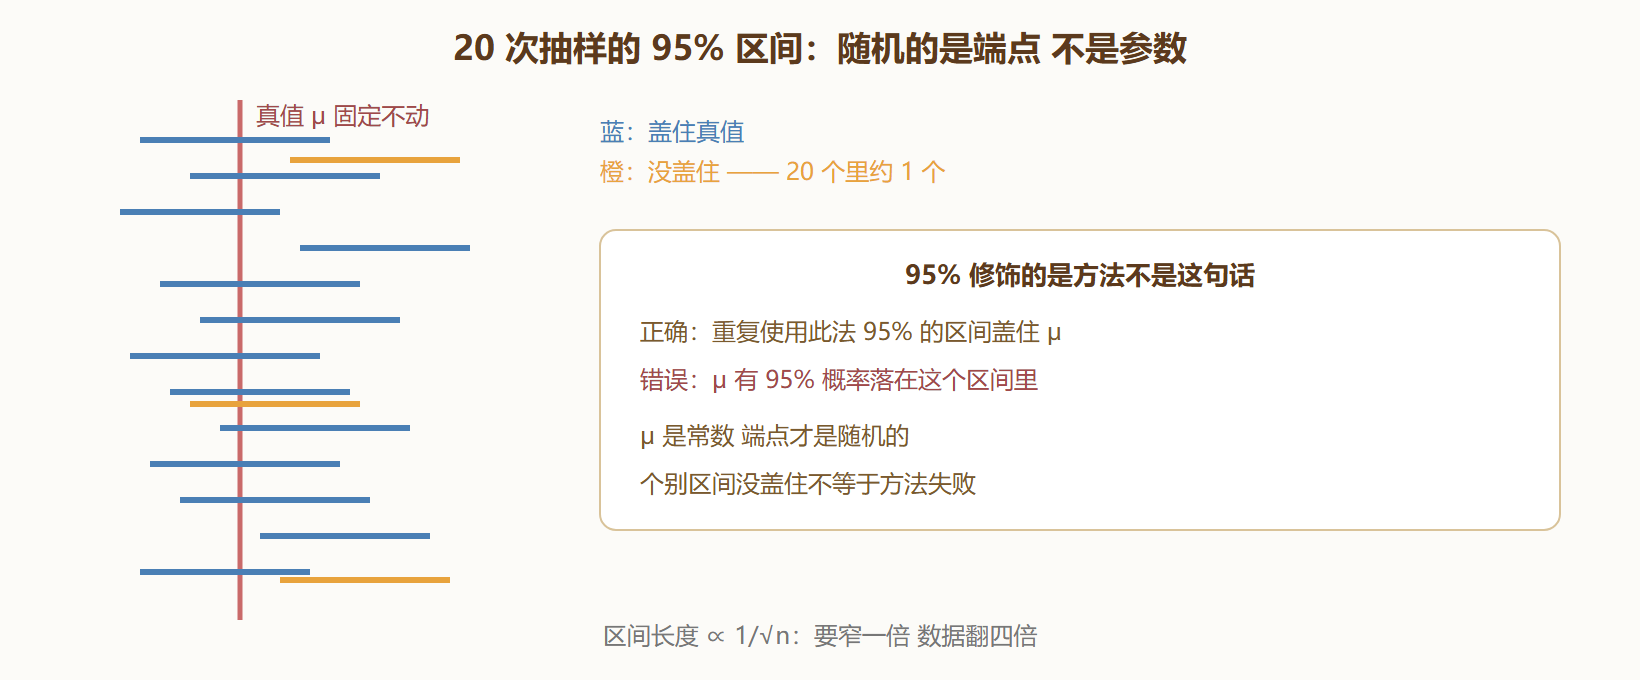
第 6 章估计 λ̂=2.03,真正的推断必须回答"可能是 2.0 吗?1.8 呢?"置信区间把这层不确定挂成误差条。95% 置信区间的准确读法:构造方法在重复使用中,约 95% 的区间会盖住真参数——95% 修饰的是方法(随机的是区间端点),不是"参数有 95% 概率落在这个区间"(参数不是随机的,频率派框架里它是固定常数)。这个措辞差异不是学究气:它决定了你能否正确理解"这次实验的区间没盖住 0"这类事件。
枢轴量法:唯一的通用套路
构造区间的标准姿势三步:找枢轴量(含 θ 但其分布不依赖 θ 的统计量)→ 写出概率陈述 P(下界 ≤ 枢轴量 ≤ 上界)=0.95 → 不等式变形反解出 θ 的区间。三个模板一张表:
| 场景 | 枢轴量 | 分布 | 区间中心 ± 半径 |
|---|---|---|---|
| 正态,σ 已知 | (X̄−μ)/(σ/√n) | N(0,1) | X̄ ± z·σ/√n |
| 正态,σ 未知 | (X̄−μ)/(S/√n) | t(n−1) | X̄ ± t·S/√n |
| 大样本比例 | (p̂−p)/√(p(1−p)/n) | ≈N(0,1) | p̂ ± z·√(p̂(1−p̂)/n) |
σ 未知时用 S 顶替 σ 的代价由 t 分布支付(尾部更厚、区间更长),n 大时 t→z 两者合流。手算一遍再交给 statsmodels 对照:
import numpy as np from scipy import stats x = np.array([51.2, 48.7, 50.9, 49.5, 52.3, 50.1, 48.9, 51.6, 49.8, 50.4]) n, xbar, s = len(x), x.mean(), x.std(ddof=1) tcrit = stats.t.ppf(0.975, n-1) lo, hi = xbar - tcrit*s/n**0.5, xbar + tcrit*s/n**0.5 print(f"手算 95% t 区间: [{lo:.3f}, {hi:.3f}] (x̄={xbar:.3f}, S={s:.3f})") # statsmodels 交叉验证 import statsmodels.stats.api as sms ci = sms.DescrStatsW(x).tconfint_mean(alpha=0.05) print(f"statsmodels 区间: [{ci[0]:.3f}, {ci[1]:.3f}]")
两法输出一致。解读:若工艺标准是 50.0,区间盖住 50.0——"这批产品均值偏离 50"的证据不足(下一节的检验会给出同一结论的对偶表述)。
覆盖率:方法的体检指标
置信水平是承诺,覆盖率是实测。模拟 20_000 次抽样,数"区间盖住真值"的比例:
import numpy as np from scipy import stats rng = np.random.default_rng(50) mu, sigma, n, reps = 10.0, 2.0, 12, 20_000 tcrit = stats.t.ppf(0.975, n-1) xs = rng.normal(mu, sigma, (reps, n)) xbars, ses = xs.mean(axis=1), xs.std(axis=1, ddof=1)/n**0.5 cover_t = ((xbars - tcrit*ses <= mu) & (mu <= xbars + tcrit*ses)).mean() # 故意用 z 代替 t:看错用分布的惩罚 zcrit = stats.norm.ppf(0.975) cover_z = ((xbars - zcrit*ses <= mu) & (mu <= xbars + zcrit*ses)).mean() print(f"t 区间覆盖率 {cover_t:.4f} 名义 0.950") print(f"错用 z 的覆盖率 {cover_z:.4f} n=12 时实际只有约 0.927")
t 区间覆盖率贴住 95%;小样本错用 z 区间,覆盖率掉到 92% 附近——不是灾难但足够让"95% 的承诺"变成空头支票。n 增大惩罚消失(t 收敛 z),这就是"大样本随便用 z"的合理内核。
比例的置信区间:A/B 测试的误差条
新按钮点击率 p̂ = 120/1000 = 0.12。Wald 区间 0.12 ± 1.96√(0.12×0.88/1000) ≈ [0.100, 0.140]。Wald 区间在 p 靠近 0 或 1 时覆盖率崩坏(小 p 的尾部被截断),实务建议 Wilson 区间:
import statsmodels.stats.proportion as smp k, n = 120, 1000 ci_wald = smp.proportion_confint(k, n, alpha=0.05, method="normal") ci_wils = smp.proportion_confint(k, n, alpha=0.05, method="wilson") print(f"Wald 区间 [{ci_wald[0]:.4f}, {ci_wald[1]:.4f}]") print(f"Wilson 区间 [{ci_wils[0]:.4f}, {ci_wils[1]:.4f}]") # 极端比例下两者分歧拉大 ci_wald2 = smp.proportion_confint(2, 50, alpha=0.05, method="normal") ci_wils2 = smp.proportion_confint(2, 50, alpha=0.05, method="wilson") print(f"2/50 Wald [{ci_wald2[0]:.4f},{ci_wald2[1]:.4f}] " f"Wilson [{ci_wils2[0]:.4f},{ci_wils2[1]:.4f}]") # Wald 下限可为负
2/50 的 Wald 下限穿到负值——概率为负的区间显然荒唐;Wilson 区间始终待在 [0,1] 内且覆盖率更准。报表里的比例区间一律用 Wilson,是数据分析的卫生习惯。
图 7-1 置信区间的重复抽样意象:95% 的区间盖住靶心
区间宽度与样本量的交易
区间半径 = 临界值 × 标准误 = t·S/√n。宽度按 1/√n 收缩:精度翻倍要数据翻四倍——与 5.1 节的结论同一条根。反向操作即样本量设计:给定目标半宽 h 与置信水平,n ≈ (zσ/h)²。制药与民调的预算问题都是这条公式。
本节要点回顾
- 95% 修饰方法的长期覆盖率,参数固定、区间随机——读法错误是最高频事故
- 枢轴量法是唯一套路:找枢轴量、写概率陈述、反解区间
- σ 未知用 t 区间:小样本错用 z 覆盖率掉约 2–3 个百分点
- 比例区间用 Wilson:Wald 在极端比例处覆盖率崩坏甚至穿负
- 覆盖率模拟是检验区间方法的金标准:承诺 95% 就实测 95%
- 宽度按 1/√n 收缩:精度用四倍数据买两倍