7.2 假设检验的逻辑与两类错误
7.2 假设检验的逻辑与两类错误
本节摘要:假设检验是带风险控制的证伪程序——原假设 H₀ 放"无差异/无效应",数据落在原假设下足够罕见的区域就拒绝它。第一类错误 α(冤枉好人)、第二类错误 β(放过坏人)与功效 1−β 构成决策三角。p 值是"H₀ 为真时见到当前或更极端数据的概率",不是"H₀ 为真的概率"。本节用审判类比 + 完整模拟把这套逻辑走透。
无罪推定的统计学版本
法庭审判:被告默认无罪(原假设 H₀),只有当证据"排除合理怀疑"才定罪(拒绝 H₀)。检验的五要素照着写:
- 假设:H₀: μ = μ₀(无罪)vs H₁: μ ≠ μ₀(有罪,双侧)
- 检验统计量:t = (X̄−μ₀)/(S/√n)——度量"数据偏离无罪假设多少个标准误"
- 零分布:H₀ 为真时 t ~ t(n−1)——裁决的尺子
- 拒绝域:|t| > t 临界值,等价于 p < α——证据罕见的量化标准
- 结论:拒绝 H₀(证据足以定罪)或不拒绝(证据不足,不等于证明无罪)
注意不对称性:统计检验只能证伪式地拒绝,永远不能"接受"H₀。"不拒绝"说的是证据不够,不是 H₀ 为真——这与科学哲学的证伪逻辑同构。原假设的选取原则:把"想强证明的结论"放在备择侧,让举证责任落在数据身上(新药有效、广告有提升)。
p 值:最被误读的数字
p 值 = H₀ 为真时,出现当前或更极端数据的概率。它向前看(数据在假设下的可能性),不是向后看(假设在数据下的可能性)。三条经典误读对照正解:
- 误读一:"p=0.03 说明 H₀ 有 3% 的概率为真"——错,p 值是条件概率 P(数据|H₀),不是 P(H₀|数据),后者要贝叶斯先验才能算(第 1 章体检阳性的同款结构:1.3 节里"患病率 1%、阳性"与"阳性、患病率"的差别)
- 误读二:"p=0.20 说明两组无差异"——错,只是没收集到足够证据,"无差异"需要等效性检验另证
- 误读三:"p=0.04 比 p=0.06 的证据强一倍"——错,p 值不是效应强度,大小还受 n 支配(n 翻倍同一效应的 p 可以从 0.06 跳到 0.002)
import numpy as np from scipy import stats rng = np.random.default_rng(3) # 同一效应量(0.3个标准差)在不同 n 下的 p 值:p 会被样本量购买 for n in [30, 100, 1000, 10000]: x = rng.normal(0.3, 1, n) t, p = stats.ttest_1samp(x, 0) print(f"n={n:6d} 效应量同 0.3 t={t:6.2f} p={p:.2e}")
同一效应,p 从 0.1 量级滑到 10⁻⁷ 量级——巨大样本里微不足道的差异也能"高度显著"。报告效应量与置信区间,永远和 p 值一起出场。
两类错误与功效:决策的账本
| H₀ 真(无辜) | H₁ 真(有罪) | |
|---|---|---|
| 拒绝 H₀ | 第一类错误 α(冤枉)概率 | 正确,功效 1−β |
| 不拒绝 | 正确 | 第二类错误 β(放过) |
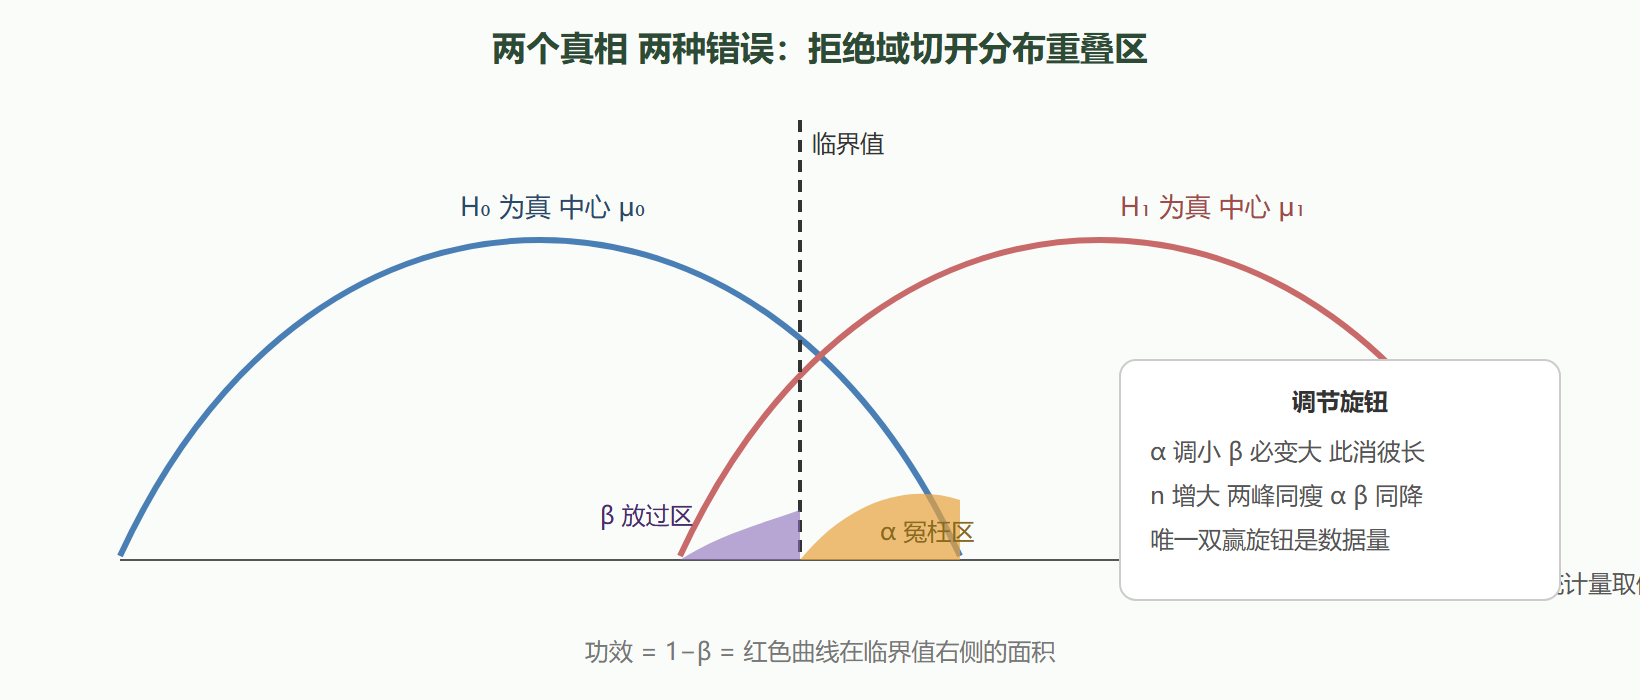
α 在检验前设定(0.05 或 0.01,行业惯例),β 由 α、效应量、n 共同决定。n 是唯一可自由调节的量——功效分析(power analysis)用公式或模拟倒推"要查出效应 δ 至少需要多大样本":
import numpy as np from scipy import stats import statsmodels.stats.power as smp # 解析功效:单样本 t 双侧 α=0.05 效应量 0.5 求样本量 analysis = smp.TTestPower() n_need = analysis.solve_power(effect_size=0.5, alpha=0.05, power=0.8) print(f"效应0.5 功效80% 所需样本量 {n_need:.1f}") # 模拟功效:n=40 时真效应0.5 被检出的频率 rng = np.random.default_rng(17) reps, n = 5000, 40 detected = 0 for _ in range(reps): x = rng.normal(0.5, 1, n) _, p = stats.ttest_1samp(x, 0) detected += (p < 0.05) print(f"n=40 模拟功效 {detected/reps:.3f} 解析 {analysis.power(0.5, n, 0.05):.3f}")
模拟功效与解析功效对齐(约 0.85)。功效 0.8 的含义:真实效应存在时,五次实验约有一次错过它——"不显著"在低功效实验里几乎不提供信息,小样本阴性结果被媒体放大成"某疗法无效"是公共卫生新闻的老病。
图 7-2 两类错误的分布重叠图
多重比较:p 值的规模化失灵
做 20 次独立检验,全无真效应,至少一次 p<0.05 的概率 = 1−0.95²⁰ ≈ 64%——"试 20 个指标总有一个显著"是必然事件而非发现。A/B 测试盯多个指标、基因扫描数千位点都踩此坑。对策:Bonferroni 校验(α/检验次数,保守)或 Holm 逐步法(稍宽松),statsmodels 一行调用:
from statsmodels.stats.multitest import multipletests pvals = [0.011, 0.048, 0.038, 0.002, 0.07] for method in ["bonferroni", "holm"]: rej, p_adj, _, _ = multipletests(pvals, alpha=0.05, method=method) print(method, "调整后 p:", np.round(p_adj, 4), "拒绝:", rej)
原 p 值 0.048、0.038 校正后都不再显著——先定假设再检验与"先看数据再挑假设"得出的是两种科学,后者必须为窥视数据付出校正代价。
本节要点回顾
- 检验是证伪程序:拒绝或不拒绝,永不说"接受 H₀"
- 原假设承载无罪推定:想强证明的结论放备择侧
- p 值 = P(数据或更极端 | H₀):不是 H₀ 为真的概率、不是效应强度、被 n 支配
- α 与 β 此消彼长,n 是唯一双赢旋钮:功效分析先于数据收集
- 低功效的阴性结果几乎无信息:报告功效是诚实推断的一部分
- 多重比较必然产出假显著:Bonferroni/Holm 校正或预注册假设